Santé numérique et IABiais cognitifs et erreur diagnostiqueRaisonnement clinique
IA en dermatologie : moins performante sur peau foncée
Sommaire
- Pourquoi l'IA dermatologique est devenue une promesse et un risque
- Ce que Diverse Dermatology Images a mesuré
- Transparence des ensembles de données
- Ajustement fin et ce qui change avec des données diverses
- Checklist CLEAR Derm et ce qu'il faut demander au fournisseur
- Ce qui change dans la décision clinique
- Études en résumé
- Comment NEXO aide à entraîner ce raisonnement
- Questions fréquentes
- Messages à retenir
- Références
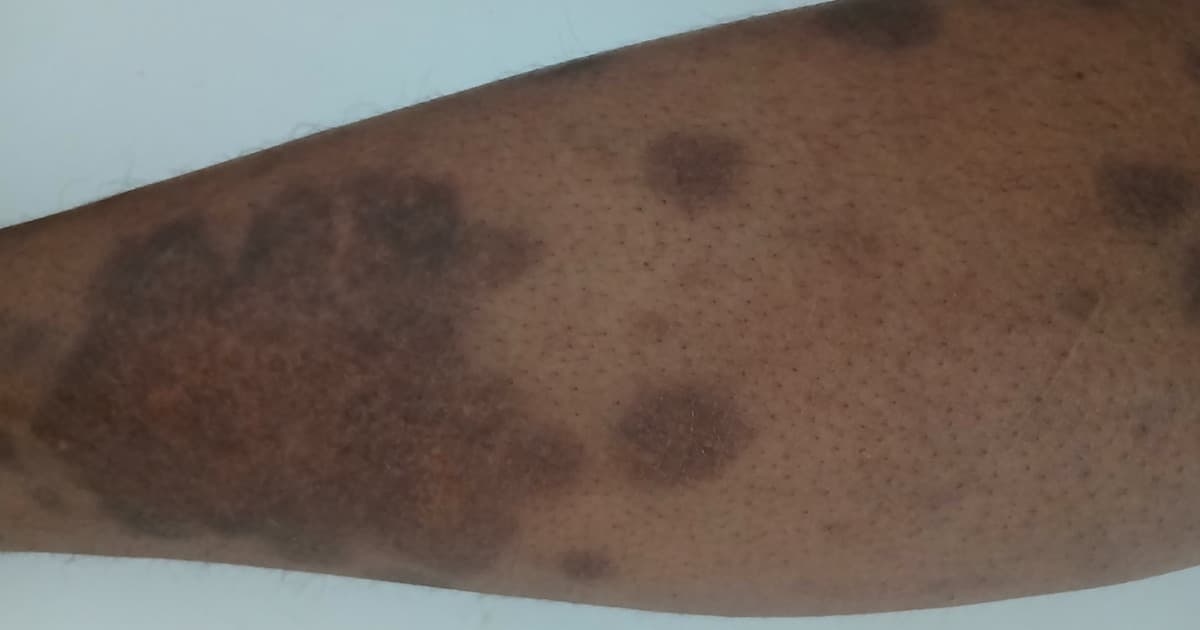
Dans un cabinet fictif de dermatologie, une clinique teste une application qui classe des photos de lésions en bénignes ou malignes. L'algorithme réussit souvent sur les images claires de la banque de démonstration. La même semaine, trois patients à la peau foncée apportent des photos de taches et de nodules : l'application renvoie des scores de confiance faibles ou suggère la bénignité pour des lésions que le dermatologue juge suspectes. L'équipe se demande si le problème vient de la photo, de l'appareil ou du modèle.
Ce scénario résume ce que des études récentes ont mesuré : les classificateurs d'images cutanées, entraînés sur des banques peu diverses, perdent en performance sur les tons foncés et sur les maladies moins courantes. Ce texte rassemble ce que la littérature montre sur cette baisse, pourquoi les jeux de données échouent en transparence et ce que le clinicien peut demander avant de faire confiance au résultat. Dans chaque partie, le texte précise le plan et la taille des études et sépare ce qui a été mesuré de ce qui relève de notre inférence.
Points principaux
- Dans le jeu Diverse Dermatology Images, trois algorithmes de pointe ont eu une aire sous la courbe ROC entre 0,56 et 0,67, bien en dessous des performances rapportées dans leurs propres tests (Daneshjou et al., 2022).
- La sensibilité a chuté nettement pour les phototypes Fitzpatrick V-VI : ModelDerm de 0,41 à 0,12 et DeepDerm de 0,69 à 0,23 (Daneshjou et al., 2022).
- Dans 70 études d'IA en dermatologie, seulement 24,2 pour cent des images étaient publiques, 20 pour cent décrivaient la race ou l'ethnicité et 10 pour cent citaient le phototype (Daneshjou et al., 2021).
- Un ajustement fin avec des images diverses a comblé l'écart entre tons clairs et foncés pour DeepDerm et pour le modèle entraîné sur HAM10000 (Daneshjou et al., 2022).
- Les dermatologues se sont aussi trompés davantage sur les tons foncés et sur les maladies inhabituelles, ce qui compte parce qu'ils annotent beaucoup de banques d'entraînement (Daneshjou et al., 2022).
- Pourquoi l'IA dermatologique est devenue une promesse et un risque
- Ce que Diverse Dermatology Images a mesuré
- Transparence des jeux de données
- Ajustement fin et ce qui change avec des données diverses
- Checklist CLEAR Derm et ce qu'il faut demander au fournisseur
- Ce qui change dans la décision clinique
- Études en résumé
- Comment NEXO aide à entraîner ce raisonnement
- Questions fréquentes
- Messages à retenir
Pourquoi l'IA dermatologique est devenue une promesse et un risque
La classification automatique des lésions cutanées a attiré l'attention après que des réseaux de neurones profonds ont égalé les dermatologues sur des tâches de mélanome et de carcinome dans de grandes banques (Esteva et al., 2017). L'étude de Stanford a entraîné sur 129 450 images et testé sur 2 032 images avec biopsie, avec une performance proche de celle de 21 dermatologues certifiés (Esteva et al., 2017).
Le saut de 2017 et l'alerte de 2018
Cette étape a accéléré les applications, la télédermatologie et l'espoir d'un dépistage en soins primaires. L'année suivante, Adamson et Smith ont averti que des modèles entraînés sur des données peu représentatives peuvent amplifier les disparités s'ils sont déployés sans mesurer la performance par sous-groupe (Adamson et Smith, 2018). Cet avertissement a anticipé ce que Diverse Dermatology Images (DDI) a mesuré avec des chiffres des années plus tard.
La promesse reste valable pour les lésions courantes dans des banques équilibrées, mais la question clinique n'est plus « l'algorithme a-t-il raison ? » et est devenue « sur qui a-t-il raison ? ». Ce changement de question dialogue avec l'usage de l'intelligence artificielle dans le raisonnement clinique et avec le risque de trop faire confiance à la machine.
Ce que Diverse Dermatology Images a mesuré
Le DDI a été créé pour tester des algorithmes sur des images confirmées cliniquement, avec des phototypes divers et des maladies courantes et inhabituelles (Daneshjou et al., 2022). Après exclusion des photos qui n'ont pas passé le contrôle de qualité, il est resté 656 images, équilibrées entre bénignes et malignes aux extrêmes de Fitzpatrick (Daneshjou et al., 2022).
Composition du jeu
Il y avait 208 images de Fitzpatrick I-II (159 bénignes et 49 malignes), 241 de III-IV et 207 de V-VI (159 bénignes et 48 malignes) (Daneshjou et al., 2022). Les sous-ensembles des extrêmes ont été appariés par classe diagnostique pour la comparaison entre tons clairs et foncés.
Performance des trois algorithmes
Dans le DDI complet, ModelDerm avait une aire sous la courbe ROC de 0,65 (IC à 95 pour cent de 0,61 à 0,70), DeepDerm de 0,56 (0,51 à 0,61) et le modèle entraîné sur HAM10000 de 0,67 (0,62 à 0,71) (Daneshjou et al., 2022). Sur leurs propres ensembles de test, ces algorithmes avaient atteint des valeurs bien plus élevées, ce qui montre une baisse en sortant de l'environnement d'origine.
Dans la comparaison entre Fitzpatrick I-II et V-VI, ModelDerm est passé de 0,64 (0,55 à 0,7) à 0,55 (0,46 à 0,64), DeepDerm de 0,61 (0,50 à 0,71) à 0,50 (0,41 à 0,58) et HAM10000 de 0,72 (0,63 à 0,79) à 0,57 (0,48 à 0,67) (Daneshjou et al., 2022). La sensibilité est passée de 0,41 à 0,12 pour ModelDerm et de 0,69 à 0,23 pour DeepDerm (Daneshjou et al., 2022).
Les dermatologues se trompent aussi sur peau foncée
Le DDI a demandé à trois dermatologues de classer chaque image comme processus bénin ou malin et a formé un vote majoritaire (Daneshjou et al., 2022). Les étiquettes des spécialistes surpassaient les algorithmes avant l'ajustement fin, mais la sensibilité des dermatologues a aussi baissé de 0,72 en Fitzpatrick I-II à 0,59 en V-VI (Daneshjou et al., 2022).
Le test avec 848 médecins
Groh et ses collègues ont mené une expérience numérique avec 389 dermatologues et 459 médecins de soins primaires de 39 pays, qui ont évalué 364 images de 46 maladies dans une simulation de télédermatologie (Groh et al., 2024). La précision diagnostique était de 38 pour cent chez les dermatologues et de 19 pour cent chez les généralistes, et les deux groupes étaient 4 points de pourcentage moins précis sur peau foncée (Groh et al., 2024). L'appui d'un algorithme d'apprentissage profond a augmenté la précision de plus de 33 pour cent, mais a élargi l'écart entre tons de peau chez les généralistes (Groh et al., 2024). Les auteurs concluent qu'améliorer la précision globale ne résout pas, à lui seul, le biais (Groh et al., 2024).
Pourquoi cela compte pour l'entraînement
De nombreuses bases utilisent des étiquettes de dermatologues comme vérité de référence. Si l'erreur humaine est plus grande sur les tons foncés et sur les maladies inhabituelles, l'algorithme hérite de cette faille et peut l'amplifier (Daneshjou et al., 2022). La discussion recoupe le biais implicite dans le diagnostic et la calibration de la confiance : justesse et certitude ne vont pas ensemble quand le sous-groupe change.
Une synthèse de notre part est que le dermatologue reste indispensable, mais n'est pas un étalon exempt de biais photographique ; son rôle est de filtrer l'algorithme, pas seulement d'étiqueter la base.
Transparence des ensembles de données
Avant le DDI, la revue de portée dans JAMA Dermatology a examiné 70 études d'apprentissage profond en dermatologie (Daneshjou et al., 2021). Parmi 1 065 291 images utilisées pour développer ou tester des algorithmes, seules 257 372 (24,2 pour cent) étaient disponibles publiquement (Daneshjou et al., 2021).
Ce que presque personne ne rapporte
Seules 14 études (20,0 pour cent) décrivaient l'ethnie ou la race dans au moins un ensemble, et seules 7 (10,0 pour cent) indiquaient une quelconque donnée de ton de peau (Daneshjou et al., 2021). Sans cette information, le lecteur ne peut pas savoir si le modèle a été testé dans la population où il sera utilisé.
Bases publiques et effet de réseau
Les ensembles publics étaient cités plus souvent que les privés, ce qui concentre l'entraînement sur peu de sources et sur des photographies au profil démographique semblable (Daneshjou et al., 2021). Une hypothèse de notre part est que la répétition des mêmes bases explique une partie de la baisse observée dans le DDI quand le cadre clinique change.
La revue de portée a aussi montré que la médiane d'images dans les études qui entraînaient de nouveaux algorithmes était d'environ 10 000, avec une large variation, ce qui renforce l'inégalité de ressources entre groupes de recherche (Daneshjou et al., 2021). Sans données publiques et sans description démographique, la communauté clinique ne peut ni reproduire ni auditer la performance par sous-groupe avant l'achat ou le déploiement.
Ce que contiennent les bases publiques
Wen et ses collègues ont passé en revue de façon systématique 21 banques d'images de cancer de la peau en accès libre, totalisant 106 950 images (Wen et al., 2022). Sur les 14 banques qui indiquaient le pays d'origine, 11 (79 pour cent) provenaient d'Europe, d'Amérique du Nord et d'Océanie, et 19 banques (91 pour cent) ne contenaient que des images dermatoscopiques ou macroscopiques (Wen et al., 2022). L'ethnicité était disponible pour 1 415 images (1,3 pour cent) et le phototype de Fitzpatrick pour 2 236 (2,1 pour cent) (Wen et al., 2022). Les auteurs réclament des normes de qualité pour les métadonnées des banques (Wen et al., 2022).
Cette opacité rappelle l'alerte du rapport sur l'erreur diagnostique : les systèmes qui ne mesurent pas les défaillances par sous-groupe reproduisent l'iniquité, thème du texte sur le rapport Improving Diagnosis.
Ajustement fin et ce qui change avec des données diverses
Les auteurs du DDI ont réentraîné DeepDerm et le modèle de HAM10000 avec des images diverses (Daneshjou et al., 2022). Après l'ajustement fin, DeepDerm a atteint une aire sous la courbe de 0,73 (IC 95 pour cent de 0,70 à 0,77) en Fitzpatrick I-II et de 0,76 (0,71 à 0,80) en V-VI (Daneshjou et al., 2022).
HAM10000 après l'ajustement
Le modèle fondé sur HAM10000 est arrivé à 0,77 (0,73 à 0,80) en I-II et à 0,78 (0,75 à 0,81) en V-VI (Daneshjou et al., 2022). L'écart entre les tons clairs et foncés s'est refermé, et la performance est venue égaler ou dépasser le vote des dermatologues sur plusieurs tranches des données.
Lecture pour le clinicien
Le résultat ne signifie pas qu'une application commerciale quelconque a déjà été ajustée. Il signifie que la défaillance est corrigeable quand on dispose d'images étiquetées et diverses, et que demander des preuves de test par ton de peau est une question légitime avant l'adoption. La revue narrative de 2025 est arrivée à une conclusion similaire : la plupart des études montraient une précision moindre en Fitzpatrick IV-VI, avec une amélioration après entraînement sur des ensembles divers (Dowie, 2025).
Le ton de peau n'est pas la même chose que la race
Fitzpatrick a été créé pour estimer la réponse à la lumière ultraviolette, pas pour cartographier l'ascendance. Ulrich et ses collègues ont décrit une méthode automatisée qui estime le ton de peau et le convertit vers les échelles Monk et Fitzpatrick ; lors de la validation avec des scans corporels en 3D et des images générées par IA, la concordance était élevée avec Monk et moins cohérente avec Fitzpatrick (Ulrich et al., 2025).
Pourquoi la distinction compte en consultation
La race autodéclarée, l'ethnicité et le ton de peau mesuré sur la photo répondent à des questions différentes. Un algorithme peut échouer à cause de la pigmentation, de l'éclairage, du type de lésion ou d'un mélange de ces facteurs (Daneshjou et al., 2022 ; Ulrich et al., 2025). Traiter « peau foncée » comme une catégorie unique sans décrire la méthode de classification masque le mécanisme de l'erreur.
En pratique, le clinicien qui documente le ton observé et la qualité de la photo aide autant l'audit de l'algorithme que le raisonnement humain, dans le même esprit qui consiste à éviter les étiquettes qui cachent le reste du tableau.
Checklist CLEAR Derm et ce qu'il faut demander au fournisseur
Le groupe de travail IA de l'International Skin Imaging Collaboration a publié CLEAR Derm, une checklist de bonnes pratiques pour le développement et l'évaluation de l'IA fondée sur l'image en dermatologie (Daneshjou et al., 2022). Le document couvre la curation des données, la construction du modèle et l'évaluation, avec une attention au biais photographique et à des considérations éthiques (Daneshjou et al., 2022).
Cinq questions pratiques (synthèse de notre part)
Avant d'intégrer un classificateur à la routine, une liste de notre part, non validée comme instrument, comprend :
- La performance a-t-elle été rapportée par ton de peau ou par une échelle équivalente ?
- L'ensemble de test est-il externe à celui d'entraînement ?
- Existe-t-il un taux de sensibilité et de spécificité par sous-groupe, et pas seulement une aire sous la courbe globale ?
- Les images d'entraînement sont-elles auditables publiquement ou au moins décrites en composition démographique ?
- Existe-t-il un plan de supervision humaine et de consignation lorsque l'algorithme et le clinicien sont en désaccord ?
Ces questions dialoguent avec la lecture critique d'articles et avec le soin au sein de l'équipe mélanome, où l'image n'est qu'une étape du parcours.
Éclairage, capture et le chemin jusqu'au pixel
L'algorithme ne voit que ce que la caméra lui transmet. Lumière latérale, ombre, compression de fichier et fond coloré modifient la texture et la couleur apparentes. La revue des principes et applications de l'IA en dermatologie confirme que la qualité de l'image et la représentativité de la base limitent tout modèle (Omiye et al., 2023).
Ce qu'il faut standardiser au cabinet
Une liste opérationnelle de notre cru, fondée sur les limites décrites par les études et non testée comme protocole, comprend :
- Utiliser une lumière diffuse frontale et éviter le flash dur qui surexpose les zones claires.
- Cadrer la lésion avec une marge de peau saine autour.
- Conserver la même distance et le même angle sur les photos de suivi.
- Consigner l'appareil et la date avec le fichier clinique.
- Éviter d'envoyer à l'algorithme des photos floues ou avec un filtre embellissant.
Ces précautions valent aussi pour les lésions du voyageur et pour les diagnostics différentiels de la peau dans mpox et dans peau du voyageur, même quand l'algorithme n'entre pas dans la décision.
Ce qui change dans la décision clinique
En soins primaires, cela se traduit par ne pas déléguer la décision de biopsie à un score sans savoir sur quelle population il a été validé. La même prudence s'applique quand la photo arrive par message : une mauvaise qualité et un teint hors de la base d'entraînement augmentent l'incertitude, et le clinicien doit le dire clairement au patient.
Face à un score algorithmique, le clinicien a encore besoin de l'histoire, de l'examen et du contexte épidémiologique. Une hypothèse de notre cru est que le risque principal n'est pas le faux positif sur peau claire de démonstration, mais le faux négatif sur peau foncée quand l'application suggère « probablement bénin » avec une confiance apparente.
Comment intégrer sans automatiser la conclusion
Suggestions pratiques, présentées comme synthèse :
- Traiter le résultat de l'algorithme comme un indice, pas comme un compte rendu.
- Refuser une décision fondée sur le seul score quand le teint ou la maladie sortent du spectre de l'étude de validation.
- Documenter la divergence entre clinicien et machine pour un audit futur.
- Prioriser la biopsie ou l'adressage quand la lésion est cliniquement suspecte, indépendamment de l'application.
- Éviter d'annoncer au patient une « confirmation par intelligence artificielle » sans expliquer les limites.
Cet usage s'inscrit dans l'entraînement au diagnostic différentiel avec indices et réduit l'erreur diagnostique en soins primaires liée à une conclusion prématurée.
Quand l'algorithme et la clinique divergent
Si la lésion paraît suspecte à l'examen et que l'application suggère une bénignité, la conduite suit la clinique. Le DDI a montré une sensibilité faible en Fitzpatrick V-VI, précisément dans les tranches où le faux négatif fait le plus mal (Daneshjou et al., 2022). Dans ces cas, biopsie, dermatoscopie en présentiel ou second avis pèsent plus que le score.
Une synthèse de notre cru est de consigner dans le dossier le résultat de l'algorithme, le teint observé et la décision finale. Cette consignation crée la base locale d'audit que les études multicentriques publient encore rarement par sous-groupe.
Limites que le texte ne résout pas
Les chiffres du DDI viennent d'un ensemble constitué dans un centre académique et ne mesurent pas la performance de chaque application commerciale disponible aujourd'hui. La revue narrative de Dowie a retenu peu d'articles après des filtres restrictifs (Dowie, 2025). Ulrich valide une méthode de classification du teint, pas un classificateur de cancer (Ulrich et al., 2025).
Généraliser « toute IA de peau échoue » serait donc une inférence indue. Ce que les données soutiennent est plus étroit : les algorithmes entraînés sur des bases peu transparentes et peu diverses ont un risque mesurable de performance moindre sur les teints foncés, et ce risque diminue quand l'entraînement et le test incluent ces images à dessein (Daneshjou et al., 2022 ; Daneshjou et al., 2021).
Ce que le clinicien retient pour la prochaine consultation
Après avoir lu le DDI et la revue sur la transparence, le changement pratique n'est pas d'abandonner la technologie, mais d'exiger la même rigueur que pour un nouvel examen de laboratoire. Une synthèse de notre cru, alignée sur les résultats cités, est d'organiser la consultation en trois temps : (1) qualité de la photo et teint observé ; (2) résultat de l'algorithme comme indice, jamais comme compte rendu ; (3) décision documentée en cas de divergence.
Comment expliquer la limite au patient
Une formulation de notre part, non testée comme script, consiste à dire que l'application aide à organiser les hypothèses, mais qu'elle a été entraînée surtout sur des images de certains tons de peau, et que la décision de biopsie ou de surveillance reste clinique. Cela évite à la fois le rejet aveugle de l'outil et la confiance automatique que décrit le biais d'automatisation.
Audit minimal dans le service
Pour les services qui utilisent déjà un classificateur, une liste opérationnelle de notre part comprend de revoir chaque mois les cas où l'algorithme et le dermatologue ont divergé, de séparer les fichiers par ton de peau observé et de vérifier si les faux négatifs se concentrent en Fitzpatrick V-VI, comme le DDI l'avait prévu (Daneshjou et al., 2022). Sans ce cycle, le service reproduit l'opacité que la revue de 70 études a documentée (Daneshjou et al., 2021).
Le même esprit de mesure par sous-groupe apparaît dans la prise en charge du mélanome en équipe et dans la prévention de la fermeture prématurée, thème de l'entraînement au diagnostic différentiel avec indices. La technologie ne réduit les dommages que si le service sait sur qui elle échoue.
Études en résumé
| Étude | Plan, échantillon et unité | Résultat principal |
|---|---|---|
| Esteva 2017 | Réseau de neurones ; 129 450 images d'entraînement, 2 032 de test | Performance proche de celle des dermatologues sur la base propre |
| Adamson 2018 | Commentaire | Alerte de disparité en l'absence de mesure par sous-groupe |
| Daneshjou 2021 | Revue de portée ; 70 études | Peu de transparence sur la race et le ton de peau |
| Daneshjou 2022 (DDI) | Évaluation externe ; 656 images | Baisse d'AUC et de sensibilité en Fitzpatrick V-VI |
| Wen 2022 | Revue systématique ; 21 bases publiques, 106 950 images | Fitzpatrick renseigné dans 2,1 pour cent des images (Wen et al., 2022) |
| Groh 2024 | Expérience numérique ; 848 médecins, 364 images | Peau foncée avec une précision moindre ; l'aide de l'IA a creusé l'écart entre généralistes (Groh et al., 2024) |
| CLEAR Derm 2022 | Consensus de checklist | Items pour les données, le modèle et une évaluation équitable |
| Omiye 2023 | Revue narrative | Limites d'image et de représentativité |
| Dowie 2025 | Revue narrative ; 8 articles finaux | Précision moindre sur les tons foncés ; amélioration avec des données diverses |
| Ulrich 2025 | Méthode d'analyse du ton | Échelle Monk avec un meilleur alignement dans certains tests |
Sources : Esteva et al., 2017 ; Adamson et Smith, 2018 ; Daneshjou et al., 2021 ; Daneshjou et al., 2022 ; Daneshjou et al., 2022 ; Wen et al., 2022 ; Groh et al., 2024 ; Omiye et al., 2023 ; Dowie, 2025 ; Ulrich et al., 2025.
Comment NEXO aide à entraîner ce raisonnement
Dans NEXO, le cas du jour est fictif, avec une présentation clinique réelle et jusqu'à six indices progressifs, et vous proposez le diagnostic en cherchant le code dans la CIM-10. Un indice peut apporter « tache asymétrique sur le dos, patient au ton de peau foncé » ; un autre, « une application de peau a suggéré une bénignité avec une faible confiance ». Le retour de proximité en cinq niveaux aide à distinguer naevus, mélanome, carcinome basocellulaire et dermatite, sans transformer l'entraînement en protocole logiciel.
Questions fréquentes
Toute application de peau échoue-t-elle sur peau foncée ?
Les trois algorithmes de pointe testés dans le DDI ont chuté en Fitzpatrick V-VI, et des revues ultérieures ont retrouvé le même schéma dans la majorité des études (Daneshjou et al., 2022 ; Dowie, 2025).
Ajuster le modèle avec des données diverses suffit-il ?
Dans le DDI, l'ajustement fin a comblé l'écart entre I-II et V-VI pour DeepDerm et pour le modèle HAM10000, mais chaque produit commercial doit montrer son propre test (Daneshjou et al., 2022).
Les dermatologues sont-ils immunisés contre le biais de la photo ?
La sensibilité du vote majoritaire est passée de 0,72 à 0,59 entre tons clairs et foncés dans le DDI (Daneshjou et al., 2022).
Ton de peau et race sont-ils la même variable ?
Fitzpatrick décrit la réponse à la lumière ; race et ethnicité sont des catégories sociales distinctes, et des échelles comme Monk tentent de saisir le ton observé sur l'image (Ulrich et al., 2025).
Que demander avant d'adopter un classificateur ?
La performance par sous-groupe de ton de peau, un test externe, la sensibilité et la spécificité, pas seulement l'aire sous la courbe globale, et un plan de supervision humaine, dans l'esprit de CLEAR Derm (Daneshjou et al., 2022).
Messages à retenir
- Les algorithmes de pointe ont perdu de l'AUC et de la sensibilité sur peau foncée dans le DDI (Daneshjou et al., 2022).
- La plupart des études d'IA en dermatologie ne rapportent ni la race ni le ton de peau (Daneshjou et al., 2021).
- Un ajustement fin avec des images diverses peut combler l'écart, s'il existe des données et un audit (Daneshjou et al., 2022).
- Les dermatologues se trompent aussi davantage sur les peaux foncées, et l'aide de l'IA peut creuser l'écart entre les généralistes (Daneshjou et al., 2022 ; Groh et al., 2024).
- Le clinicien doit traiter le score comme un indice et exiger la transparence du style CLEAR Derm (Daneshjou et al., 2022).
Références
- Esteva A, Kuprel B, Novoa RA, et al. Dermatologist-level classification of skin cancer with deep neural networks. Nature. 2017;542(7639):115-118. PMID: 28117445. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC8382232/
- Adamson AS, Smith A. Machine Learning and Health Care Disparities in Dermatology. JAMA Dermatol. 2018;154(11):1247-1248. PMID: 30073260. https://pubmed.ncbi.nlm.nih.gov/30073260/
- Daneshjou R, Smith MP, Sun MD, et al. Lack of Transparency and Potential Bias in Artificial Intelligence Data Sets and Algorithms: A Scoping Review. JAMA Dermatol. 2021;157(11):1362-1369. PMID: 34550305. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC9379852/
- Daneshjou R, Vodrahalli K, Novoa RA, et al. Disparities in dermatology AI performance on a diverse, curated clinical image set. Sci Adv. 2022;8(32):eabq6147. PMID: 35960806. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC9374341/
- Daneshjou R, Barata C, Betz-Stablein B, et al. Checklist for Evaluation of Image-Based Artificial Intelligence Reports in Dermatology: CLEAR Derm Consensus Guidelines from the International Skin Imaging Collaboration Artificial Intelligence Working Group. JAMA Dermatol. 2022;158(1):58-66. PMID: 34851366. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC9845064/
- Omiye JA, Gui H, Daneshjou R, et al. Principles, applications, and future of artificial intelligence in dermatology. Front Med (Lausanne). 2023;10:1278232. PMID: 37901399. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC10602645/
- Dowie T. Exploring the Diagnostic Capability of Artificial Intelligence in Dermatology for Darker Skin Tones: A Narrative Review. Cureus. 2025;17(10):e94909. PMID: 41262830. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC12624499/
- Ulrich P, Zink A, Biedermann T, Sitaru S. Beyond Fitzpatrick: automated artificial intelligence-based skin tone analysis in dermatological patients. NPJ Digit Med. 2025;8:378. PMID: 40537526. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC12179258/
- Wen D, Khan SM, Ji Xu A, et al. Characteristics of publicly available skin cancer image datasets: a systematic review. Lancet Digit Health. 2022;4(1):e64-e74. PMID: 34772649. https://pubmed.ncbi.nlm.nih.gov/34772649/
- Groh M, Badri O, Daneshjou R, et al. Deep learning-aided decision support for diagnosis of skin disease across skin tones. Nat Med. 2024;30(2):573-583. PMID: 38317019. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC10878981/