Salud digital e IASesgos y error diagnósticoRazonamiento clínico
IA en dermatología: falla más en piel oscura
Índice
- Por qué la IA de piel se volvió promesa y riesgo
- Lo que midió el Diverse Dermatology Images
- Transparencia de los conjuntos de datos
- Ajuste fino y qué cambia con datos diversos
- Checklist CLEAR Derm y qué pedir al proveedor
- Qué cambia en la decisión clínica
- Estudios en resumen
- Cómo ayuda NEXO a entrenar ese razonamiento
- Preguntas frecuentes
- Mensajes para llevar
- Referencias
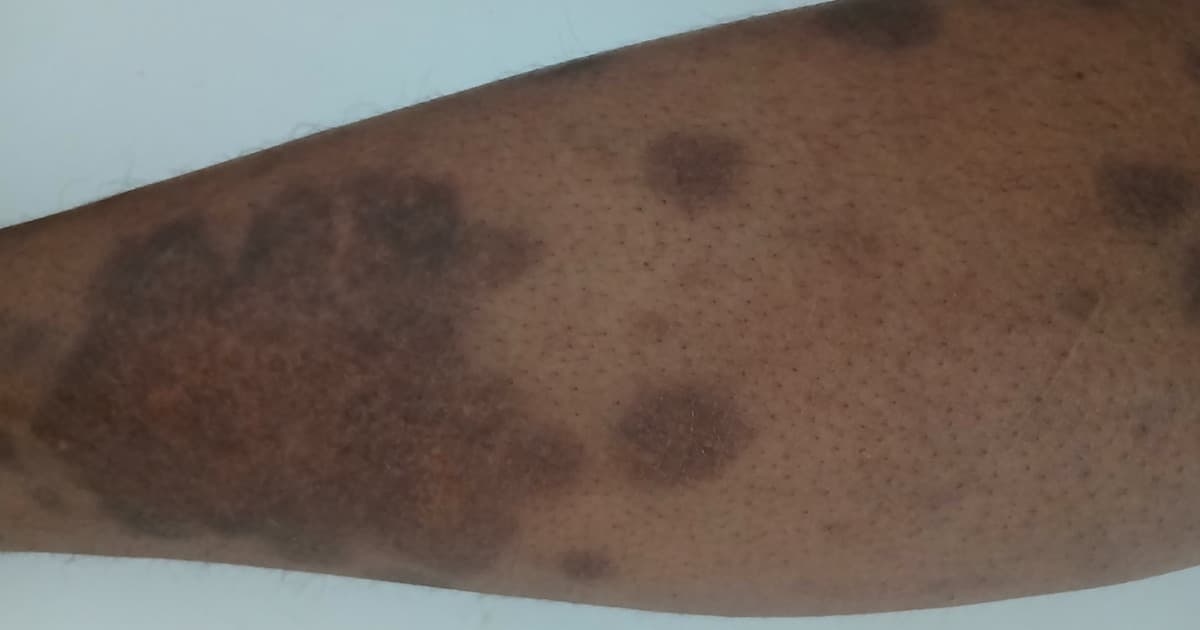
En un caso ficticio, una clínica de piel prueba una aplicación que clasifica fotos de lesiones en benignas o malignas. El algoritmo acierta con frecuencia en las imágenes claras del banco de demostración. En la misma semana, tres pacientes con tono de piel oscuro traen fotos de manchas y nódulos: la aplicación devuelve puntuaciones bajas de confianza o sugiere benignidad en lesiones que el dermatólogo considera sospechosas. El equipo se pregunta si el problema es la foto, el dispositivo o el modelo.
Este escenario resume lo que estudios recientes midieron: los clasificadores de imágenes de piel, entrenados en bancos poco diversos, pierden rendimiento en tonos oscuros y en enfermedades menos comunes. Este texto reúne lo que la literatura muestra sobre esa caída, por qué los conjuntos de datos fallan en transparencia y qué puede preguntar el clínico antes de confiar en el resultado. En cada parte, el texto informa el diseño y el tamaño de los estudios y separa lo que se midió de lo que es inferencia nuestra.
Puntos principales
- En el conjunto Diverse Dermatology Images, tres algoritmos de vanguardia tuvieron área bajo la curva ROC entre 0,56 y 0,67, muy por debajo del rendimiento reportado en sus propias pruebas (Daneshjou et al., 2022).
- La sensibilidad cayó de forma acentuada en Fitzpatrick V-VI: ModelDerm de 0,41 a 0,12 y DeepDerm de 0,69 a 0,23 (Daneshjou et al., 2022).
- En 70 estudios de IA en dermatología, solo 24,2 por ciento de las imágenes eran públicas, 20 por ciento describían raza o etnia y 10 por ciento citaban tono de piel (Daneshjou et al., 2021).
- El ajuste fino con imágenes diversas cerró la brecha entre tonos claros y oscuros en DeepDerm y en el modelo entrenado en HAM10000 (Daneshjou et al., 2022).
- Los dermatólogos también se equivocaron más en tonos oscuros y en enfermedades poco comunes, lo que importa porque ellos etiquetan muchos bancos de entrenamiento (Daneshjou et al., 2022).
- Por qué la IA de piel se volvió promesa y riesgo
- Lo que midió el Diverse Dermatology Images
- Transparencia de los conjuntos de datos
- Ajuste fino y qué cambia con datos diversos
- Checklist CLEAR Derm y qué pedir al proveedor
- Qué cambia en la decisión clínica
- Estudios en resumen
- Cómo NEXO ayuda a entrenar este razonamiento
- Preguntas frecuentes
- Mensajes para llevar
Por qué la IA de piel se volvió promesa y riesgo
La clasificación automática de lesiones cutáneas ganó atención después de que las redes neuronales profundas igualaran a los dermatólogos en tareas de melanoma y carcinoma en bancos grandes (Esteva et al., 2017). El estudio de Stanford entrenó con 129.450 imágenes y probó en 2.032 imágenes con biopsia, con un rendimiento cercano al de 21 dermatólogos certificados (Esteva et al., 2017).
El salto de 2017 y la alerta de 2018
Ese hito aceleró aplicaciones, teledermatología y la esperanza de tamizaje en atención primaria. Al año siguiente, Adamson y Smith alertaron que los modelos entrenados con datos poco representativos pueden amplificar disparidades si se implantan sin medir el rendimiento por subgrupo (Adamson y Smith, 2018). El aviso anticipó lo que el Diverse Dermatology Images (DDI) midió con números años después.
La promesa sigue siendo válida para lesiones comunes en bancos equilibrados, pero la pregunta clínica dejó de ser "¿el algoritmo acierta?" y pasó a ser "¿en quién acierta?". Este cambio de pregunta dialoga con el uso de inteligencia artificial en el razonamiento clínico y con el riesgo de confiar demasiado en la máquina.
Lo que midió el Diverse Dermatology Images
El DDI se creó para probar algoritmos en imágenes clínicamente confirmadas, con tonos de piel diversos y enfermedades comunes y poco comunes (Daneshjou et al., 2022). Tras la exclusión de fotos que no pasaron el control de calidad, quedaron 656 imágenes, balanceadas entre benignas y malignas en los extremos de Fitzpatrick (Daneshjou et al., 2022).
Composición del conjunto
Había 208 imágenes de Fitzpatrick I-II (159 benignas y 49 malignas), 241 de III-IV y 207 de V-VI (159 benignas y 48 malignas) (Daneshjou et al., 2022). Los subconjuntos de los extremos se emparejaron por clase diagnóstica para la comparación entre tonos claros y oscuros.
Rendimiento de los tres algoritmos
En el DDI completo, ModelDerm tuvo un área bajo la curva ROC de 0,65 (IC 95 por ciento de 0,61 a 0,70), DeepDerm de 0,56 (0,51 a 0,61) y el modelo entrenado en HAM10000 de 0,67 (0,62 a 0,71) (Daneshjou et al., 2022). En los propios conjuntos de prueba, esos algoritmos habían alcanzado valores mucho más altos, lo que muestra una caída al salir del entorno original.
En la comparación entre Fitzpatrick I-II y V-VI, ModelDerm pasó de 0,64 (0,55 a 0,7) a 0,55 (0,46 a 0,64), DeepDerm de 0,61 (0,50 a 0,71) a 0,50 (0,41 a 0,58) y HAM10000 de 0,72 (0,63 a 0,79) a 0,57 (0,48 a 0,67) (Daneshjou et al., 2022). La sensibilidad cayó de 0,41 a 0,12 en ModelDerm y de 0,69 a 0,23 en DeepDerm (Daneshjou et al., 2022).
Los dermatólogos también fallan en piel oscura
El DDI pidió a tres dermatólogos que clasificaran cada imagen como proceso benigno o maligno y formó un voto mayoritario (Daneshjou et al., 2022). Las etiquetas de los especialistas superaron a los algoritmos antes del ajuste fino, pero la sensibilidad de los dermatólogos también cayó de 0,72 en Fitzpatrick I-II a 0,59 en V-VI (Daneshjou et al., 2022).
El test con 848 médicos
Groh y colegas hicieron un experimento digital con 389 dermatólogos y 459 médicos de atención primaria de 39 países, que evaluaron 364 imágenes de 46 enfermedades en una simulación de teledermatología (Groh et al., 2024). La exactitud diagnóstica fue de 38 por ciento entre dermatólogos y de 19 por ciento entre generalistas, y los dos grupos fueron 4 puntos porcentuales menos precisos en piel oscura (Groh et al., 2024). El apoyo de un algoritmo de aprendizaje profundo aumentó la exactitud en más de 33 por ciento, pero amplió la diferencia entre tonos de piel entre los generalistas (Groh et al., 2024). Los autores concluyen que mejorar la exactitud global no resuelve, por sí solo, el sesgo (Groh et al., 2024).
Por qué esto importa para el entrenamiento
Muchos bancos usan etiquetas de dermatólogos como verdad de referencia. Si el error humano es mayor en tonos oscuros y en enfermedades poco comunes, el algoritmo hereda y puede amplificar esa falla (Daneshjou et al., 2022). La discusión se cruza con el sesgo implícito en el diagnóstico y con la calibración de la confianza: acierto y certeza no caminan juntos cuando cambia el subgrupo.
Una síntesis nuestra es que el dermatólogo sigue siendo indispensable, pero no es un patrón oro exento de sesgo fotográfico; su papel es filtrar el algoritmo, no solo etiquetar el banco.
Transparencia de los conjuntos de datos
Antes del DDI, la revisión de alcance en JAMA Dermatology examinó 70 estudios de aprendizaje profundo en dermatología (Daneshjou et al., 2021). Entre 1.065.291 imágenes usadas para desarrollar o probar algoritmos, solo 257.372 (24,2 por ciento) estaban disponibles públicamente (Daneshjou et al., 2021).
Lo que casi nadie reporta
Solo 14 estudios (20,0 por ciento) describían etnia o raza en al menos un conjunto, y solo 7 (10,0 por ciento) informaban algún dato de tono de piel (Daneshjou et al., 2021). Sin esa información, el lector no puede saber si el modelo fue probado en la población en la que se usará.
Bancos públicos y efecto de red
Los conjuntos públicos fueron citados con más frecuencia que los privados, lo que concentra el entrenamiento en pocas fuentes y en fotografías con un perfil demográfico similar (Daneshjou et al., 2021). Una hipótesis nuestra es que la repetición de los mismos bancos explica parte de la caída vista en el DDI cuando cambia el escenario clínico.
La revisión de alcance también mostró que la mediana de imágenes en los estudios que entrenaban algoritmos nuevos era de cerca de 10 mil, con una variación amplia, lo que refuerza la desigualdad de recursos entre grupos de investigación (Daneshjou et al., 2021). Sin datos públicos y sin descripción demográfica, la comunidad clínica no puede reproducir ni auditar el desempeño por subgrupo antes de la compra o de la implantación.
Qué contienen los bancos públicos
Wen y colegas revisaron sistemáticamente 21 bancos de imágenes de cáncer de piel de acceso abierto, con 106.950 imágenes (Wen et al., 2022). De los 14 bancos que informaban el país de origen, 11 (79 por ciento) provenían de Europa, América del Norte y Oceanía, y 19 bancos (91 por ciento) tenían solo imágenes dermatoscópicas o macroscópicas (Wen et al., 2022). La etnia estaba disponible para 1.415 imágenes (1,3 por ciento) y el fototipo de Fitzpatrick para 2.236 (2,1 por ciento) (Wen et al., 2022). Los autores piden estándares de calidad para los metadatos de los bancos (Wen et al., 2022).
Esa opacidad recuerda la alerta del informe sobre error diagnóstico: los sistemas que no miden la falla por subgrupo repiten la inequidad, tema del texto sobre el informe Improving Diagnosis.
Ajuste fino y qué cambia con datos diversos
Los autores del DDI reentrenaron DeepDerm y el modelo de HAM10000 con imágenes diversas (Daneshjou et al., 2022). Tras el ajuste fino, DeepDerm alcanzó un área bajo la curva de 0,73 (IC 95 por ciento de 0,70 a 0,77) en Fitzpatrick I-II y 0,76 (0,71 a 0,80) en V-VI (Daneshjou et al., 2022).
HAM10000 después del ajuste
El modelo basado en HAM10000 llegó a 0,77 (0,73 a 0,80) en I-II y 0,78 (0,75 a 0,81) en V-VI (Daneshjou et al., 2022). La brecha entre tonos claros y oscuros se cerró, y el desempeño pasó a igualar o superar el voto de los dermatólogos en varios segmentos de los datos.
Lectura para el clínico
El resultado no significa que cualquier aplicación comercial ya haya sido ajustada. Significa que la falla es corregible cuando hay imágenes etiquetadas y diversas, y que pedir evidencia de prueba por tono de piel es una pregunta legítima antes de la adopción. La revisión narrativa de 2025 llegó a una conclusión parecida: la mayoría de los estudios mostró peor exactitud en Fitzpatrick IV-VI, con mejora tras el entrenamiento en conjuntos diversos (Dowie, 2025).
Tono de piel no es lo mismo que raza
Fitzpatrick fue creado para estimar la respuesta a la luz ultravioleta, no para mapear ancestralidad. Ulrich y colegas describieron un método automatizado que estima el tono de piel y lo convierte a las escalas Monk y Fitzpatrick; en la validación con escaneos corporales en 3D e imágenes generadas por IA, la concordancia fue alta con Monk y menos consistente con Fitzpatrick (Ulrich et al., 2025).
Por qué la distinción importa en la consulta
La raza autodeclarada, la etnia y el tono de piel medido en la foto responden a preguntas diferentes. Un algoritmo puede fallar por pigmentación, por iluminación, por tipo de lesión o por una mezcla de esos factores (Daneshjou et al., 2022; Ulrich et al., 2025). Tratar "piel oscura" como categoría única sin describir el método de clasificación esconde el mecanismo del error.
En la práctica, el clínico que documenta el tono observado y la calidad de la foto ayuda tanto a la auditoría del algoritmo como al razonamiento humano, en el mismo espíritu de evitar etiquetas que esconden el resto del cuadro.
Checklist CLEAR Derm y qué pedir al proveedor
El grupo de trabajo de IA de la International Skin Imaging Collaboration publicó el CLEAR Derm, una lista de buenas prácticas para el desarrollo y la evaluación de IA basada en imagen en dermatología (Daneshjou et al., 2022). El documento cubre la curaduría de datos, la construcción del modelo y la evaluación, con atención al sesgo fotográfico y a consideraciones éticas (Daneshjou et al., 2022).
Cinco preguntas prácticas (síntesis nuestra)
Antes de incorporar un clasificador a la rutina, una lista nuestra, no validada como instrumento, incluye:
- ¿El desempeño se reportó por tono de piel o por una escala equivalente?
- ¿El conjunto de prueba es externo al de entrenamiento?
- ¿Hay tasa de sensibilidad y de especificidad por subgrupo, no solo área bajo la curva global?
- ¿Las imágenes de entrenamiento son públicamente auditables o al menos están descritas en su composición demográfica?
- ¿Existe un plan de supervisión humana y de registro cuando el algoritmo y el clínico discrepan?
Estas preguntas dialogan con la lectura crítica de artículos y con el cuidado en el equipo de melanoma, en el que la imagen es solo un paso del camino.
Iluminación, captura y el camino hasta el píxel
El algoritmo solo ve lo que la cámara entrega. La luz lateral, la sombra, la compresión de archivo y el fondo de color cambian la textura y el color aparentes. La revisión de principios y aplicaciones de la IA en dermatología refuerza que la calidad de la imagen y la representatividad de la base limitan cualquier modelo (Omiye et al., 2023).
Qué estandarizar en el consultorio
Una lista operativa nuestra, basada en los límites descritos por los estudios y no probada como protocolo, incluye:
- Usar luz difusa frontal y evitar el flash duro que queme el brillo.
- Encuadrar la lesión con un margen de piel sana alrededor.
- Mantener la misma distancia y el mismo ángulo en las fotos de seguimiento.
- Registrar el dispositivo y la fecha junto al archivo clínico.
- Evitar enviar al algoritmo fotos borrosas o con filtro de embellecimiento.
Estos cuidados también valen para lesiones del viajero y para diagnósticos diferenciales de piel en mpox y en piel del viajero, incluso cuando el algoritmo no entra en la decisión.
Qué cambia en la decisión clínica
En atención primaria, esto se traduce en no delegar la decisión de biopsia a una puntuación sin saber en qué población se validó. El mismo cuidado se aplica cuando la foto llega por mensaje: la mala calidad y el tono de piel fuera de la base de entrenamiento aumentan la incertidumbre, y el clínico debe decírselo al paciente con claridad.
Ante una puntuación algorítmica, el clínico aún necesita la historia, el examen y el contexto epidemiológico. Una hipótesis nuestra es que el mayor riesgo no es el falso positivo en piel clara de demostración, sino el falso negativo en piel oscura cuando la aplicación sugiere "probablemente benigno" con confianza aparente.
Cómo integrar sin automatizar el cierre
Sugerencias prácticas, marcadas como síntesis:
- Tratar el resultado del algoritmo como pista, no como informe.
- Rechazar la decisión solo por puntuación cuando el tono de piel o la enfermedad salen del espectro del estudio de validación.
- Documentar la discordancia entre clínico y máquina para auditoría futura.
- Priorizar la biopsia o la derivación cuando la lesión es clínicamente sospechosa, independientemente de la aplicación.
- Evitar anunciar al paciente una "confirmación por inteligencia artificial" sin explicar los límites.
Este uso encaja en el entrenamiento de diagnóstico diferencial con pistas y reduce el error diagnóstico en atención primaria ligado al cierre precoz.
Cuando el algoritmo y la clínica divergen
Si la lesión parece sospechosa al examen y la aplicación sugiere benignidad, la conducta sigue a la clínica. El DDI mostró sensibilidad baja en Fitzpatrick V-VI justamente en los tramos en que el falso negativo duele más (Daneshjou et al., 2022). En estos casos, la biopsia, la dermatoscopia presencial o la segunda opinión pesan más que la puntuación.
Una síntesis nuestra es registrar en la historia clínica el resultado del algoritmo, el tono de piel observado y la decisión final. Ese registro crea la base local de auditoría que los estudios multicéntricos aún rara vez publican por subgrupo.
Límites que el texto no resuelve
Los números del DDI vienen de un conjunto curado en un centro académico y no miden el desempeño de cada aplicación comercial disponible hoy. La revisión narrativa de Dowie seleccionó pocos artículos tras filtros restrictivos (Dowie, 2025). Ulrich valida un método de clasificación de tono, no un clasificador de cáncer (Ulrich et al., 2025).
Por eso, generalizar "toda IA de piel falla" sería una inferencia indebida. Lo que los datos sostienen es más estrecho: los algoritmos entrenados en bases poco transparentes y poco diversas tienen un riesgo medible de peor desempeño en tonos oscuros, y ese riesgo disminuye cuando el entrenamiento y la prueba incluyen esas imágenes a propósito (Daneshjou et al., 2022; Daneshjou et al., 2021).
Qué se lleva el clínico a la próxima consulta
Después de leer el DDI y la revisión de transparencia, el cambio práctico no es abandonar la tecnología, sino exigir el mismo rigor que se pide a un examen de laboratorio nuevo. Una síntesis nuestra, alineada con los hallazgos citados, es organizar la consulta en tres tiempos: (1) calidad de la foto y del tono de piel observado; (2) resultado del algoritmo como pista, nunca como informe; (3) decisión documentada cuando haya discordancia.
Cómo explicar el límite al paciente
Una formulación nuestra, no probada como script, es decir que la aplicación ayuda a organizar hipótesis, pero fue entrenada sobre todo con imágenes de ciertos tonos de piel, y que la decisión de biopsia o de observación sigue siendo clínica. Esto evita tanto el descarte ciego de la herramienta como la confianza automática que describe el sesgo de automatización.
Auditoría mínima en el servicio
Para servicios que ya usan un clasificador, una lista operativa nuestra incluye revisar mensualmente los casos en que el algoritmo y el dermatólogo discreparon, separar los archivos por tono de piel observado y comprobar si los falsos negativos se concentran en Fitzpatrick V-VI, como previó el DDI (Daneshjou et al., 2022). Sin ese ciclo, el servicio repite la opacidad que documentó la revisión de 70 estudios (Daneshjou et al., 2021).
El mismo espíritu de medición por subgrupo aparece en el cuidado del melanoma en equipo y en la prevención del cierre precoz, tema del entrenamiento de diagnóstico diferencial con pistas. La tecnología solo reduce el daño si el servicio sabe en quién falla.
Estudios en resumen
| Estudio | Diseño, muestra y unidad | Hallazgo principal |
|---|---|---|
| Esteva 2017 | Red neuronal; 129.450 imágenes de entrenamiento, 2.032 de prueba | Desempeño cercano al de dermatólogos en la base propia |
| Adamson 2018 | Comentario | Alerta de disparidad si falta medición por subgrupo |
| Daneshjou 2021 | Revisión de alcance; 70 estudios | Poca transparencia de raza y de tono de piel |
| Daneshjou 2022 (DDI) | Evaluación externa; 656 imágenes | Caída de AUC y de sensibilidad en Fitzpatrick V-VI |
| Wen 2022 | Revisión sistemática; 21 bases públicas, 106.950 imágenes | Fitzpatrick informado en 2,1 por ciento de las imágenes (Wen et al., 2022) |
| Groh 2024 | Experimento digital; 848 médicos, 364 imágenes | Piel oscura con menor exactitud; el apoyo de la IA amplió la diferencia entre generalistas (Groh et al., 2024) |
| CLEAR Derm 2022 | Consenso de checklist | Ítems para datos, modelo y evaluación justa |
| Omiye 2023 | Revisión narrativa | Límites de imagen y de representatividad |
| Dowie 2025 | Revisión narrativa; 8 artículos finales | Peor exactitud en tonos oscuros; mejora con datos diversos |
| Ulrich 2025 | Método de análisis de tono | Escala Monk con mejor alineación en algunas pruebas |
Fuentes: Esteva et al., 2017; Adamson y Smith, 2018; Daneshjou et al., 2021; Daneshjou et al., 2022; Daneshjou et al., 2022; Wen et al., 2022; Groh et al., 2024; Omiye et al., 2023; Dowie, 2025; Ulrich et al., 2025.
Cómo ayuda NEXO a entrenar ese razonamiento
En NEXO, el caso del día es ficticio, con presentación clínica real y hasta seis pistas progresivas, y tú propones el diagnóstico buscando el código en la CIE-10. Una pista puede traer "mancha asimétrica en el dorso, paciente con tono de piel oscuro"; otra, "una aplicación de piel sugirió benignidad con baja confianza". La respuesta de proximidad en cinco niveles ayuda a separar nevo, melanoma, carcinoma basocelular y dermatitis, sin convertir el entrenamiento en un protocolo de software.
Preguntas frecuentes
¿Toda aplicación de piel falla en tono oscuro?
Los tres algoritmos de punta probados en el DDI cayeron en Fitzpatrick V-VI, y revisiones posteriores encontraron el mismo patrón en la mayoría de los estudios (Daneshjou et al., 2022; Dowie, 2025).
¿Ajustar el modelo con datos diversos lo resuelve?
En el DDI, el ajuste fino cerró la brecha entre I-II y V-VI en DeepDerm y en el modelo de HAM10000, pero cada producto comercial debe mostrar su propia prueba (Daneshjou et al., 2022).
¿Los dermatólogos son inmunes al sesgo de la foto?
La sensibilidad del voto mayoritario cayó de 0,72 a 0,59 entre tonos claros y oscuros en el DDI (Daneshjou et al., 2022).
¿Tono de piel y raza son la misma variable?
Fitzpatrick describe la respuesta a la luz; raza y etnia son categorías sociales distintas, y escalas como Monk intentan capturar el tono observado en la imagen (Ulrich et al., 2025).
¿Qué pedir antes de adoptar un clasificador?
Desempeño por subgrupo de tono de piel, prueba externa, sensibilidad y especificidad, no solo el área bajo la curva global, y un plan de supervisión humana, en el espíritu de CLEAR Derm (Daneshjou et al., 2022).
Mensajes para llevar
- Los algoritmos de punta perdieron AUC y sensibilidad en piel oscura en el DDI (Daneshjou et al., 2022).
- La mayoría de los estudios de IA en dermatología no reporta raza ni tono de piel (Daneshjou et al., 2021).
- El ajuste fino con imágenes diversas puede cerrar la brecha, si hay datos y auditoría (Daneshjou et al., 2022).
- Los dermatólogos también se equivocan más en tonos oscuros, y el apoyo de la IA puede ampliar la diferencia entre generalistas (Daneshjou et al., 2022; Groh et al., 2024).
- El clínico debe tratar la puntuación como una pista y exigir transparencia en el estilo CLEAR Derm (Daneshjou et al., 2022).
Referencias
- Esteva A, Kuprel B, Novoa RA, et al. Dermatologist-level classification of skin cancer with deep neural networks. Nature. 2017;542(7639):115-118. PMID: 28117445. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC8382232/
- Adamson AS, Smith A. Machine Learning and Health Care Disparities in Dermatology. JAMA Dermatol. 2018;154(11):1247-1248. PMID: 30073260. https://pubmed.ncbi.nlm.nih.gov/30073260/
- Daneshjou R, Smith MP, Sun MD, et al. Lack of Transparency and Potential Bias in Artificial Intelligence Data Sets and Algorithms: A Scoping Review. JAMA Dermatol. 2021;157(11):1362-1369. PMID: 34550305. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC9379852/
- Daneshjou R, Vodrahalli K, Novoa RA, et al. Disparities in dermatology AI performance on a diverse, curated clinical image set. Sci Adv. 2022;8(32):eabq6147. PMID: 35960806. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC9374341/
- Daneshjou R, Barata C, Betz-Stablein B, et al. Checklist for Evaluation of Image-Based Artificial Intelligence Reports in Dermatology: CLEAR Derm Consensus Guidelines from the International Skin Imaging Collaboration Artificial Intelligence Working Group. JAMA Dermatol. 2022;158(1):58-66. PMID: 34851366. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC9845064/
- Omiye JA, Gui H, Daneshjou R, et al. Principles, applications, and future of artificial intelligence in dermatology. Front Med (Lausanne). 2023;10:1278232. PMID: 37901399. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC10602645/
- Dowie T. Exploring the Diagnostic Capability of Artificial Intelligence in Dermatology for Darker Skin Tones: A Narrative Review. Cureus. 2025;17(10):e94909. PMID: 41262830. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC12624499/
- Ulrich P, Zink A, Biedermann T, Sitaru S. Beyond Fitzpatrick: automated artificial intelligence-based skin tone analysis in dermatological patients. NPJ Digit Med. 2025;8:378. PMID: 40537526. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC12179258/
- Wen D, Khan SM, Ji Xu A, et al. Characteristics of publicly available skin cancer image datasets: a systematic review. Lancet Digit Health. 2022;4(1):e64-e74. PMID: 34772649. https://pubmed.ncbi.nlm.nih.gov/34772649/
- Groh M, Badri O, Daneshjou R, et al. Deep learning-aided decision support for diagnosis of skin disease across skin tones. Nat Med. 2024;30(2):573-583. PMID: 38317019. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC10878981/