Gynécologie-obstétriqueSanté mondialeCommunication et éthique
Dans un cas fictif, une équipe mobile arrive dans un quartier densément peuplé d'une ville à forte charge de tuberculose. En une seule journée, des centaines d'adultes passent une radiographie thoracique numérique, et il n'y a qu'un seul radiologue pour toute la région, qui ne verra les images que des semaines plus tard. L'équipe décide qu'un logiciel attribuera à chaque image un score de 0 à 100, et que ceux qui dépassent un certain nombre seront orientés vers le test moléculaire sur crachat. La question qui divise l'équipe est simple à énoncer et difficile à trancher : quel nombre utiliser ?
La détection assistée par ordinateur, connue sous le sigle anglais CAD, est entrée dans la recommandation de l'Organisation mondiale de la Santé (OMS) en 2021 comme alternative au lecteur humain dans le dépistage et le triage de la tuberculose. L'OMS elle-même insiste toutefois sur le fait que le seuil doit être calibré pour chaque contexte, car le même logiciel, avec le même seuil, se comporte différemment selon les populations.
Ce texte montre ce que l'OMS a recommandé et avec quelle force, comment les études mesurent la précision de ces programmes, ce qu'il advient des faux positifs quand le seuil baisse et quels groupes le logiciel tend à se tromper davantage.
Points principaux
La tuberculose est la première cause de décès par un seul agent infectieux, et en 2024 elle a tué 1,23 million de personnes, dont 150 000 vivaient avec le VIH, selon la fiche d'information de l'OMS (OMS, 2026). La même année, 10,7 millions de personnes sont tombées malades : 5,8 millions d'hommes, 3,7 millions de femmes et 1,2 million d'enfants.
La maladie se concentre là où les ressources manquent. Plus de 80 pour cent des cas et des décès surviennent dans des pays à revenu faible ou intermédiaire, et les régions de l'Asie du Sud-Est, du Pacifique occidental et de l'Afrique totalisent la majeure partie de la charge (OMS, 2026). Les voyageurs et les professionnels qui soignent des personnes venues de ces régions retrouvent la même question diagnostique dans un autre cadre.
Le problème central est l'écart entre ceux qui tombent malades et ceux qui sont diagnostiqués. Dans le document de 2021, l'OMS rappelle qu'en 2019, environ 2,9 millions des 10 millions de personnes atteintes de tuberculose n'ont pas été diagnostiquées ou n'ont pas été notifiées (OMS, 2021). Une partie de ces personnes a peu de symptômes ou aucun, et n'apparaît que lorsque quelqu'un va activement à leur recherche.
L'OMS distingue deux usages de la radiographie (OMS, 2021). Dans le dépistage, la radiographie est proposée à une population à risque, avec ou sans symptômes, et la prévalence de la tuberculose reste généralement inférieure à 5 pour cent (OMS, 2021). Dans le triage, la radiographie est réalisée chez des personnes qui ont déjà consulté avec des symptômes, et la prévalence se situe en général entre 10 et 20 pour cent, selon le même document (OMS, 2021).
Cette différence de prévalence compte beaucoup. Comme discuté dans probabilité pré-test, le même test, avec la même sensibilité et la même spécificité, produit des proportions très différentes de faux positifs selon que la maladie est rare ou fréquente dans la population testée. L'oublier, c'est tomber dans l'erreur décrite dans taux de base dans le diagnostic.
Dans les deux usages, la radiographie ne confirme rien. Une personne dont l'image est anormale passe à un test bactériologique, comme le test moléculaire rapide sur crachat, et c'est ce test qui confirme la maladie.
Le Module 2 des directives consolidées de l'OMS sur la tuberculose, consacré au dépistage, a apporté une nouvelle recommandation sur la lecture automatisée (OMS, 2021). En traduction libre, le texte dit que, chez les individus de 15 ans et plus dans les populations où le dépistage de la tuberculose est recommandé, des programmes de détection assistée par ordinateur peuvent être utilisés à la place de lecteurs humains pour interpréter des radiographies thoraciques numériques lors du dépistage et du triage de la maladie. La directive elle-même classe la recommandation comme conditionnelle, avec une faible certitude des preuves.
Les deux qualificatifs ont du poids. Une recommandation conditionnelle signifie que le groupe qui a élaboré la directive a jugé que les bénéfices dépassent probablement les risques, mais que la décision dépend du contexte, des ressources et des valeurs locales. La faible certitude indique que de nouvelles études peuvent modifier l'estimation de l'effet.
Le groupe d'élaboration de la directive a examiné trois évaluations indépendantes de trois produits marqués CE jusqu'en janvier 2020, et a fait l'analyse sans savoir quelles étaient les marques (OMS, 2021). La recommandation vaut pour les radiographies numériques en incidence postéro-antérieure ou antéro-postérieure. Les incidences latérale et oblique sont restées dehors, et la performance sur des radiographies analogiques numérisées est inconnue.
Le document délimite aussi la cible. L'exactitude a été mesurée contre la tuberculose confirmée bactériologiquement, et le logiciel ne détecte pas d'autres maladies pulmonaires que la tuberculose ; il n'y avait pas de données sur la performance en diagnostic différentiel (OMS, 2021). Cela sépare ce sujet de la découverte fortuite abordée dans nodule pulmonaire fortuit et probabilité : là, l'image a été faite pour un autre motif et le raisonnement part de la probabilité de cancer ; ici, l'image est faite exprès, en masse, pour trouver une seule maladie.
Enfin, la recommandation s'applique aux produits qui ne se montrent pas inférieurs à ceux évalués lors d'une validation externe. L'OMS cite aussi le potentiel d'élargir l'accès là où manquent des radiologues, mais conditionne la faisabilité à l'équipement, à la connexion internet et à la maintenance (OMS, 2021).
Le groupe a comparé le logiciel à des lecteurs humains en utilisant le même standard de référence bactériologique. Pour cela, il a fixé le seuil du logiciel au point où la sensibilité atteignait environ 90 pour cent et a comparé la spécificité obtenue à celle des lecteurs (OMS, 2021). Ce chiffre vient du profil de produit cible de l'OMS, qui demande une sensibilité supérieure à 0,90 et une spécificité supérieure à 0,70 pour un test de triage.
| Usage | Lecteur | Sensibilité | Spécificité |
|---|---|---|---|
| Profil de produit cible | Objectif | supérieure à 0,90 | supérieure à 0,70 |
| Dépistage | Logiciel de CAD | 0,90 à 0,92 | 0,23 à 0,66 |
| Dépistage | Lecteur humain | 0,82 à 0,93 | 0,14 à 0,63 |
| Triage | Logiciel de CAD | 0,90 à 0,91 | 0,25 à 0,79 |
| Triage | Lecteur humain | 0,89 à 0,96 | 0,36 à 0,63 |
Sources : OMS, 2021, Module 2, tableau 4 du document ; valeurs exprimées en proportions, intervalles entre études, sans estimation regroupée.
Le tableau montre ce que l'OMS a appelé une faible différence entre logiciel et lecteur humain. Les plages de spécificité sont larges dans les deux groupes, et le document n'a pas regroupé les estimations dans une méta-analyse (OMS, 2021). La conclusion a été une exactitude similaire, et non une supériorité.
Une revue systématique antérieure aide à comprendre pourquoi l'OMS a été prudente (Harris et al., 2019). Les auteurs ont réuni 53 études, 40 de développement et 13 d'évaluation clinique. La médiane de l'aire sous la courbe était de 0,88 dans les études de développement et de 0,75 dans les études cliniques, et la spécificité dans les études cliniques variait de 0,23 à 0,69. Les auteurs n'ont pas fait de méta-analyse, en raison de l'hétérogénéité et du risque de biais.
L'écart entre le laboratoire et le monde réel est courant dans les outils d'IA. Le même phénomène apparaît dans IA autonome dans le dépistage de la rétinopathie diabétique, où la validation prospective a donné sa crédibilité à l'usage clinique. Les lecteurs qui veulent une vue plus large du sujet peuvent voir l'usage de l'intelligence artificielle dans le raisonnement clinique.
Deux évaluations indépendantes ont confronté plusieurs programmes au même ensemble d'images. Dans une étude rétrospective portant sur 1196 patients ambulatoires du Népal et du Cameroun, avec le test moléculaire comme référence, trois programmes ont obtenu des aires sous la courbe de 0,92 à 0,94 (Qin et al., 2019). Les auteurs ont estimé que le logiciel pourrait réduire de 66 pour cent les tests moléculaires nécessaires tout en maintenant la sensibilité à 95 pour cent ou plus (Qin et al., 2019).
Au Vietnam, une bibliothèque de 1032 radiographies a servi à comparer 12 programmes avec un lecteur expert et un lecteur intermédiaire (Codlin et al., 2021). Six programmes ont eu des performances équivalentes à celles de l'expert. Les auteurs citent comme limites l'origine dans une seule région, le dessin rétrospectif et un échantillon orienté vers des personnes suspectées de tuberculose.
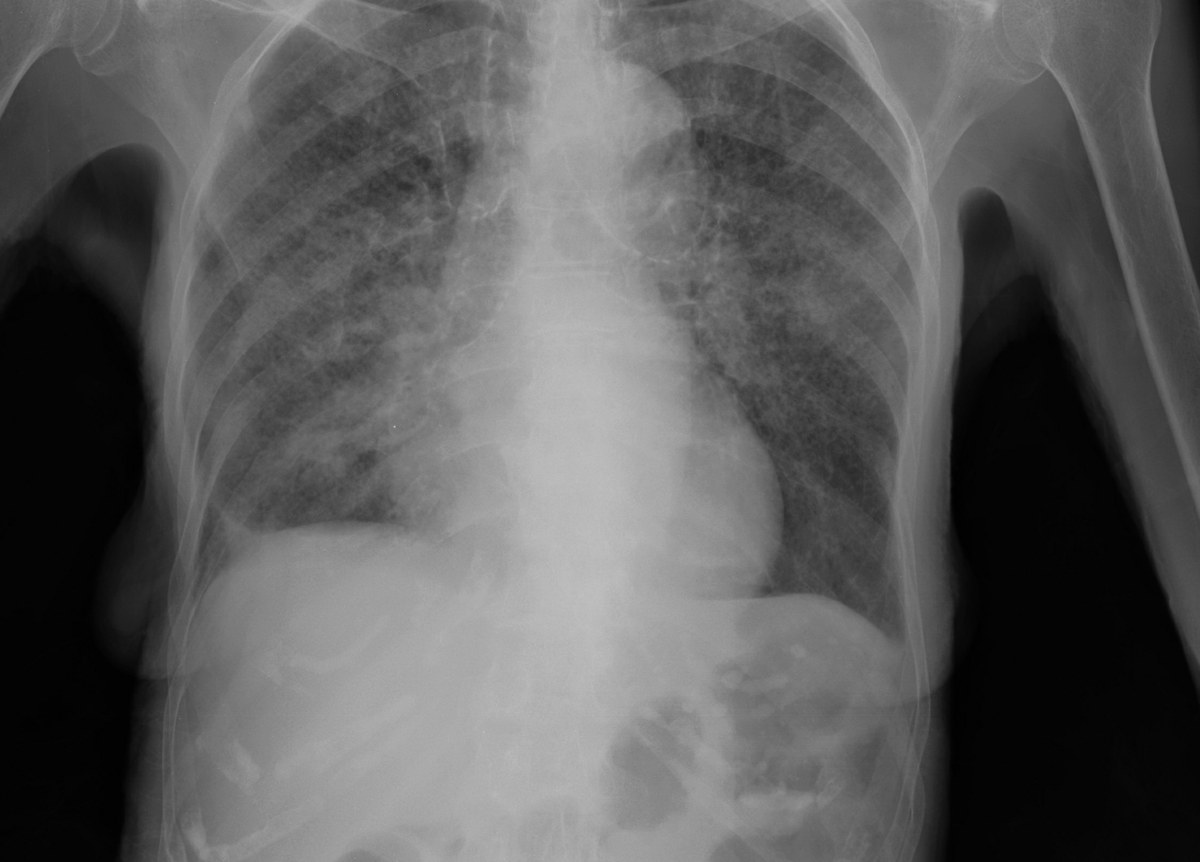
Le logiciel ne dit pas « tuberculose » ou « normal ». Il renvoie un score continu, et quelqu'un doit choisir à partir de quelle valeur l'image sera traitée comme anormale. Une enquête qualitative auprès d'utilisateurs de neuf pays à forte charge résume le dilemme : relever le seuil rend le logiciel plus spécifique et moins sensible, abaisser le seuil fait l'inverse, et aucun seuil n'est à la fois parfaitement sensible et parfaitement spécifique (Creswell et al., 2023). Le meilleur point est celui qui équilibre l'exactitude avec le volume d'examens de confirmation que le service peut absorber.
Le travail de Vanobberghen et de ses collègues est décrit par les auteurs comme une analyse secondaire de l'enquête nationale de prévalence de la tuberculose du Lesotho, de 2019 (Vanobberghen et al., 2024). 17 070 personnes de 15 ans ou plus y ont participé. Comme seules les personnes symptomatiques ou ayant une radiographie anormale ont passé le test bactériologique, seuls 5214 participants ont eu leur statut tuberculeux déterminé, et 142 avaient la maladie.
Pour tenir compte des personnes non testées, les auteurs ont comparé six méthodes. Avec une imputation multiple, le seuil 13 a donné une sensibilité de 89,7 pour cent, avec un intervalle de confiance à 95 pour cent de 84,6 à 94,8, et une spécificité de 74,2 pour cent, avec un intervalle de 73,6 à 74,9 (Vanobberghen et al., 2024). Supposer que toutes les personnes non testées étaient négatives a conduit à des résultats similaires.
| Seuil du logiciel | Sensibilité (pour cent) | Spécificité (pour cent) |
|---|---|---|
| 3 | 96,5 | 38,1 |
| 5 | 93,7 | 54,2 |
| 8 | 91,5 | 65,5 |
| 10 | 90,1 | 69,7 |
| 13 | 90,1 | 74,2 |
Sources : Vanobberghen et al., 2024, tableau 3, approche qui traite les personnes non testées comme négatives ; score de 0 à 100 d'une version spécifique du logiciel.
Entre les seuils 13 et 10, la sensibilité est restée identique et la spécificité a baissé. Du seuil 13 au seuil 3, la sensibilité a gagné 6,4 points de pourcentage, tandis que la spécificité a perdu 36,1 points. Les auteurs qualifient de substantielles les baisses de spécificité aux seuils plus bas.
Un calcul illustratif, réalisé par nous à partir du tableau 3 de Vanobberghen et de ses collègues, et non par les auteurs, aide à voir l'effet. Sur 1000 personnes sans tuberculose, une spécificité de 74,2 pour cent laisse environ 258 images faussement anormales, tandis qu'une spécificité de 38,1 pour cent en laisse environ 619, selon les valeurs de l'étude (Vanobberghen et al., 2024). Chacune de ces personnes a besoin d'un recueil de crachats, d'un test moléculaire et d'une réponse, et certaines peuvent finir traitées sans confirmation, le type d'excès discuté dans le surdiagnostic.
La même étude apporte un contraste avec la lecture humaine sur le terrain. La lecture humaine des radiographies dans l'enquête, intégrant la lecture centrale lorsqu'elle était disponible, a eu une sensibilité de 47,2 pour cent et une spécificité de 96,5 pour cent (Vanobberghen et al., 2024). La lecture humaine a été bien plus spécifique et bien moins sensible que le logiciel au seuil choisi.
Les auteurs énumèrent des problèmes importants. Beaucoup de radiographies manquaient, davantage dans les zones urbaines, ce qui peut compromettre la représentativité ; environ 19 pour cent des personnes invitées ont refusé l'enquête, en plus grande proportion des jeunes hommes des zones urbaines (Vanobberghen et al., 2024). L'imputation multiple repose sur l'hypothèse que les données manquent au hasard. En outre, l'estimation de prévalence variait de 0,83 à 2,72 pour cent selon la méthode, ce qui montre à quel point le résultat dépend de la façon de traiter les personnes non testées (Vanobberghen et al., 2024). L'un des auteurs est de l'OMS.
Le seuil optimal du Lesotho ne vaut pas pour d'autres lieux. Les auteurs eux-mêmes citent des seuils de 50 au Bangladesh et de 20 en Afrique du Sud pour le même type de programme et concluent que le seuil dépend du contexte (Vanobberghen et al., 2024). Dans l'étude du Népal et du Cameroun, le point de coupe d'un même programme qui garantissait la sensibilité souhaitée était de 63 dans un pays et de 48 dans l'autre, et un seuil universel a eu un rendement différent dans chaque lieu (Qin et al., 2019).
Les utilisateurs entendus par Creswell et ses collègues rapportent que le choix du seuil suscite encore des controverses parmi les décideurs politiques et que les stratégies employées ont été diverses et peu structurées, et ils considèrent les études de calibration difficiles à réaliser et à répéter (Creswell et al., 2023). Le programme spécial de recherche sur les maladies tropicales de l'OMS a publié un processus pour orienter ce choix.
La spécificité moyenne masque des groupes où le logiciel échoue davantage. La méta-analyse de données individuelles de Tavaziva et ses collègues a réuni 3727 participants de quatre études, avec environ 17 pour cent de personnes vivant avec le VIH et 17 pour cent avec une tuberculose confirmée (Tavaziva et al., 2022). Avec la sensibilité groupée fixée à 90 pour cent, les spécificités de trois programmes se situaient entre 54,1 et 60,5 pour cent (Tavaziva et al., 2022).
La plus forte baisse est apparue chez les personnes ayant déjà eu la tuberculose. Dans la même méta-analyse, la spécificité était de 26,6 à 33,7 pour cent chez les personnes avec un traitement antérieur et de 58,0 à 69,3 pour cent chez les autres (Tavaziva et al., 2022). La sensibilité était aussi plus faible dans la tuberculose à bacilloscopie négative et, pour deux des produits, chez les personnes vivant avec le VIH. Les auteurs concluent que les seuils doivent être définis à partir des populations de chaque utilisateur, et reconnaissent que les données de trois des sept études éligibles n'étaient pas disponibles et que des données de CD4 manquaient.
Une étude à Lusaka, en Zambie, a examiné ce groupe de près. Les auteurs décrivent une analyse rétrospective d'une étude transversale prospective de recherche de cas, avec 1884 personnes symptomatiques de 15 ans ou plus, dont 452, soit 24,0 pour cent, avaient une tuberculose antérieure (Kagujje et al., 2023). Avec des seuils fixés pour une sensibilité de 90 pour cent, la spécificité d'un programme était de 24,0 pour cent chez les personnes avec une tuberculose antérieure et de 60,3 pour cent chez celles sans antécédent ; celle d'un autre était de 22,2 contre 61,8 pour cent (Kagujje et al., 2023). L'étude n'a pas comporté de comparaison avec un lecteur humain, l'antécédent de tuberculose était auto-déclaré et le test moléculaire a servi de référence.
Les cicatrices d'une tuberculose traitée restent visibles sur la radiographie, et le logiciel tend à lire ces séquelles comme une maladie active. Dans l'évaluation vietnamienne, la plupart des programmes ont eu un rendement significativement moins bon chez les personnes avec une tuberculose antérieure (Codlin et al., 2021).
En Afrique du Sud, une validation externe a utilisé un échantillon cas-témoins de 774 personnes de 15 ans ou plus, dont 258 avec tuberculose, tiré de l'enquête nationale de prévalence de 2017 à 2019, pour tester 12 programmes (Qin et al., 2024). Les aires sous la courbe allaient d'environ 0,9 pour les meilleurs à moins de 0,8 pour les moins bons, et tous les produits ont eu un rendement moins bon chez les personnes plus âgées, avec une tuberculose antérieure et avec le VIH. Les auteurs reconnaissent que l'étude manquait de puissance, avec 258 personnes avec tuberculose pour 291 nécessaires, qu'une partie des données était auto-déclarée et que les personnes asymptomatiques avec une radiographie normale ont été exclues.
Au Lesotho, la sensibilité a beaucoup varié selon le statut VIH, en fonction du score, mais la spécificité n'a presque pas changé (Vanobberghen et al., 2024), ce qui montre comment ces résultats varient d'une population à l'autre. Dans l'évaluation menée au Vietnam, le type d'équipement de radiographie a aussi affecté la performance de certains programmes (Codlin et al., 2021).
La leçon pratique est que l'opérateur doit savoir qui se trouve devant l'appareil. Une file avec beaucoup d'adultes plus âgés et beaucoup de personnes déjà traitées produira plus de faux positifs qu'une file de jeunes sans antécédent de tuberculose, même avec le même seuil.
Le logiciel change avec le temps. Dans un ensemble cas-témoins de 12 890 radiographies du Bangladesh, l'aire sous la courbe d'un programme est passée de 0,823 dans une version à 0,903 dans la suivante, et celle d'un autre est passée de 0,872 à 0,906 (Qin et al., 2022). Les versions plus récentes ont atteint le profil de produit cible de l'OMS, mais la mise à jour a modifié les seuils qui donnaient la même sensibilité, et les auteurs recommandent de réévaluer avec des données locales. L'étude n'a pas utilisé de culture, n'a pas utilisé la version la plus sensible du test moléculaire et a exclu les moins de 15 ans.
La directive de l'OMS traite du déploiement dans la section 4.4 (OMS, 2021). Le document décrit une variation substantielle entre les sites même avec le même logiciel et le même seuil, et demande pour cela une calibration locale du score en fonction des objectifs du programme, suivie d'un suivi continu. Ce suivi compare les lectures du logiciel à celles de lecteurs humains, aux résultats bactériologiques et à la proportion d'images classées comme anormales. Un manuel opérationnel, un protocole de calibration et un outil en ligne accompagnent la directive.
Quand la machine décide qui passe au test, l'équipe tend à ne plus regarder les images qu'elle a qualifiées de normales. Ce risque est le sujet du biais d'automatisation. La proportion d'images anormales est une bonne alerte : si elle monte ou baisse sans changement dans la population, quelque chose a changé dans l'appareil, dans le logiciel ou dans le flux.
Le logiciel modifie aussi qui fait quoi. Dans beaucoup d'endroits, la personne qui opère l'appareil et adresse le patient est un technicien ou un agent de santé, et non un médecin, une organisation discutée dans le transfert de tâches. Dans les sites à faibles ressources, la radiographie lue par logiciel coexiste avec d'autres examens simples, comme ceux décrits dans le diagnostic avec peu de ressources.
Une étude récente suggère que le score peut porter une information au-delà du moment de l'examen. Dans une cohorte prospective de 483 contacts domiciliaires de personnes atteintes de tuberculose résistante à la rifampicine en Afrique du Sud, suivis pendant une médiane de 4,6 ans, 23 personnes avaient une tuberculose prévalente et 38 une tuberculose incidente (Macpherson et al., 2025). L'aire sous la courbe était de 0,87 à 0,91 pour la maladie prévalente et de 0,60 à 0,65 pour la maladie incidente. Plus de 30 pour cent des personnes au-dessus du seuil, avec des crachats de routine négatifs, ont été diagnostiquées plus tard, par l'investigation élargie des crachats ou pendant le suivi (Macpherson et al., 2025). Les auteurs avertissent que les seuils plus bas testés n'ont pas eu de validation externe et que l'étude a été menée dans un contexte de forte charge.
La recommandation de l'OMS vaut pour les personnes de 15 ans ou plus, et la directive classe le logiciel pour enfants parmi les lacunes de recherche urgentes (OMS, 2021). La radiographie de l'enfant est différente : les ganglions du hile et du médiastin dominent le tableau, et l'image change avec l'âge.
L'étude de Palmer et de ses collègues a utilisé les radiographies de 620 enfants de moins de 13 ans inclus dans une étude diagnostique observationnelle prospective au Cap, entre 2012 et 2017 (Palmer et al., 2023). 525 images ont été analysées, avec un ensemble de test de 80, la moitié avec tuberculose et la moitié sans. Le standard de référence était la lecture radiologique d'un panel d'experts, et non la confirmation bactériologique.
La version adulte du logiciel avait une aire sous la courbe de 0,58 sur ce jeu de données. Après un ajustement fin avec des images pédiatriques, l'aire est montée à 0,72, une différence statistiquement significative avec un p de 0,0016 (Palmer et al., 2023). Même améliorée, la performance est restée loin de celle observée chez les adultes.
Les auteurs reconnaissent que le jeu de données était petit pour l'apprentissage profond, que le standard de référence dépendait d'une lecture humaine et que les spécialistes ont été en désaccord entre eux sur 25 des 80 images de test (Palmer et al., 2023). La population était constituée d'enfants en investigation diagnostique, et non en dépistage. L'un des coauteurs appartient à l'entreprise qui développe le logiciel. L'étude est une preuve de concept, et elle ne soutient pas l'usage du logiciel chez les enfants.
L'équipe de notre cas fictif a désormais des questions plus utiles que « quel nombre utiliser ». Combien de tests moléculaires par jour le laboratoire peut-il absorber ? Quelle est la prévalence attendue dans cette file ? Combien de personnes ont déjà eu la tuberculose ? La version du logiciel est-elle la même que celle des études de calibration ?
Avec ces réponses, l'équipe peut choisir un seuil initial, enregistrer la proportion d'images anormales et comparer un échantillon de lectures avec le radiologue et avec les résultats des crachats. Si la file compte beaucoup d'adultes traités dans le passé, elle doit s'attendre à plus de faux positifs et ajuster le flux. Et elle doit se rappeler que les jeunes enfants qui passeront par l'unité sortent de la recommandation et ont besoin d'une évaluation clinique.
Dans NEXO, le cas du jour est fictif, avec une présentation clinique réelle et jusqu'à six indices progressifs, et vous proposez le diagnostic en cherchant le code dans la CIM-10. Choisir un seuil exige le même exercice : peser la probabilité avant l'examen, demander qui est testé et décider quoi faire d'un résultat qui ne concorde pas, comme dans l'entraînement au diagnostic différentiel avec indices.
Les limites d'usage du jeu sont décrites sur la page d'Économie de NEXO. Si vous faites de la recherche sur l'enseignement du raisonnement clinique, la page pour les Researcher explique comment prendre contact. Les professionnels qui écrivent ou révisent des cas trouvent des informations dans Curator et dans Creators, et les institutions peuvent découvrir la proposition sur la page pour les partenariats. Chercher le bon code dans la CIM-10 complète cet entraînement.
Il indique qui doit passer à un test de confirmation. L'OMS a évalué le logiciel contre la tuberculose confirmée bactériologiquement, et la confirmation continue de dépendre du test sur les crachats (OMS, 2021).
L'OMS la classe comme conditionnelle, avec une faible certitude des preuves, et limitée aux personnes de 15 ans ou plus et aux radiographies numériques en incidence frontale (OMS, 2021).
Les études montrent des seuils optimaux très différents entre pays et entre versions du même programme, et l'OMS demande une calibration locale (Vanobberghen et al., 2024 ; Qin et al., 2022).
Parce que, près du point où la sensibilité est déjà élevée, chaque petit gain de sensibilité provoque une grande perte de spécificité. Au Lesotho, passer du seuil 13 au seuil 3 a gagné 6,4 points de sensibilité et perdu 36,1 de spécificité (Vanobberghen et al., 2024).
Elles peuvent l'être, mais la spécificité chute beaucoup dans ce groupe, et le service doit s'attendre à de nombreux orientations sans maladie active (Tavaziva et al., 2022 ; Kagujje et al., 2023).
La recommandation de l'OMS exclut les moins de 15 ans, et la meilleure étude pédiatrique disponible est une preuve de concept avec un petit échantillon (Palmer et al., 2023).