Enfermedades infecciosasMedicina tropical y del viajeroAtención primaria
En un caso ficticio, un equipo móvil llega a un barrio populoso de una ciudad con alta carga de tuberculosis. En un solo día, cientos de adultos se hacen una radiografía digital de tórax, y hay un único radiólogo para toda la región, que solo verá las imágenes semanas después. El equipo decide que un software dará a cada imagen una puntuación de 0 a 100, y quien supere cierto número será derivado a la prueba molecular en esputo. La pregunta que divide al equipo es simple de enunciar y difícil de responder: ¿qué número usar?
La detección asistida por computador, conocida por la sigla en inglés CAD, entró en la recomendación de la Organización Mundial de la Salud (OMS) en 2021 como alternativa al lector humano en el rastreo y la triaje de la tuberculosis. La propia OMS, sin embargo, insiste en que el punto de corte debe calibrarse para cada contexto, porque el mismo software, con el mismo umbral, se comporta de forma diferente en poblaciones diferentes.
Este texto muestra qué recomendó la OMS y con qué fuerza, cómo los estudios miden la exactitud de esos programas, qué ocurre con los falsos positivos cuando baja el umbral y qué grupos tiende a equivocar más el software.
Puntos principales
La tuberculosis es la principal causa de muerte por un único agente infeccioso, y en 2024 mató a 1,23 millones de personas, de las cuales 150 000 vivían con VIH, según la ficha informativa de la OMS (OMS, 2026). En el mismo año, 10,7 millones de personas enfermaron: 5,8 millones de hombres, 3,7 millones de mujeres y 1,2 millones de niños.
La enfermedad se concentra donde hay menos recursos. Más de 80 por ciento de los casos y las muertes ocurren en países de ingresos bajos y medios, y las regiones del Sudeste Asiático, el Pacífico Occidental y África suman la mayor parte de la carga (OMS, 2026). Los viajeros y los profesionales que atienden a personas provenientes de esas regiones encuentran la misma pregunta diagnóstica en otro escenario.
El problema central es la brecha entre quienes enferman y quienes son diagnosticados. En el documento de 2021, la OMS recuerda que, en 2019, cerca de 2,9 millones de las 10 millones de personas con tuberculosis no fueron diagnosticadas o no fueron notificadas (OMS, 2021). Parte de esas personas tiene pocos síntomas o ninguno, y solo aparece cuando alguien va a buscarlas activamente.
La OMS separa dos usos de la radiografía (OMS, 2021). En el rastreo, la radiografía se ofrece a una población en riesgo, con o sin síntomas, y la prevalencia de tuberculosis suele quedar por debajo de 5 por ciento (OMS, 2021). En la triaje, la radiografía se hace en personas que ya acudieron al servicio con síntomas, y la prevalencia queda en general entre 10 y 20 por ciento, según el mismo documento (OMS, 2021).
Esa diferencia de prevalencia importa mucho. Como se discute en probabilidad pretest, la misma prueba, con la misma sensibilidad y especificidad, produce proporciones muy diferentes de falsos positivos según la enfermedad sea rara o común en la población evaluada. Olvidarlo es caer en el error descrito en tasa base en el diagnóstico.
En ambos usos, la radiografía no confirma nada. Quien tiene una imagen anormal pasa a una prueba bacteriológica, como la prueba molecular rápida en esputo, y es esa prueba la que confirma la enfermedad.
El Módulo 2 de las directrices consolidadas de la OMS sobre tuberculosis, dedicado al rastreo, trajo una recomendación nueva sobre la lectura automatizada (OMS, 2021). En traducción libre, el texto dice que, entre individuos de 15 años o más en poblaciones en las que se recomienda el rastreo de la tuberculosis, los programas de detección asistida por computador pueden usarse en lugar de lectores humanos para interpretar radiografías digitales de tórax en el rastreo y en la triagem de la enfermedad. La propia directriz clasifica la recomendación como condicional, con baja certeza de la evidencia.
Las dos calificaciones tienen peso. Una recomendación condicional significa que el grupo que elaboró la directriz juzgó que los beneficios probablemente superan los riesgos, pero que la decisión depende del contexto, de los recursos y de los valores locales. La baja certeza indica que nuevos estudios pueden cambiar la estimación de efecto.
El grupo de elaboración de la directriz revisó tres evaluaciones independientes de tres productos con marcado CE hasta enero de 2020, y hizo el análisis sin saber cuáles eran las marcas (OMS, 2021). La recomendación vale para radiografías digitales en incidencia posteroanterior o anteroposterior. Quedaron fuera las incidencias lateral y oblicua, y el desempeño en radiografías analógicas digitalizadas es desconocido.
El documento también delimita el objetivo. La exactitud se midió contra la tuberculosis confirmada bacteriológicamente, y el software no detecta otras enfermedades pulmonares además de la tuberculosis; no había datos sobre el desempeño en diagnóstico diferencial (OMS, 2021). Esto separa este tema del hallazgo incidental discutido en nódulo pulmonar incidental y probabilidad: allí la imagen se hizo por otro motivo y el razonamiento parte de la probabilidad de cáncer; aquí la imagen se hace a propósito, en masa, para encontrar una única enfermedad.
Por último, la recomendación se aplica a productos que no se muestren inferiores a los evaluados cuando se prueben en validación externa. La OMS también cita el potencial de ampliar el acceso donde faltan radiólogos, pero condiciona la viabilidad a equipo, conexión de internet y mantenimiento (OMS, 2021).
El grupo comparó el software con lectores humanos usando el mismo patrón de referencia bacteriológico. Para eso, fijó el umbral del software en el punto en que la sensibilidad llegaba a cerca del 90 por ciento y comparó la especificidad obtenida con la de los lectores (OMS, 2021). Ese número viene del perfil de producto objetivo de la OMS, que pide sensibilidad superior a 0,90 y especificidad superior a 0,70 para una prueba de triagem.
| Uso | Lector | Sensibilidad | Especificidad |
|---|---|---|---|
| Perfil de producto objetivo | Meta | superior a 0,90 | superior a 0,70 |
| Rastreo | Software de CAD | 0,90 a 0,92 | 0,23 a 0,66 |
| Rastreo | Lector humano | 0,82 a 0,93 | 0,14 a 0,63 |
| Triagem | Software de CAD | 0,90 a 0,91 | 0,25 a 0,79 |
| Triagem | Lector humano | 0,89 a 0,96 | 0,36 a 0,63 |
Fuentes: OMS, 2021, Módulo 2, tabla 4 del documento; valores expresados como proporciones, intervalos entre estudios, sin estimación agrupada.
La tabla muestra lo que la OMS llamó poca diferencia entre software y lector humano. Los rangos de especificidad son amplios en los dos grupos, y el documento no agrupó las estimaciones en un metaanálisis (OMS, 2021). La conclusión fue de exactitud semejante, y no de superioridad.
Una revisión sistemática anterior ayuda a entender por qué la OMS fue cautelosa (Harris et al., 2019). Los autores reunieron 53 estudios, 40 de desarrollo y 13 de evaluación clínica. La mediana del área bajo la curva fue de 0,88 en los estudios de desarrollo y de 0,75 en los clínicos, y la especificidad en los estudios clínicos varió de 0,23 a 0,69. Los autores no hicieron metaanálisis, por la heterogeneidad y el riesgo de sesgo.
La distancia entre el laboratorio y el mundo real es común en las herramientas de IA. El mismo fenómeno aparece en IA autónoma en el rastreo de la retinopatía diabética, donde la validación prospectiva fue lo que dio credibilidad al uso clínico. Los lectores que quieran una visión más amplia del tema pueden ver el uso de inteligencia artificial en el razonamiento clínico.
Dos evaluaciones independientes pusieron varios programas ante el mismo conjunto de imágenes. En un estudio retrospectivo con 1196 pacientes ambulatorios de Nepal y Camerún, usando la prueba molecular como referencia, tres programas tuvieron áreas bajo la curva de 0,92 a 0,94 (Qin et al., 2019). Los autores estimaron que el software podría reducir en 66 por ciento las pruebas moleculares necesarias manteniendo la sensibilidad en 95 por ciento o más (Qin et al., 2019).
En Vietnam, se usó una biblioteca de 1032 radiografías para comparar 12 programas con un lector especialista y un lector intermedio (Codlin et al., 2021). Seis programas tuvieron un desempeño equivalente al del especialista. Los autores señalan como límites el origen en una única región, el diseño retrospectivo y una muestra inclinada hacia personas con sospecha de tuberculosis.
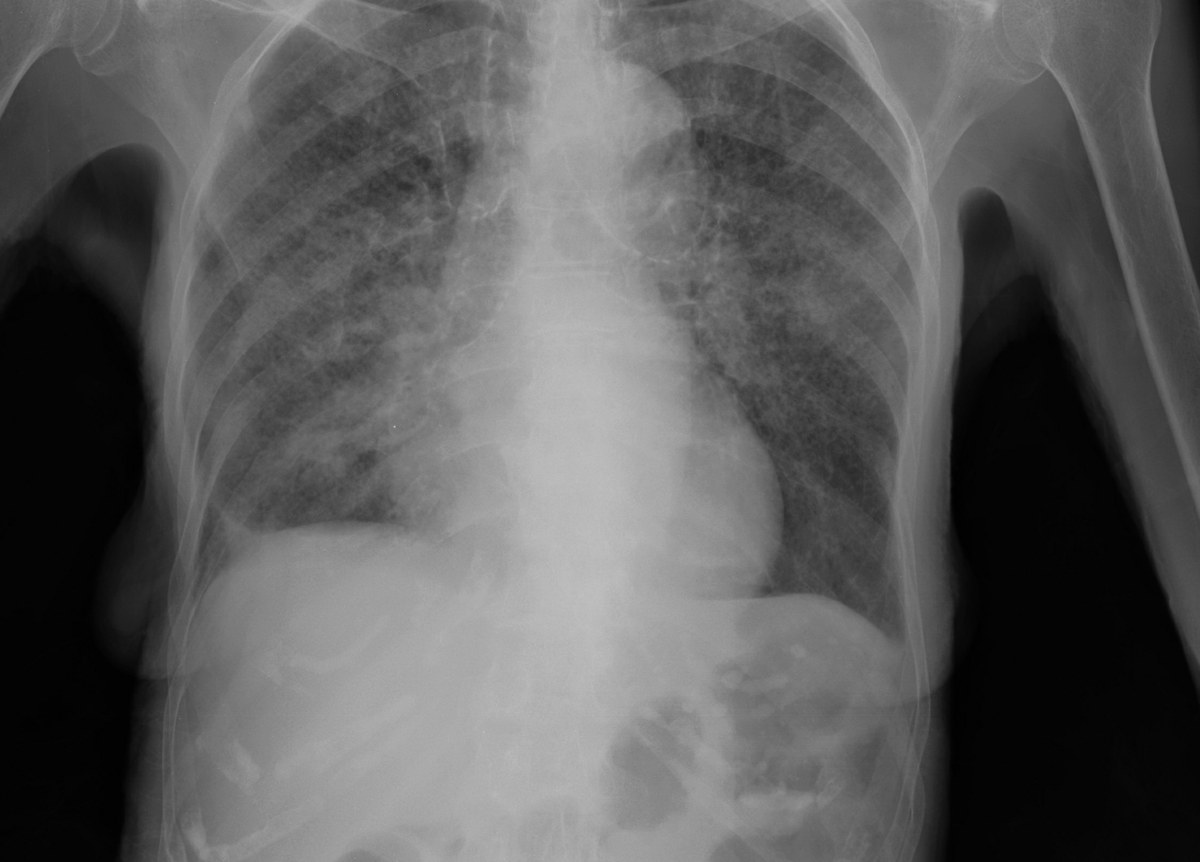
El software no dice "tuberculosis" o "normal". Devuelve una puntuación continua, y alguien debe elegir a partir de qué valor la imagen se tratará como anormal. Un relevamiento cualitativo con usuarios de nueve países de alta carga resume el dilema: subir el umbral hace el software más específico y menos sensible, bajar el umbral hace lo contrario, y ningún umbral es a la vez perfectamente sensible y perfectamente específico (Creswell et al., 2023). El mejor punto es el que equilibra la exactitud con el volumen de exámenes confirmatorios que el servicio puede absorber.
El trabajo de Vanobberghen y colegas es descrito por los autores como un análisis secundario del relevamiento nacional de prevalencia de tuberculosis de Lesoto, de 2019 (Vanobberghen et al., 2024). Participaron 17 070 personas de 15 años o más. Como solo quienes tenían síntomas o radiografía alterada se hicieron la prueba bacteriológica, apenas 5214 participantes tuvieron el estado de tuberculosis determinado, y 142 tenían la enfermedad.
Para abordar a quienes no fueron testados, los autores compararon seis métodos. Con imputación múltiple, el umbral 13 dio sensibilidad de 89,7 por ciento, con intervalo de confianza de 95 por ciento de 84,6 a 94,8, y especificidad de 74,2 por ciento, con intervalo de 73,6 a 74,9 (Vanobberghen et al., 2024). Suponer que todos los no testados eran negativos llevó a resultados parecidos.
| Umbral del software | Sensibilidad (por ciento) | Especificidad (por ciento) |
|---|---|---|
| 3 | 96,5 | 38,1 |
| 5 | 93,7 | 54,2 |
| 8 | 91,5 | 65,5 |
| 10 | 90,1 | 69,7 |
| 13 | 90,1 | 74,2 |
Fuentes: Vanobberghen et al., 2024, tabla 3, enfoque que trata a los no testados como negativos; puntuación de 0 a 100 de una versión específica del software.
Entre los umbrales 13 y 10, la sensibilidad quedó igual y la especificidad cayó. Del umbral 13 al umbral 3, la sensibilidad ganó 6,4 puntos porcentuales, mientras que la especificidad perdió 36,1 puntos. Los autores describen las caídas de especificidad en los umbrales más bajos como sustanciales.
Una cuenta ilustrativa, hecha por nosotros a partir de la tabla 3 de Vanobberghen y colegas, y no por los autores, ayuda a ver el efecto. En 1000 personas sin tuberculosis, una especificidad de 74,2 por ciento deja cerca de 258 imágenes falsamente anormales, mientras que una especificidad de 38,1 por ciento deja cerca de 619, según los valores del estudio (Vanobberghen et al., 2024). Cada una de esas personas necesita recolección de esputo, una prueba molecular y una respuesta, y algunas pueden acabar tratadas sin confirmación, el tipo de exceso discutido en sobrediagnóstico.
El mismo estudio trae un contraste con la lectura humana en campo. La lectura humana de las radiografías en el relevamiento, incorporando la lectura central cuando estaba disponible, tuvo sensibilidad de 47,2 por ciento y especificidad de 96,5 por ciento (Vanobberghen et al., 2024). La lectura humana fue mucho más específica y mucho menos sensible que el software en el umbral elegido.
Los autores enumeran problemas importantes. Faltaban muchas radiografías, más en áreas urbanas, lo que puede comprometer la representatividad; cerca del 19 por ciento de las personas invitadas rechazó el levantamiento, en mayor proporción hombres jóvenes de áreas urbanas (Vanobberghen et al., 2024). La imputación múltiple depende del supuesto de que los datos faltan al azar. Además, la estimación de prevalencia varió de 0,83 a 2,72 por ciento según el método, lo que muestra cuánto depende el resultado de la forma de tratar a los no testados (Vanobberghen et al., 2024). Uno de los autores es de la OMS.
El umbral óptimo de Lesoto no sirve para otros lugares. Los propios autores citan umbrales de 50 en Bangladés y de 20 en Sudáfrica para el mismo tipo de programa y concluyen que el umbral depende del contexto (Vanobberghen et al., 2024). En el estudio de Nepal y de Camerún, el punto de corte de un mismo programa que garantizaba la sensibilidad deseada fue 63 en un país y 48 en el otro, y un umbral universal tuvo un desempeño diferente en cada lugar (Qin et al., 2019).
Los usuarios escuchados por Creswell y colegas relatan que la elección del umbral aún genera controversia entre los formuladores de políticas y que las estrategias usadas fueron diversas y poco estructuradas, y consideran que los estudios de calibración son difíciles de hacer y necesarios de repetir (Creswell et al., 2023). El programa especial de investigación en enfermedades tropicales de la OMS publicó un proceso para orientar esa elección.
La especificidad media oculta grupos en los que el software falla más. El metaanálisis de datos individuales de Tavaziva y colegas reunió a 3727 participantes de cuatro estudios, con cerca del 17 por ciento de personas con VIH y 17 por ciento con tuberculosis confirmada (Tavaziva et al., 2022). Con la sensibilidad agrupada fijada en 90 por ciento, las especificidades de tres programas quedaron entre 54,1 y 60,5 por ciento (Tavaziva et al., 2022).
La mayor caída apareció en quienes ya tuvieron tuberculosis. En el mismo metaanálisis, la especificidad fue de 26,6 a 33,7 por ciento en personas con tratamiento previo y de 58,0 a 69,3 por ciento en las demás (Tavaziva et al., 2022). La sensibilidad también fue menor en la tuberculosis con baciloscopia negativa y, para dos de los productos, en personas con VIH. Los autores concluyen que los umbrales deben definirse a partir de las poblaciones de cada usuario, y reconocen que no estaban disponibles los datos de tres de los siete estudios elegibles y que faltaban datos de CD4.
Un estudio en Lusaka, en Zambia, observó de cerca a este grupo. Los autores describen un análisis retrospectivo de un estudio transversal prospectivo de búsqueda de casos, con 1884 personas sintomáticas de 15 años o más, de las cuales 452, o 24,0 por ciento, tenían tuberculosis previa (Kagujje et al., 2023). Con umbrales fijados para una sensibilidad de 90 por ciento, la especificidad de un programa fue de 24,0 por ciento en quienes tenían tuberculosis previa y de 60,3 por ciento en quienes no la tenían; la de otro fue de 22,2 frente a 61,8 por ciento (Kagujje et al., 2023). El estudio no tuvo comparación con un lector humano, el antecedente de tuberculosis fue autorreportado y el patrón de referencia fue la prueba molecular.
Las cicatrices de una tuberculosis tratada siguen visibles en la radiografía, y el software tiende a leer esas secuelas como enfermedad activa. En la evaluación vietnamita, la mayoría de los programas tuvo un desempeño significativamente peor en personas con tuberculosis previa (Codlin et al., 2021).
En Sudáfrica, una validación externa usó una muestra de casos y controles de 774 personas de 15 años o más, 258 de ellas con tuberculosis, tomada del levantamiento nacional de prevalencia de 2017 a 2019, para probar 12 programas (Qin et al., 2024). Las áreas bajo la curva fueron de cerca de 0,9 en los mejores a menos de 0,8 en los peores, y todos los productos tuvieron peor desempeño en personas mayores, con tuberculosis previa y con VIH. Los autores reconocen que el estudio quedó con poder insuficiente, con 258 personas con tuberculosis frente a 291 necesarias, que parte de los datos era autorreportada y que se excluyeron personas asintomáticas con radiografía normal.
En Lesoto, la sensibilidad varió mucho según el estado de VIH, dependiendo de la puntuación, pero la especificidad casi no cambió (Vanobberghen et al., 2024), lo que muestra cómo varían estos hallazgos entre poblaciones. En la evaluación de Vietnam, el tipo de equipo de radiografía también afectó el desempeño de algunos programas (Codlin et al., 2021).
La lección práctica es que el operador debe saber quién está frente al aparato. Una fila con muchos adultos mayores y muchas personas ya tratadas generará más falsos positivos que una fila de jóvenes sin antecedente de tuberculosis, incluso con el mismo umbral.
El software cambia con el tiempo. En un conjunto de casos y controles de 12 890 radiografías de Bangladesh, el área bajo la curva de un programa subió de 0,823 en una versión a 0,903 en la siguiente, y la de otro pasó de 0,872 a 0,906 (Qin et al., 2022). Las versiones más nuevas alcanzaron el perfil de producto objetivo de la OMS, pero la actualización cambió los umbrales que daban la misma sensibilidad, y los autores recomiendan reevaluar con datos locales. El estudio no usó cultivo, no usó la versión más sensible de la prueba molecular y excluyó a menores de 15 años.
La directriz de la OMS trata la implantación en la sección 4.4 (OMS, 2021). El documento describe una variación sustancial entre sitios incluso con el mismo software y el mismo umbral, y por eso pide calibración local de la puntuación de acuerdo con los objetivos del programa, seguida de monitoreo continuo. Ese monitoreo compara las lecturas del software con las de lectores humanos, con los resultados bacteriológicos y con la proporción de imágenes clasificadas como anormales. Un manual operativo, un protocolo de calibración y una herramienta en internet acompañan la directriz.
Cuando la máquina decide quién sigue a la prueba, el equipo tiende a dejar de mirar las imágenes que llamó normales. Ese riesgo es el tema del sesgo de automatización. La proporción de imágenes anormales es una buena alarma: si sube o baja sin cambio en la población, algo cambió en el aparato, en el software o en el flujo.
El software también altera quién hace qué. En muchos lugares, quien opera el aparato y deriva al paciente es un técnico o agente de salud, y no un médico, un arreglo discutido en transferencia de tareas. En lugares con pocos recursos, la radiografía leída por software convive con otros exámenes simples, como los descritos en diagnóstico con pocos recursos.
Un estudio reciente sugiere que la puntuación puede llevar información más allá del momento del examen. En una cohorte prospectiva de 483 contactos domiciliarios de personas con tuberculosis resistente a la rifampicina en Sudáfrica, seguidos por una mediana de 4,6 años, hubo 23 personas con tuberculosis prevalente y 38 con tuberculosis incidente (Macpherson et al., 2025). El área bajo la curva fue de 0,87 a 0,91 para la enfermedad prevalente y de 0,60 a 0,65 para la incidente. Más del 30 por ciento de las personas por encima del umbral, con esputo de rutina negativo, fueron diagnosticadas después, por la investigación ampliada del esputo o durante el seguimiento (Macpherson et al., 2025). Los autores advierten que los umbrales más bajos probados no tuvieron validación externa y que el estudio se hizo en un escenario de alta carga.
La recomendación de la OMS vale para personas de 15 años o más, y la directriz enumera el software para niños como una laguna de investigación urgente (OMS, 2021). La radiografía infantil es diferente: los ganglios linfáticos del hilio y del mediastino dominan el cuadro, y la imagen cambia con la edad.
El estudio de Palmer y colegas usó radiografías de 620 niños menores de 13 años incluidos en un estudio diagnóstico observacional prospectivo en Ciudad del Cabo, entre 2012 y 2017 (Palmer et al., 2023). Se analizaron 525 imágenes, con un conjunto de prueba de 80, la mitad con tuberculosis y la mitad sin. El patrón de referencia fue la lectura radiológica de un panel de especialistas, y no la confirmación bacteriológica.
La versión para adultos del software tuvo un área bajo la curva de 0,58 en ese conjunto. Tras un ajuste fino con imágenes pediátricas, el área subió a 0,72, una diferencia estadísticamente significativa con p de 0,0016 (Palmer et al., 2023). Aun mejorado, el desempeño quedó lejos del visto en adultos.
Los autores reconocen que el conjunto de datos era pequeño para aprendizaje profundo, que el patrón de referencia dependió de lectura humana y que los especialistas discreparon entre sí en 25 de las 80 imágenes de prueba (Palmer et al., 2023). La población era de niños en investigación diagnóstica, y no de tamizaje. Uno de los coautores pertenece a la empresa que desarrolla el software. El estudio es una prueba de concepto, y no sostiene el uso del software en niños.
El equipo de nuestro caso ficticio tiene ahora preguntas más útiles que "qué número usar". ¿Cuántas pruebas moleculares por día aguanta el laboratorio? ¿Cuál es la prevalencia esperada en esa fila? ¿Cuántas personas ya tuvieron tuberculosis? ¿La versión del software es la misma de los estudios de calibración?
Con esas respuestas, el equipo puede elegir un umbral inicial, registrar la proporción de imágenes anormales y comparar una muestra de lecturas con el radiólogo y con los resultados del esputo. Si la fila tiene muchos adultos tratados en el pasado, debe esperar más falsos positivos y ajustar el flujo. Y debe recordar que los niños pequeños que pasen por la unidad quedan fuera de la recomendación y necesitan evaluación clínica.
En NEXO, el caso del día es ficticio, con presentación clínica real y hasta seis pistas progresivas, y tú propones el diagnóstico buscando el código en la CIE-10. Elegir un umbral exige el mismo ejercicio: pesar la probabilidad antes del examen, preguntar quién está siendo evaluado y decidir qué hacer con un resultado que no cuadra, como en el entrenamiento del diagnóstico diferencial con pistas.
Los límites de uso del juego están descritos en la página de economía de NEXO. Si investigas la enseñanza del razonamiento clínico, la página para Researcher explica cómo entrar en contacto. Los profesionales que escriben o revisan casos encuentran información en Curator y en Creators, y las instituciones pueden conocer la propuesta en la página para alianzas. Buscar el código correcto en la CIE-10 completa ese entrenamiento.
Indica quién debe seguir a una prueba confirmatoria. La OMS evaluó el software contra la tuberculosis confirmada bacteriológicamente, y la confirmación sigue dependiendo de la prueba en el esputo (OMS, 2021).
La OMS la clasifica como condicional, con baja certeza de la evidencia, y restringida a personas de 15 años o más y a radiografías digitales en incidencia frontal (OMS, 2021).
Los estudios muestran umbrales óptimos muy diferentes entre países y entre versiones del mismo programa, y la OMS pide calibración local (Vanobberghen et al., 2024; Qin et al., 2022).
Porque, cerca del punto en que la sensibilidad ya es alta, cada ganancia pequeña de sensibilidad provoca una pérdida grande de especificidad. En Lesoto, ir del umbral 13 al 3 ganó 6,4 puntos de sensibilidad y perdió 36,1 de especificidad (Vanobberghen et al., 2024).
Pueden, pero la especificidad cae mucho en ese grupo, y el servicio debe esperar muchas derivaciones sin enfermedad activa (Tavaziva et al., 2022; Kagujje et al., 2023).
La recomendación de la OMS excluye a los menores de 15 años, y el mejor estudio pediátrico disponible es una prueba de concepto con muestra pequeña (Palmer et al., 2023).