Saúde digital e IAMedicina tropical e de viagemSaúde global
Raio-X de tórax lido por computador na busca da tuberculose
Sumário
- Por que a tuberculose ainda escapa
- O que a OMS recomendou em 2021
- Como a OMS julgou a acurácia
- O limiar: onde o falso positivo nasce
- Quem o software erra mais
- Versões, calibração local e monitoramento
- Crianças ficam fora da recomendação
- Como o NEXO ajuda a treinar esse raciocínio
- Perguntas frequentes
- Take-home messages
- Referências
Num caso fictício, uma equipe móvel chega a um bairro populoso de uma cidade de alta carga de tuberculose. Num só dia, centenas de adultos fazem uma radiografia digital de tórax, e há um único radiologista para toda a região, que só verá as imagens semanas depois. A equipe decide que um software dará a cada imagem uma pontuação de 0 a 100, e quem passar de um certo número será encaminhado para o teste molecular no escarro. A pergunta que divide a equipe é simples de enunciar e difícil de responder: qual número usar?
A detecção assistida por computador, conhecida pela sigla em inglês CAD, entrou na recomendação da Organização Mundial da Saúde (OMS) em 2021 como alternativa ao leitor humano no rastreio e na triagem da tuberculose. A própria OMS, porém, insiste que o ponto de corte precisa ser calibrado para cada contexto, porque o mesmo software, com o mesmo limiar, se comporta de forma diferente em populações diferentes.
Este texto mostra o que a OMS recomendou e com que força, como os estudos medem a acurácia desses programas, o que acontece com os falsos positivos quando o limiar desce e quais grupos o software tende a errar mais.
Principais pontos
- A OMS recomenda que, em pessoas de 15 anos ou mais, o software de CAD pode substituir o leitor humano na interpretação da radiografia digital de tórax para rastreio e triagem da tuberculose, numa recomendação condicional com baixa certeza da evidência (OMS, 2021).
- Num levantamento nacional de prevalência no Lesoto, baixar o limiar de 13 para 3 elevou a sensibilidade de 90,1 para 96,5 por cento e derrubou a especificidade de 74,2 para 38,1 por cento (Vanobberghen et al., 2024).
- Numa meta-análise de dados individuais, a especificidade com sensibilidade fixada em 90 por cento caiu para 26,6 a 33,7 por cento em pessoas com tuberculose prévia (Tavaziva et al., 2022).
- Em crianças sul-africanas, um software treinado em adultos teve área sob a curva de 0,58, e a OMS não estendeu a recomendação a menores de 15 anos (Palmer et al., 2023).
- A OMS pede calibração local do limiar e monitoramento contínuo depois da implantação (OMS, 2021).
- Por que a tuberculose ainda escapa
- O que a OMS recomendou em 2021
- Como a OMS julgou a acurácia
- O limiar: onde o falso positivo nasce
- Quem o software erra mais
- Versões, calibração local e monitoramento
- Crianças ficam fora da recomendação
- Como o NEXO ajuda a treinar esse raciocínio
- Perguntas frequentes
- Take-home messages
Por que a tuberculose ainda escapa
A tuberculose é a principal causa de morte por um único agente infeccioso, e em 2024 matou 1,23 milhão de pessoas, das quais 150 000 viviam com HIV, segundo a ficha informativa da OMS (OMS, 2026). No mesmo ano, 10,7 milhões de pessoas adoeceram: 5,8 milhões de homens, 3,7 milhões de mulheres e 1,2 milhão de crianças.
A doença se concentra onde há menos recursos. Mais de 80 por cento dos adoecimentos e das mortes ocorrem em países de baixa e média renda, e as regiões do Sudeste Asiático, do Pacífico Ocidental e da África somam a maior parte da carga (OMS, 2026). Viajantes e profissionais que atendem pessoas vindas dessas regiões encontram a mesma pergunta diagnóstica em outro cenário.
O problema central é a lacuna entre quem adoece e quem é diagnosticado. No documento de 2021, a OMS lembra que, em 2019, cerca de 2,9 milhões das 10 milhões de pessoas com tuberculose não foram diagnosticadas ou não foram notificadas (OMS, 2021). Parte dessas pessoas tem poucos sintomas ou nenhum, e só aparece quando alguém vai procurá-la ativamente.
Rastreio e triagem não são a mesma coisa
A OMS separa dois usos da radiografia (OMS, 2021). No rastreio, a radiografia é oferecida a uma população em risco, com ou sem sintomas, e a prevalência de tuberculose costuma ficar abaixo de 5 por cento (OMS, 2021). Na triagem, a radiografia é feita em pessoas que já procuraram o serviço com sintomas, e a prevalência fica em geral entre 10 e 20 por cento, segundo o mesmo documento (OMS, 2021).
Essa diferença de prevalência importa muito. Como discutido em probabilidade pré-teste, o mesmo teste, com a mesma sensibilidade e especificidade, produz proporções muito diferentes de falsos positivos conforme a doença é rara ou comum na população testada. Esquecer isso é cair no erro descrito em taxa básica no diagnóstico.
Nos dois usos, a radiografia não confirma nada. Quem tem imagem anormal segue para um teste bacteriológico, como o teste molecular rápido no escarro, e é esse teste que confirma a doença.
O que a OMS recomendou em 2021
O Módulo 2 das diretrizes consolidadas da OMS sobre tuberculose, dedicado ao rastreamento, trouxe uma recomendação nova sobre a leitura automatizada (OMS, 2021). Em tradução livre, o texto diz que, entre indivíduos de 15 anos ou mais em populações nas quais o rastreio da tuberculose é recomendado, programas de detecção assistida por computador podem ser usados no lugar de leitores humanos para interpretar radiografias digitais de tórax no rastreio e na triagem da doença. A própria diretriz classifica a recomendação como condicional, com baixa certeza da evidência.
As duas qualificações têm peso. Uma recomendação condicional significa que o grupo que elaborou a diretriz julgou que os benefícios provavelmente superam os riscos, mas que a decisão depende do contexto, dos recursos e dos valores locais. A baixa certeza indica que novos estudos podem mudar a estimativa de efeito.
O que estava dentro e o que ficou fora
O grupo de elaboração da diretriz revisou três avaliações independentes de três produtos com marcação CE até janeiro de 2020, e fez a análise sem saber quais eram as marcas (OMS, 2021). A recomendação vale para radiografias digitais em incidência posteroanterior ou anteroposterior. Ficaram fora as incidências lateral e oblíqua, e o desempenho em radiografias analógicas digitalizadas é desconhecido.
O documento também delimita o alvo. A acurácia foi medida contra a tuberculose confirmada bacteriologicamente, e o software não detecta outras doenças pulmonares além da tuberculose; não havia dados sobre o desempenho em diagnóstico diferencial (OMS, 2021). Isso separa este tema do achado incidental discutido em nódulo pulmonar incidental e probabilidade: lá a imagem foi feita por outro motivo e o raciocínio parte da probabilidade de câncer; aqui a imagem é feita de propósito, em massa, para encontrar uma única doença.
Por fim, a recomendação se aplica a produtos que não se mostrem inferiores aos avaliados quando testados em validação externa. A OMS também cita o potencial de ampliar o acesso onde faltam radiologistas, mas condiciona a viabilidade a equipamento, conexão de internet e manutenção (OMS, 2021).
Como a OMS julgou a acurácia
O grupo comparou o software com leitores humanos usando o mesmo padrão de referência bacteriológico. Para isso, fixou o limiar do software no ponto em que a sensibilidade chegava a cerca de 90 por cento e comparou a especificidade obtida com a dos leitores (OMS, 2021). Esse número vem do perfil de produto alvo da OMS, que pede sensibilidade acima de 0,90 e especificidade acima de 0,70 para um teste de triagem.
| Uso | Leitor | Sensibilidade | Especificidade |
|---|---|---|---|
| Perfil de produto alvo | Meta | acima de 0,90 | acima de 0,70 |
| Rastreio | Software de CAD | 0,90 a 0,92 | 0,23 a 0,66 |
| Rastreio | Leitor humano | 0,82 a 0,93 | 0,14 a 0,63 |
| Triagem | Software de CAD | 0,90 a 0,91 | 0,25 a 0,79 |
| Triagem | Leitor humano | 0,89 a 0,96 | 0,36 a 0,63 |
Fontes: OMS, 2021, Módulo 2, tabela 4 do documento; valores expressos como proporções, intervalos entre estudos, sem estimativa agrupada.
A tabela mostra o que a OMS chamou de pouca diferença entre software e leitor humano. As faixas de especificidade são largas nos dois grupos, e o documento não agrupou as estimativas numa meta-análise (OMS, 2021). A conclusão foi de acurácia semelhante, e não de superioridade.
Desenvolvimento e prática dão números diferentes
Uma revisão sistemática anterior ajuda a entender por que a OMS foi cautelosa (Harris et al., 2019). Os autores reuniram 53 estudos, 40 de desenvolvimento e 13 de avaliação clínica. A mediana da área sob a curva foi de 0,88 nos estudos de desenvolvimento e de 0,75 nos clínicos, e a especificidade nos estudos clínicos variou de 0,23 a 0,69. Os autores não fizeram meta-análise, por causa da heterogeneidade e do risco de viés.
A distância entre o laboratório e o mundo real é comum em ferramentas de IA. O mesmo fenômeno aparece em IA autônoma no rastreio da retinopatia diabética, onde a validação prospectiva foi o que deu credibilidade ao uso clínico. Leitores que queiram uma visão mais ampla do tema podem ver o uso de inteligência artificial no raciocínio clínico.
Produtos lado a lado
Duas avaliações independentes colocaram vários programas diante do mesmo conjunto de imagens. Num estudo retrospectivo com 1196 pacientes ambulatoriais do Nepal e de Camarões, usando o teste molecular como referência, três programas tiveram áreas sob a curva de 0,92 a 0,94 (Qin et al., 2019). Os autores estimaram que o software poderia reduzir em 66 por cento os testes moleculares necessários mantendo a sensibilidade em 95 por cento ou mais (Qin et al., 2019).
No Vietnã, uma biblioteca de 1032 radiografias foi usada para comparar 12 programas com um leitor especialista e um leitor intermediário (Codlin et al., 2021). Seis programas tiveram desempenho equivalente ao do especialista. Os autores apontam como limites a origem numa única região, o desenho retrospectivo e uma amostra inclinada para pessoas com suspeita de tuberculose.
O limiar: onde o falso positivo nasce
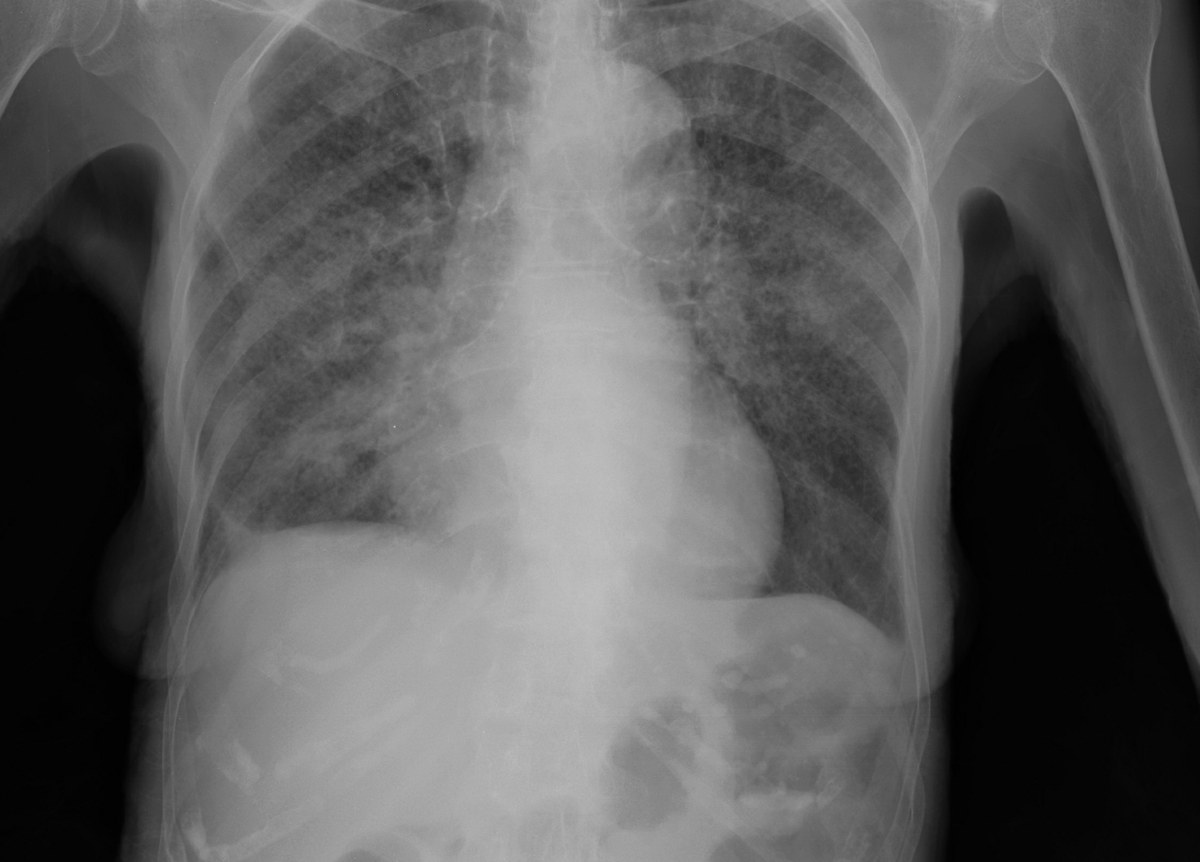
O software não diz "tuberculose" ou "normal". Ele devolve uma pontuação contínua, e alguém precisa escolher a partir de que valor a imagem será tratada como anormal. Um levantamento qualitativo com usuários de nove países de alta carga resume o dilema: subir o limiar torna o software mais específico e menos sensível, baixar o limiar faz o contrário, e nenhum limiar é ao mesmo tempo perfeitamente sensível e perfeitamente específico (Creswell et al., 2023). O melhor ponto é o que equilibra a acurácia com o volume de exames confirmatórios que o serviço consegue absorver.
O estudo do Lesoto
O trabalho de Vanobberghen e colegas é descrito pelos autores como uma análise secundária do levantamento nacional de prevalência de tuberculose do Lesoto, de 2019 (Vanobberghen et al., 2024). Participaram 17 070 pessoas de 15 anos ou mais. Como só quem tinha sintomas ou radiografia alterada fez o teste bacteriológico, apenas 5214 participantes tiveram o estado de tuberculose determinado, e 142 tinham a doença.
Para lidar com quem não foi testado, os autores compararam seis métodos. Com imputação múltipla, o limiar 13 deu sensibilidade de 89,7 por cento, com intervalo de confiança de 95 por cento de 84,6 a 94,8, e especificidade de 74,2 por cento, com intervalo de 73,6 a 74,9 (Vanobberghen et al., 2024). Supor que todos os não testados eram negativos levou a resultados parecidos.
| Limiar do software | Sensibilidade (por cento) | Especificidade (por cento) |
|---|---|---|
| 3 | 96,5 | 38,1 |
| 5 | 93,7 | 54,2 |
| 8 | 91,5 | 65,5 |
| 10 | 90,1 | 69,7 |
| 13 | 90,1 | 74,2 |
Fontes: Vanobberghen et al., 2024, tabela 3, abordagem que trata os não testados como negativos; pontuação de 0 a 100 de uma versão específica do software.
Entre os limiares 13 e 10, a sensibilidade ficou igual e a especificidade caiu. Do limiar 13 ao limiar 3, a sensibilidade ganhou 6,4 pontos percentuais, enquanto a especificidade perdeu 36,1 pontos. Os autores descrevem as quedas de especificidade nos limiares mais baixos como substanciais.
Uma conta ilustrativa, feita por nós a partir da tabela 3 de Vanobberghen e colegas, e não pelos autores, ajuda a ver o efeito. Em 1000 pessoas sem tuberculose, uma especificidade de 74,2 por cento deixa cerca de 258 imagens falsamente anormais, enquanto uma especificidade de 38,1 por cento deixa cerca de 619, segundo os valores do estudo (Vanobberghen et al., 2024). Cada uma dessas pessoas precisa de coleta de escarro, de um teste molecular e de uma resposta, e algumas podem acabar tratadas sem confirmação, o tipo de excesso discutido em sobrediagnóstico.
O mesmo estudo traz um contraste com a leitura humana em campo. A leitura humana das radiografias no levantamento, incorporando a leitura central quando disponível, teve sensibilidade de 47,2 por cento e especificidade de 96,5 por cento (Vanobberghen et al., 2024). A leitura humana foi muito mais específico e muito menos sensível que o software no limiar escolhido.
Os limites da amostra do Lesoto
Os autores listam problemas importantes. Muitas radiografias estavam faltando, mais em áreas urbanas, o que pode comprometer a representatividade; cerca de 19 por cento das pessoas convidadas recusaram o levantamento, em maior proporção homens jovens de áreas urbanas (Vanobberghen et al., 2024). A imputação múltipla depende da suposição de que os dados faltam ao acaso. Além disso, a estimativa de prevalência variou de 0,83 a 2,72 por cento conforme o método, o que mostra o quanto o resultado depende da forma de tratar os não testados (Vanobberghen et al., 2024). Um dos autores é da OMS.
O mesmo software, outro país, outro número
O limiar ótimo do Lesoto não serve para outros lugares. Os próprios autores citam limiares de 50 em Bangladesh e de 20 na África do Sul para o mesmo tipo de programa e concluem que o limiar depende do contexto (Vanobberghen et al., 2024). No estudo do Nepal e de Camarões, o ponto de corte de um mesmo programa que garantia a sensibilidade desejada foi 63 num país e 48 no outro, e um limiar universal teve desempenho diferente em cada local (Qin et al., 2019).
Os usuários ouvidos por Creswell e colegas relatam que a escolha do limiar ainda gera controvérsia entre formuladores de políticas e que as estratégias usadas foram diversas e pouco estruturadas, e consideram os estudos de calibração difíceis de fazer e necessários de repetir (Creswell et al., 2023). O programa especial de pesquisa em doenças tropicais da OMS publicou um processo para orientar essa escolha.
Quem o software erra mais
A especificidade média esconde grupos em que o software falha mais. A meta-análise de dados individuais de Tavaziva e colegas reuniu 3727 participantes de quatro estudos, com cerca de 17 por cento de pessoas com HIV e 17 por cento com tuberculose confirmada (Tavaziva et al., 2022). Com a sensibilidade agrupada fixada em 90 por cento, as especificidades de três programas ficaram entre 54,1 e 60,5 por cento (Tavaziva et al., 2022).
Tuberculose prévia
O maior tombo apareceu em quem já teve tuberculose. Na mesma meta-análise, a especificidade foi de 26,6 a 33,7 por cento em pessoas com tratamento anterior e de 58,0 a 69,3 por cento nas demais (Tavaziva et al., 2022). A sensibilidade também foi menor na tuberculose com baciloscopia negativa e, para dois dos produtos, em pessoas com HIV. Os autores concluem que os limiares devem ser definidos a partir das populações de cada usuário, e reconhecem que dados de três dos sete estudos elegíveis não estavam disponíveis e que faltavam dados de CD4.
Um estudo em Lusaka, na Zâmbia, olhou esse grupo de perto. Os autores descrevem uma análise retrospectiva de um estudo transversal prospectivo de busca de casos, com 1884 pessoas sintomáticas de 15 anos ou mais, das quais 452, ou 24,0 por cento, tinham tuberculose prévia (Kagujje et al., 2023). Com limiares fixados para sensibilidade de 90 por cento, a especificidade de um programa foi de 24,0 por cento em quem tinha tuberculose prévia e de 60,3 por cento em quem não tinha; a de outro foi de 22,2 contra 61,8 por cento (Kagujje et al., 2023). O estudo não teve comparação com leitor humano, o histórico de tuberculose foi autorrelatado e o padrão de referência foi o teste molecular.
As cicatrizes de uma tuberculose tratada continuam visíveis na radiografia, e o software tende a ler essas sequelas como doença ativa. Na avaliação vietnamita, a maioria dos programas teve desempenho significativamente pior em pessoas com tuberculose prévia (Codlin et al., 2021).
Idade, HIV e equipamento
Na África do Sul, uma validação externa usou uma amostra de caso e controle de 774 pessoas de 15 anos ou mais, 258 delas com tuberculose, tirada do levantamento nacional de prevalência de 2017 a 2019, para testar 12 programas (Qin et al., 2024). As áreas sob a curva foram de cerca de 0,9 nos melhores a menos de 0,8 nos piores, e todos os produtos tiveram pior desempenho em pessoas mais velhas, com tuberculose prévia e com HIV. Os autores reconhecem que o estudo ficou com poder insuficiente, com 258 pessoas com tuberculose diante de 291 necessárias, que parte dos dados era autorrelatada e que pessoas assintomáticas com radiografia normal foram excluídas.
No Lesoto, a sensibilidade variou muito conforme o estado de HIV, dependendo da pontuação, mas a especificidade quase não mudou (Vanobberghen et al., 2024), o que mostra como esses achados variam entre populações. Na avaliação do Vietnã, o tipo de equipamento de radiografia também afetou o desempenho de alguns programas (Codlin et al., 2021).
A lição prática é que o operador precisa saber quem está diante do aparelho. Uma fila com muitos adultos mais velhos e muitas pessoas já tratadas vai gerar mais falsos positivos que uma fila de jovens sem passado de tuberculose, mesmo com o mesmo limiar.
Versões, calibração local e monitoramento
O software muda com o tempo. Num conjunto de caso e controle de 12 890 radiografias de Bangladesh, a área sob a curva de um programa subiu de 0,823 numa versão para 0,903 na seguinte, e a de outro foi de 0,872 para 0,906 (Qin et al., 2022). As versões mais novas atingiram o perfil de produto alvo da OMS, mas a atualização mudou os limiares que davam a mesma sensibilidade, e os autores recomendam reavaliar com dados locais. O estudo não usou cultura, não usou a versão mais sensível do teste molecular e excluiu menores de 15 anos.
A diretriz da OMS trata a implantação na seção 4.4 (OMS, 2021). O documento descreve variação substancial entre locais mesmo com o mesmo software e o mesmo limiar, e por isso pede calibração local da pontuação de acordo com os objetivos do programa, seguida de monitoramento contínuo. Esse monitoramento compara as leituras do software com as de leitores humanos, com os resultados bacteriológicos e com a proporção de imagens classificadas como anormais. Um manual operacional, um protocolo de calibração e uma ferramenta na internet acompanham a diretriz.
Por que vigiar o software
Quando a máquina decide quem segue para o teste, a equipe tende a deixar de olhar as imagens que ela chamou de normais. Esse risco é o tema de viés de automação. A proporção de imagens anormais é um bom alarme: se ela subir ou cair sem mudança na população, algo mudou no aparelho, no software ou no fluxo.
O software também altera quem faz o quê. Em muitos lugares, quem opera o aparelho e encaminha o paciente é um técnico ou agente de saúde, e não um médico, um arranjo discutido em transferência de tarefas. Em locais com poucos recursos, a radiografia lida por software convive com outros exames simples, como os descritos em diagnóstico com poucos recursos.
Uma pontuação alta com escarro negativo
Um estudo recente sugere que a pontuação pode carregar informação além do momento do exame. Numa coorte prospectiva de 483 contatos domiciliares de pessoas com tuberculose resistente à rifampicina na África do Sul, seguidos por uma mediana de 4,6 anos, houve 23 pessoas com tuberculose prevalente e 38 com tuberculose incidente (Macpherson et al., 2025). A área sob a curva foi de 0,87 a 0,91 para a doença prevalente e de 0,60 a 0,65 para a incidente. Mais de 30 por cento das pessoas acima do limiar, com escarro de rotina negativo, foram diagnosticadas depois, pela investigação ampliada do escarro ou durante o seguimento (Macpherson et al., 2025). Os autores alertam que os limiares mais baixos testados não tiveram validação externa e que o estudo foi feito num cenário de alta carga.
Crianças ficam fora da recomendação
A recomendação da OMS vale para pessoas de 15 anos ou mais, e a diretriz lista o software para crianças como uma lacuna de pesquisa urgente (OMS, 2021). A radiografia infantil é diferente: os linfonodos do hilo e do mediastino dominam o quadro, e a imagem muda com a idade.
O estudo de Palmer e colegas usou radiografias de 620 crianças menores de 13 anos incluídas num estudo diagnóstico observacional prospectivo na Cidade do Cabo, entre 2012 e 2017 (Palmer et al., 2023). Foram analisadas 525 imagens, com um conjunto de teste de 80, metade com tuberculose e metade sem. O padrão de referência foi a leitura radiológica de um painel de especialistas, e não a confirmação bacteriológica.
A versão para adultos do software teve área sob a curva de 0,58 nesse conjunto. Depois de um ajuste fino com imagens pediátricas, a área subiu para 0,72, uma diferença estatisticamente significativa com p de 0,0016 (Palmer et al., 2023). Mesmo melhorado, o desempenho ficou longe do visto em adultos.
Os limites da amostra pediátrica
Os autores reconhecem que o conjunto de dados era pequeno para aprendizado profundo, que o padrão de referência dependeu de leitura humana e que os especialistas discordaram entre si em 25 das 80 imagens de teste (Palmer et al., 2023). A população era de crianças em investigação diagnóstica, e não de rastreio. Um dos coautores pertence à empresa que desenvolve o software. O estudo é uma prova de conceito, e não sustenta o uso do software em crianças.
Voltando ao caso
A equipe do nosso caso fictício tem agora perguntas mais úteis que "qual número usar". Quantos testes moleculares por dia o laboratório aguenta? Qual a prevalência esperada nessa fila? Quantas pessoas já tiveram tuberculose? A versão do software é a mesma dos estudos de calibração?
Com essas respostas, a equipe pode escolher um limiar inicial, registrar a proporção de imagens anormais e comparar uma amostra de leituras com o radiologista e com os resultados do escarro. Se a fila tiver muitos adultos tratados no passado, ela deve esperar mais falsos positivos e ajustar o fluxo. E deve lembrar que crianças pequenas que passarem pela unidade ficam fora da recomendação e precisam de avaliação clínica.
Como o NEXO ajuda a treinar esse raciocínio
No NEXO, o caso do dia é fictício, com apresentação clínica real e até seis pistas progressivas, e você propõe o diagnóstico buscando o código na CID-10. Escolher um limiar exige o mesmo exercício: pesar a probabilidade antes do exame, perguntar quem está sendo testado e decidir o que fazer com um resultado que não fecha, como no treino do diagnóstico diferencial com pistas.
Os limites de uso do jogo estão descritos na página de economia do NEXO. Se você pesquisa ensino de raciocínio clínico, a página para pesquisadores explica como entrar em contato. Profissionais que escrevem ou revisam casos encontram informações em curadoria e em criadores, e instituições podem conhecer a proposta na página para parcerias. Buscar o código certo na CID-10 completa esse treino.
Perguntas frequentes
O software de CAD diagnostica tuberculose?
Ele indica quem deve seguir para um teste confirmatório. A OMS avaliou o software contra a tuberculose confirmada bacteriologicamente, e a confirmação continua dependendo do teste no escarro (OMS, 2021).
A recomendação da OMS é forte?
A OMS a classifica como condicional, com baixa certeza da evidência, e restrita a pessoas de 15 anos ou mais e a radiografias digitais em incidência frontal (OMS, 2021).
Existe um limiar certo para todos os lugares?
Os estudos mostram limiares ótimos muito diferentes entre países e entre versões do mesmo programa, e a OMS pede calibração local (Vanobberghen et al., 2024; Qin et al., 2022).
Por que baixar o limiar aumenta tanto os falsos positivos?
Porque, perto do ponto em que a sensibilidade já é alta, cada ganho pequeno de sensibilidade provoca uma perda grande de especificidade. No Lesoto, ir do limiar 13 ao 3 ganhou 6,4 pontos de sensibilidade e perdeu 36,1 de especificidade (Vanobberghen et al., 2024).
Quem já teve tuberculose pode ser rastreado com o software?
Pode, mas a especificidade cai muito nesse grupo, e o serviço deve esperar muitos encaminhamentos sem doença ativa (Tavaziva et al., 2022; Kagujje et al., 2023).
O software serve para crianças?
A recomendação da OMS exclui menores de 15 anos, e o melhor estudo pediátrico disponível é uma prova de conceito com amostra pequena (Palmer et al., 2023).
Take-home messages
- A OMS aceitou o software de CAD no lugar do leitor humano para rastreio e triagem da tuberculose em pessoas de 15 anos ou mais, numa recomendação condicional com baixa certeza da evidência.
- A acurácia foi julgada semelhante à do leitor humano, e não superior.
- O limiar define o equilíbrio entre sensibilidade e especificidade; descer o limiar multiplica os falsos positivos e a demanda por testes confirmatórios.
- O limiar ótimo muda entre países, populações e versões do software, e precisa de calibração local e monitoramento.
- Pessoas com tuberculose prévia, mais velhas e, em alguns estudos, com HIV geram mais erros.
- Crianças ficam fora da recomendação, e os dados pediátricos ainda são preliminares.
Referências
- World Health Organization. WHO consolidated guidelines on tuberculosis. Module 2: screening. Systematic screening for tuberculosis disease. Genebra: WHO; 2021. ISBN 978-92-4-002267-6. [Texto integral](https://iris.who.int/handle/10665/340255).
- World Health Organization. Tuberculosis. Ficha informativa, 24 de março de 2026. [Texto integral](https://www.who.int/news-room/fact-sheets/detail/tuberculosis).
- Vanobberghen F, Keter AK, Jacobs BKM, et al. Computer-aided detection thresholds for digital chest radiography interpretation in tuberculosis diagnostic algorithms. ERJ Open Res. 2024;10(1):00508-2023. [PubMed](https://pubmed.ncbi.nlm.nih.gov/38196890/).
- Palmer M, Seddon JA, van der Zalm MM, et al. Optimising computer aided detection to identify intra-thoracic tuberculosis on chest x-ray in South African children. PLOS Glob Public Health. 2023;3(5):e0001799. [PubMed](https://pubmed.ncbi.nlm.nih.gov/37192175/).
- Qin ZZ, Sander MS, Rai B, et al. Using artificial intelligence to read chest radiographs for tuberculosis detection: a multi-site evaluation of the diagnostic accuracy of three deep learning systems. Sci Rep. 2019;9:15000. [PubMed](https://pubmed.ncbi.nlm.nih.gov/31628424/).
- Codlin AJ, Dao TP, Vo LNQ, et al. Independent evaluation of 12 artificial intelligence solutions for the detection of tuberculosis. Sci Rep. 2021;11:23895. [PubMed](https://pubmed.ncbi.nlm.nih.gov/34903808/).
- Tavaziva G, Harris M, Abidi SK, et al. Chest X-ray analysis with deep learning-based software as a triage test for pulmonary tuberculosis: an individual patient data meta-analysis of diagnostic accuracy. Clin Infect Dis. 2022;74(8):1390-400. [PubMed](https://pubmed.ncbi.nlm.nih.gov/34286831/).
- Qin ZZ, Van der Walt M, Moyo S, et al. Computer-aided detection of tuberculosis from chest radiographs in a tuberculosis prevalence survey in South Africa: external validation and modelled impacts of commercially available artificial intelligence software. Lancet Digit Health. 2024;6(9):e605-13. [PubMed](https://pubmed.ncbi.nlm.nih.gov/39033067/).
- Qin ZZ, Barrett R, Ahmed S, et al. Comparing different versions of computer-aided detection products when reading chest X-rays for tuberculosis. PLOS Digit Health. 2022;1(6):e0000067. [PubMed](https://pubmed.ncbi.nlm.nih.gov/36812562/).
- Kagujje M, Kerkhoff AD, Nteeni M, et al. The performance of computer-aided detection digital chest X-ray reading technologies for triage of active tuberculosis among persons with a history of previous tuberculosis. Clin Infect Dis. 2023;76(3):e894-901. [PubMed](https://pubmed.ncbi.nlm.nih.gov/36004409/).
- Creswell J, Vo LNQ, Qin ZZ, et al. Early user perspectives on using computer-aided detection software for interpreting chest X-ray images to enhance access and quality of care for persons with tuberculosis. BMC Glob Public Health. 2023;1:30. [PubMed](https://pubmed.ncbi.nlm.nih.gov/39681961/).
- Harris M, Qi A, Jeagal L, et al. A systematic review of the diagnostic accuracy of artificial intelligence-based computer programs to analyze chest x-rays for pulmonary tuberculosis. PLoS One. 2019;14(9):e0221339. [PubMed](https://pubmed.ncbi.nlm.nih.gov/31479448/).
- Macpherson L, Kik SV, Quartagno M, et al. Diagnostic accuracy of chest X-ray computer-aided detection software for detection of prevalent and incident tuberculosis in household contacts. Clin Infect Dis. 2025. [PubMed](https://pubmed.ncbi.nlm.nih.gov/39692469/).