Saúde digital e IAVieses e erro diagnósticoRaciocínio clínico
IA na dermatologia: o desempenho cai em pele escura
Sumário
- Por que a IA de pele virou promessa e risco
- O que o Diverse Dermatology Images mediu
- Transparência dos conjuntos de dados
- Ajuste fino e o que muda com dados diversos
- Checklist CLEAR Derm e o que pedir ao fornecedor
- O que muda na decisão clínica
- Estudos em resumo
- Como o NEXO ajuda a treinar esse raciocínio
- Perguntas frequentes
- Take-home messages
- Referências
Num atendimento fictício, uma clínica de pele testa um aplicativo que classifica fotos de lesões em benignas ou malignas. O algoritmo acerta com frequência nas imagens claras do banco de demonstração. Na mesma semana, três pacientes com tom de pele escuro trazem fotos de manchas e nódulos: o aplicativo devolve escores baixos de confiança ou sugere benignidade em lesões que o dermatologista considera suspeitas. A equipe pergunta se o problema é a foto, o aparelho ou o modelo.
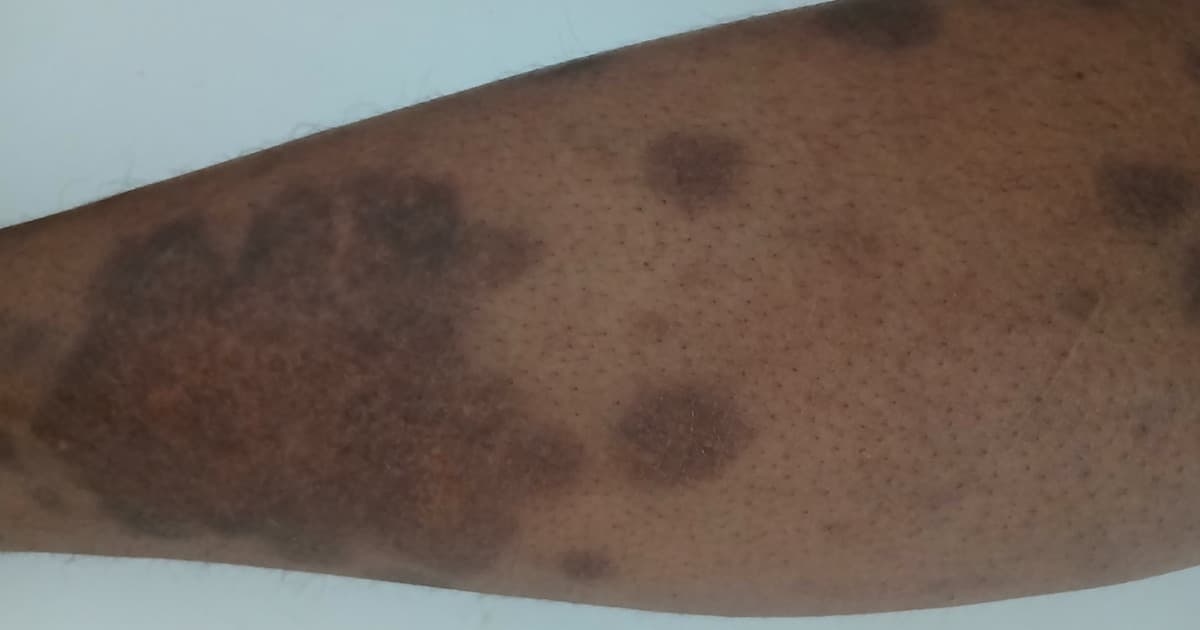
Esse cenário resume o que estudos recentes mediram: classificadores de imagens de pele, treinados em bancos pouco diversos, perdem desempenho em tons escuros e em doenças menos comuns. Este texto reúne o que a literatura mostra sobre essa queda, por que os conjuntos de dados falham na transparência e o que o clínico pode perguntar antes de confiar no resultado. Em cada parte, o texto informa o desenho e o tamanho dos estudos e separa o que foi medido do que é inferência nossa.
Principais pontos
- No conjunto Diverse Dermatology Images, três algoritmos de ponta tiveram área sob a curva ROC entre 0,56 e 0,67, bem abaixo do desempenho reportado nos próprios testes (Daneshjou et al., 2022).
- A sensibilidade caiu de forma acentuada em Fitzpatrick V-VI: ModelDerm de 0,41 para 0,12 e DeepDerm de 0,69 para 0,23 (Daneshjou et al., 2022).
- Em 70 estudos de IA em dermatologia, só 24,2 por cento das imagens eram públicas, 20 por cento descreviam raça ou etnia e 10 por cento citavam tom de pele (Daneshjou et al., 2021).
- O ajuste fino com imagens diversas fechou a lacuna entre tons claros e escuros no DeepDerm e no modelo treinado em HAM10000 (Daneshjou et al., 2022).
- Dermatologistas também erraram mais em tons escuros e em doenças incomuns, o que importa porque eles rotulam muitos bancos de treino (Daneshjou et al., 2022).
- Por que a IA de pele virou promessa e risco
- O que o Diverse Dermatology Images mediu
- Transparência dos conjuntos de dados
- Ajuste fino e o que muda com dados diversos
- Checklist CLEAR Derm e o que pedir ao fornecedor
- O que muda na decisão clínica
- Estudos em resumo
- Como o NEXO ajuda a treinar esse raciocínio
- Perguntas frequentes
- Take-home messages
Por que a IA de pele virou promessa e risco
A classificação automática de lesões cutâneas ganhou atenção depois que redes neurais profundas igualaram dermatologistas em tarefas de melanoma e carcinoma em bancos grandes (Esteva et al., 2017). O estudo de Stanford treinou com 129.450 imagens e testou em 2.032 imagens com biópsia, com desempenho próximo ao de 21 dermatologistas certificados (Esteva et al., 2017).
O salto de 2017 e o alerta de 2018
Esse marco acelerou aplicativos, teledermatologia e esperança de triagem em atenção primária. No ano seguinte, Adamson e Smith alertaram que modelos treinados em dados pouco representativos podem amplificar disparidades se forem implantados sem medir o desempenho por subgrupo (Adamson e Smith, 2018). O aviso antecipou o que o Diverse Dermatology Images (DDI) mediu com números anos depois.
A promessa continua válida para lesões comuns em bancos equilibrados, mas a pergunta clínica deixou de ser "o algoritmo acerta?" e passou a ser "em quem ele acerta?". Essa mudança de pergunta dialoga com o uso de inteligência artificial no raciocínio clínico e com o risco de confiar demais na máquina.
O que o Diverse Dermatology Images mediu
O DDI foi criado para testar algoritmos em imagens clinicamente confirmadas, com tons de pele diversos e doenças comuns e incomuns (Daneshjou et al., 2022). Depois da exclusão de fotos que não passaram no controle de qualidade, restaram 656 imagens, balanceadas entre benignas e malignas nos extremos de Fitzpatrick (Daneshjou et al., 2022).
Composição do conjunto
Havia 208 imagens de Fitzpatrick I-II (159 benignas e 49 malignas), 241 de III-IV e 207 de V-VI (159 benignas e 48 malignas) (Daneshjou et al., 2022). Os subconjuntos dos extremos foram pareados por classe diagnóstica para a comparação entre tons claros e escuros.
Desempenho dos três algoritmos
No DDI completo, ModelDerm teve área sob a curva ROC de 0,65 (IC 95 por cento de 0,61 a 0,70), DeepDerm de 0,56 (0,51 a 0,61) e o modelo treinado em HAM10000 de 0,67 (0,62 a 0,71) (Daneshjou et al., 2022). Nos próprios conjuntos de teste, esses algoritmos tinham atingido valores bem mais altos, o que mostra queda ao sair do ambiente original.
Na comparação entre Fitzpatrick I-II e V-VI, ModelDerm passou de 0,64 (0,55 a 0,7) para 0,55 (0,46 a 0,64), DeepDerm de 0,61 (0,50 a 0,71) para 0,50 (0,41 a 0,58) e HAM10000 de 0,72 (0,63 a 0,79) para 0,57 (0,48 a 0,67) (Daneshjou et al., 2022). A sensibilidade caiu de 0,41 para 0,12 no ModelDerm e de 0,69 para 0,23 no DeepDerm (Daneshjou et al., 2022).
Dermatologistas também caem em pele escura
O DDI pediu a três dermatologistas que classificassem cada imagem como processo benigno ou maligno e formou um voto majoritário (Daneshjou et al., 2022). Os rótulos dos especialistas superaram os algoritmos antes do ajuste fino, mas a sensibilidade dos dermatologistas também caiu de 0,72 em Fitzpatrick I-II para 0,59 em V-VI (Daneshjou et al., 2022).
O teste com 848 médicos
Groh e colegas fizeram um experimento digital com 389 dermatologistas e 459 médicos de atenção primária de 39 países, que avaliaram 364 imagens de 46 doenças numa simulação de teledermatologia (Groh et al., 2024). A acurácia diagnóstica foi de 38 por cento entre dermatologistas e de 19 por cento entre generalistas, e os dois grupos foram 4 pontos percentuais menos precisos em pele escura (Groh et al., 2024). O apoio de um algoritmo de aprendizado profundo aumentou a acurácia em mais de 33 por cento, mas ampliou a diferença entre tons de pele entre os generalistas (Groh et al., 2024). Os autores concluem que melhorar a acurácia global não resolve, por si só, o viés (Groh et al., 2024).
Por que isso importa para o treino
Muitos bancos usam rótulos de dermatologistas como verdade de referência. Se o erro humano é maior em tons escuros e em doenças incomuns, o algoritmo herda e pode amplificar essa falha (Daneshjou et al., 2022). A discussão se cruza com viés implícito no diagnóstico e com a calibração da confiança: acerto e certeza não caminham juntos quando o subgrupo muda.
Uma síntese nossa é que o dermatologista continua indispensável, mas não é padrão-ouro isento de viés fotográfico; o papel dele é filtrar o algoritmo, não apenas rotular o banco.
Transparência dos conjuntos de dados
Antes do DDI, a revisão de escopo em JAMA Dermatology examinou 70 estudos de aprendizado profundo em dermatologia (Daneshjou et al., 2021). Entre 1.065.291 imagens usadas para desenvolver ou testar algoritmos, só 257.372 (24,2 por cento) eram publicamente disponíveis (Daneshjou et al., 2021).
O que quase ninguém reporta
Apenas 14 estudos (20,0 por cento) descreviam etnia ou raça em pelo menos um conjunto, e só 7 (10,0 por cento) informavam qualquer dado de tom de pele (Daneshjou et al., 2021). Sem essa informação, o leitor não consegue saber se o modelo foi testado na população em que será usado.
Bancos públicos e efeito de rede
Conjuntos públicos foram citados com mais frequência que os privados, o que concentra o treino em poucas fontes e em fotografias com perfil demográfico semelhante (Daneshjou et al., 2021). Uma hipótese nossa é que a repetição dos mesmos bancos explica parte da queda vista no DDI quando o cenário clínico muda.
A revisão de escopo também mostrou que a mediana de imagens nos estudos que treinavam algoritmos novos era de cerca de 10 mil, com variação ampla, o que reforça a desigualdade de recursos entre grupos de pesquisa (Daneshjou et al., 2021). Sem dados públicos e sem descrição demográfica, a comunidade clínica não consegue reproduzir nem auditar o desempenho por subgrupo antes da compra ou da implantação.
O que os bancos públicos contêm
Wen e colegas revisaram sistematicamente 21 bancos de imagens de câncer de pele de acesso aberto, com 106.950 imagens (Wen et al., 2022). Dos 14 bancos que informavam o país de origem, 11 (79 por cento) vinham da Europa, da América do Norte e da Oceania, e 19 bancos (91 por cento) tinham só imagens dermatoscópicas ou macroscópicas (Wen et al., 2022). A etnia estava disponível para 1.415 imagens (1,3 por cento) e o fototipo de Fitzpatrick para 2.236 (2,1 por cento) (Wen et al., 2022). Os autores pedem padrões de qualidade para os metadados dos bancos (Wen et al., 2022).
Essa opacidade lembra o alerta do relatório sobre erro diagnóstico: sistemas que não medem falha por subgrupo repetem inequidade, tema do texto sobre o relatório Improving Diagnosis.
Ajuste fino e o que muda com dados diversos
Os autores do DDI retreinaram DeepDerm e o modelo de HAM10000 com imagens diversas (Daneshjou et al., 2022). Depois do ajuste fino, DeepDerm atingiu área sob a curva de 0,73 (IC 95 por cento de 0,70 a 0,77) em Fitzpatrick I-II e 0,76 (0,71 a 0,80) em V-VI (Daneshjou et al., 2022).
HAM10000 depois do ajuste
O modelo baseado em HAM10000 chegou a 0,77 (0,73 a 0,80) em I-II e 0,78 (0,75 a 0,81) em V-VI (Daneshjou et al., 2022). A lacuna entre tons claros e escuros se fechou, e o desempenho passou a igualar ou superar o voto dos dermatologistas em várias fatias dos dados.
Leitura para o clínico
O resultado não significa que qualquer aplicativo comercial já foi ajustado. Significa que a falha é corrigível quando há imagens rotuladas e diversas, e que pedir evidência de teste por tom de pele é pergunta legítima antes da adoção. A revisão narrativa de 2025 chegou a conclusão parecida: a maioria dos estudos mostrou pior acurácia em Fitzpatrick IV-VI, com melhora após treino em conjuntos diversos (Dowie, 2025).
Tom de pele não é o mesmo que raça
Fitzpatrick foi criado para estimar resposta à luz ultravioleta, não para mapear ancestralidade. Ulrich e colegas descreveram um método automatizado que estima o tom de pele e o converte para as escalas Monk e Fitzpatrick; na validação com escaneamentos corporais em 3D e imagens geradas por IA, a concordância foi alta com Monk e menos consistente com Fitzpatrick (Ulrich et al., 2025).
Por que a distinção importa na consulta
Raça autodeclarada, etnia e tom de pele medido na foto respondem a perguntas diferentes. Um algoritmo pode falhar por pigmentação, por iluminação, por tipo de lesão ou por mistura desses fatores (Daneshjou et al., 2022; Ulrich et al., 2025). Tratar "pele escura" como categoria única sem descrever o método de classificação esconde o mecanismo do erro.
Na prática, o clínico que documenta o tom observado e a qualidade da foto ajuda tanto a auditoria do algoritmo quanto o raciocínio humano, no mesmo espírito de evitar rótulos que escondem o restante do quadro.
Checklist CLEAR Derm e o que pedir ao fornecedor
O grupo de trabalho de IA da International Skin Imaging Collaboration publicou o CLEAR Derm, um checklist de boas práticas para desenvolvimento e avaliação de IA baseada em imagem em dermatologia (Daneshjou et al., 2022). O documento cobre curadoria de dados, construção do modelo e avaliação, com atenção a viés fotográfico e a considerações éticas (Daneshjou et al., 2022).
Cinco perguntas práticas (síntese nossa)
Antes de incorporar um classificador à rotina, uma lista nossa, não validada como instrumento, inclui:
- O desempenho foi reportado por tom de pele ou por escala equivalente?
- O conjunto de teste é externo ao de treino?
- Há taxa de sensibilidade e de especificidade por subgrupo, não só área sob a curva global?
- As imagens de treino são publicamente auditáveis ou pelo menos descritas em composição demográfica?
- Existe plano de supervisão humana e de registro quando o algoritmo e o clínico discordam?
Essas perguntas dialogam com a leitura crítica de artigos e com o cuidado na equipe de melanoma, em que a imagem é só um passo do caminho.
Iluminação, captura e o caminho até o pixel
O algoritmo só vê o que a câmera entrega. Luz lateral, sombra, compressão de arquivo e fundo colorido mudam textura e cor aparentes. A revisão de princípios e aplicações da IA em dermatologia reforça que a qualidade da imagem e a representatividade do banco limitam qualquer modelo (Omiye et al., 2023).
O que padronizar no consultório
Uma lista operacional nossa, baseada nos limites descritos pelos estudos e não testada como protocolo, inclui:
- Usar luz difusa frontal e evitar flash duro que estoure o destaque.
- Enquadrar a lesão com margem de pele sadia ao redor.
- Manter a mesma distância e o mesmo ângulo em fotos de seguimento.
- Registrar o dispositivo e a data junto ao arquivo clínico.
- Evitar enviar ao algoritmo fotos borradas ou com filtro de embelezamento.
Esses cuidados também valem para lesões de viajante e para diagnósticos diferenciais de pele em mpox e em pele do viajante, mesmo quando o algoritmo não entra na decisão.
O que muda na decisão clínica
Na atenção primária, isso se traduz em não delegar a decisão de biópsia a um escore sem saber em qual população ele foi validado. O mesmo cuidado se aplica quando a foto chega por mensagem: qualidade ruim e tom de pele fora do banco de treino aumentam a incerteza, e o clínico deve dizer isso ao paciente com clareza.
Diante de um escore algorítmico, o clínico ainda precisa da história, do exame e do contexto epidemiológico. Uma hipótese nossa é que o maior risco não é o falso positivo em pele clara de demonstração, e sim o falso negativo em pele escura quando o aplicativo sugere "provavelmente benigno" com confiança aparente.
Como integrar sem automatizar o fechamento
Sugestões práticas, marcadas como síntese:
- Tratar o resultado do algoritmo como pista, não como laudo.
- Recusar decisão só por escore quando o tom de pele ou a doença saem do espectro do estudo de validação.
- Documentar discordância entre clínico e máquina para auditoria futura.
- Priorizar biópsia ou encaminhamento quando a lesão é clinicamente suspeita, independentemente do aplicativo.
- Evitar anunciar ao paciente uma "confirmação por inteligência artificial" sem explicar limites.
Esse uso encaixa no treino de diagnóstico diferencial com pistas e reduz o erro diagnóstico na atenção primária ligado a fechamento precoce.
Quando o algoritmo e a clínica divergem
Se a lesão parece suspeita ao exame e o aplicativo sugere benignidade, a conduta segue a clínica. O DDI mostrou sensibilidade baixa em Fitzpatrick V-VI justamente nas fatias em que o falso negativo dói mais (Daneshjou et al., 2022). Nesses casos, biópsia, dermatoscopia presencial ou segunda opinião pesam mais do que o escore.
Uma síntese nossa é registrar no prontuário o resultado do algoritmo, o tom de pele observado e a decisão final. Esse registro cria a base local de auditoria que os estudos multicêntricos ainda raramente publicam por subgrupo.
Limites que o texto não resolve
Os números do DDI vêm de um conjunto curado em um centro acadêmico e não medem o desempenho de cada aplicativo comercial disponível hoje. A revisão narrativa de Dowie selecionou poucos artigos após filtros restritivos (Dowie, 2025). Ulrich valida um método de classificação de tom, não um classificador de câncer (Ulrich et al., 2025).
Por isso, generalizar "toda IA de pele falha" seria inferência indevida. O que os dados sustentam é mais estreito: algoritmos treinados em bancos pouco transparentes e pouco diversos têm risco mensurável de desempenho pior em tons escuros, e esse risco diminui quando o treino e o teste incluem essas imagens de propósito (Daneshjou et al., 2022; Daneshjou et al., 2021).
O que o clínico leva para a próxima consulta
Depois de ler o DDI e a revisão de transparência, a mudança prática não é abandonar a tecnologia, e sim exigir o mesmo rigor que se pede a um exame laboratorial novo. Uma síntese nossa, alinhada aos achados citados, é organizar a consulta em três tempos: (1) qualidade da foto e do tom de pele observado; (2) resultado do algoritmo como pista, nunca como laudo; (3) decisão documentada quando houver discordância.
Como explicar o limite ao paciente
Uma formulação nossa, não testada como script, é dizer que o aplicativo ajuda a organizar hipóteses, mas foi treinado sobretudo em imagens de certos tons de pele, e que a decisão de biópsia ou de observação continua sendo clínica. Isso evita tanto o descarte cego da ferramenta quanto a confiança automática que o viés de automação descreve.
Auditoria mínima no serviço
Para serviços que já usam classificador, uma lista operacional nossa inclui revisar mensalmente os casos em que o algoritmo e o dermatologista divergiram, separar os arquivos por tom de pele observado e checar se os falsos negativos se concentram em Fitzpatrick V-VI, como o DDI previu (Daneshjou et al., 2022). Sem esse ciclo, o serviço repete a opacidade que a revisão de 70 estudos documentou (Daneshjou et al., 2021).
O mesmo espírito de medição por subgrupo aparece no cuidado com melanoma em equipe e na prevenção do fechamento precoce, tema do treino de diagnóstico diferencial com pistas. A tecnologia só reduz dano se o serviço souber em quem ela falha.
Estudos em resumo
| Estudo | Desenho, amostra e unidade | Achado principal |
|---|---|---|
| Esteva 2017 | Rede neural; 129.450 imagens de treino, 2.032 de teste | Desempenho próximo ao de dermatologistas no banco próprio |
| Adamson 2018 | Comentário | Alerta de disparidade se faltar medição por subgrupo |
| Daneshjou 2021 | Revisão de escopo; 70 estudos | Pouca transparência de raça e de tom de pele |
| Daneshjou 2022 (DDI) | Avaliação externa; 656 imagens | Queda de AUC e de sensibilidade em Fitzpatrick V-VI |
| Wen 2022 | Revisão sistemática; 21 bancos públicos, 106.950 imagens | Fitzpatrick informado em 2,1 por cento das imagens (Wen et al., 2022) |
| Groh 2024 | Experimento digital; 848 médicos, 364 imagens | Pele escura com acurácia menor; apoio da IA ampliou a diferença entre generalistas (Groh et al., 2024) |
| CLEAR Derm 2022 | Consenso de checklist | Itens para dados, modelo e avaliação justa |
| Omiye 2023 | Revisão narrativa | Limites de imagem e de representatividade |
| Dowie 2025 | Revisão narrativa; 8 artigos finais | Pior acurácia em tons escuros; melhora com dados diversos |
| Ulrich 2025 | Método de análise de tom | Escala Monk com melhor alinhamento em alguns testes |
Fontes: Esteva et al., 2017; Adamson e Smith, 2018; Daneshjou et al., 2021; Daneshjou et al., 2022; Daneshjou et al., 2022; Wen et al., 2022; Groh et al., 2024; Omiye et al., 2023; Dowie, 2025; Ulrich et al., 2025.
Como o NEXO ajuda a treinar esse raciocínio
No NEXO, o caso do dia é fictício, com apresentação clínica real e até seis pistas progressivas, e você propõe o diagnóstico buscando o código na CID-10. Uma pista pode trazer "mancha assimétrica em dorso, paciente com tom de pele escuro"; outra, "aplicativo de pele sugeriu benignidade com baixa confiança". O retorno de proximidade em cinco níveis ajuda a separar nevo, melanoma, carcinoma basocelular e dermatite, sem transformar o treino em protocolo de software.
Perguntas frequentes
Todo aplicativo de pele falha em tom escuro?
Os três algoritmos de ponta testados no DDI caíram em Fitzpatrick V-VI, e revisões posteriores encontraram o mesmo padrão na maioria dos estudos (Daneshjou et al., 2022; Dowie, 2025).
Ajustar o modelo com dados diversos resolve?
No DDI, o ajuste fino fechou a lacuna entre I-II e V-VI no DeepDerm e no modelo de HAM10000, mas cada produto comercial precisa mostrar o próprio teste (Daneshjou et al., 2022).
Dermatologistas são imunes ao viés da foto?
A sensibilidade do voto majoritário caiu de 0,72 para 0,59 entre tons claros e escuros no DDI (Daneshjou et al., 2022).
Tom de pele e raça são a mesma variável?
Fitzpatrick descreve resposta à luz; raça e etnia são categorias sociais distintas, e escalas como Monk tentam capturar o tom observado na imagem (Ulrich et al., 2025).
O que pedir antes de adotar um classificador?
Desempenho por subgrupo de tom de pele, teste externo, sensibilidade e especificidade, não só a área sob a curva global, e plano de supervisão humana, no espírito do CLEAR Derm (Daneshjou et al., 2022).
Take-home messages
- Algoritmos de ponta perderam AUC e sensibilidade em pele escura no DDI (Daneshjou et al., 2022).
- A maior parte dos estudos de IA em dermatologia não reporta raça nem tom de pele (Daneshjou et al., 2021).
- Ajuste fino com imagens diversas pode fechar a lacuna, se houver dados e auditoria (Daneshjou et al., 2022).
- Dermatologistas também erram mais em tons escuros, e o apoio da IA pode ampliar a diferença entre generalistas (Daneshjou et al., 2022; Groh et al., 2024).
- O clínico deve tratar o escore como pista e exigir transparência no estilo CLEAR Derm (Daneshjou et al., 2022).
Referências
- Esteva A, Kuprel B, Novoa RA, et al. Dermatologist-level classification of skin cancer with deep neural networks. Nature. 2017;542(7639):115-118. PMID: 28117445. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC8382232/
- Adamson AS, Smith A. Machine Learning and Health Care Disparities in Dermatology. JAMA Dermatol. 2018;154(11):1247-1248. PMID: 30073260. https://pubmed.ncbi.nlm.nih.gov/30073260/
- Daneshjou R, Smith MP, Sun MD, et al. Lack of Transparency and Potential Bias in Artificial Intelligence Data Sets and Algorithms: A Scoping Review. JAMA Dermatol. 2021;157(11):1362-1369. PMID: 34550305. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC9379852/
- Daneshjou R, Vodrahalli K, Novoa RA, et al. Disparities in dermatology AI performance on a diverse, curated clinical image set. Sci Adv. 2022;8(32):eabq6147. PMID: 35960806. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC9374341/
- Daneshjou R, Barata C, Betz-Stablein B, et al. Checklist for Evaluation of Image-Based Artificial Intelligence Reports in Dermatology: CLEAR Derm Consensus Guidelines from the International Skin Imaging Collaboration Artificial Intelligence Working Group. JAMA Dermatol. 2022;158(1):58-66. PMID: 34851366. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC9845064/
- Omiye JA, Gui H, Daneshjou R, et al. Principles, applications, and future of artificial intelligence in dermatology. Front Med (Lausanne). 2023;10:1278232. PMID: 37901399. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC10602645/
- Dowie T. Exploring the Diagnostic Capability of Artificial Intelligence in Dermatology for Darker Skin Tones: A Narrative Review. Cureus. 2025;17(10):e94909. PMID: 41262830. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC12624499/
- Ulrich P, Zink A, Biedermann T, Sitaru S. Beyond Fitzpatrick: automated artificial intelligence-based skin tone analysis in dermatological patients. NPJ Digit Med. 2025;8:378. PMID: 40537526. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC12179258/
- Wen D, Khan SM, Ji Xu A, et al. Characteristics of publicly available skin cancer image datasets: a systematic review. Lancet Digit Health. 2022;4(1):e64-e74. PMID: 34772649. https://pubmed.ncbi.nlm.nih.gov/34772649/
- Groh M, Badri O, Daneshjou R, et al. Deep learning-aided decision support for diagnosis of skin disease across skin tones. Nat Med. 2024;30(2):573-583. PMID: 38317019. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC10878981/