InfektiologieTropen- und ReisemedizinPrimärversorgung
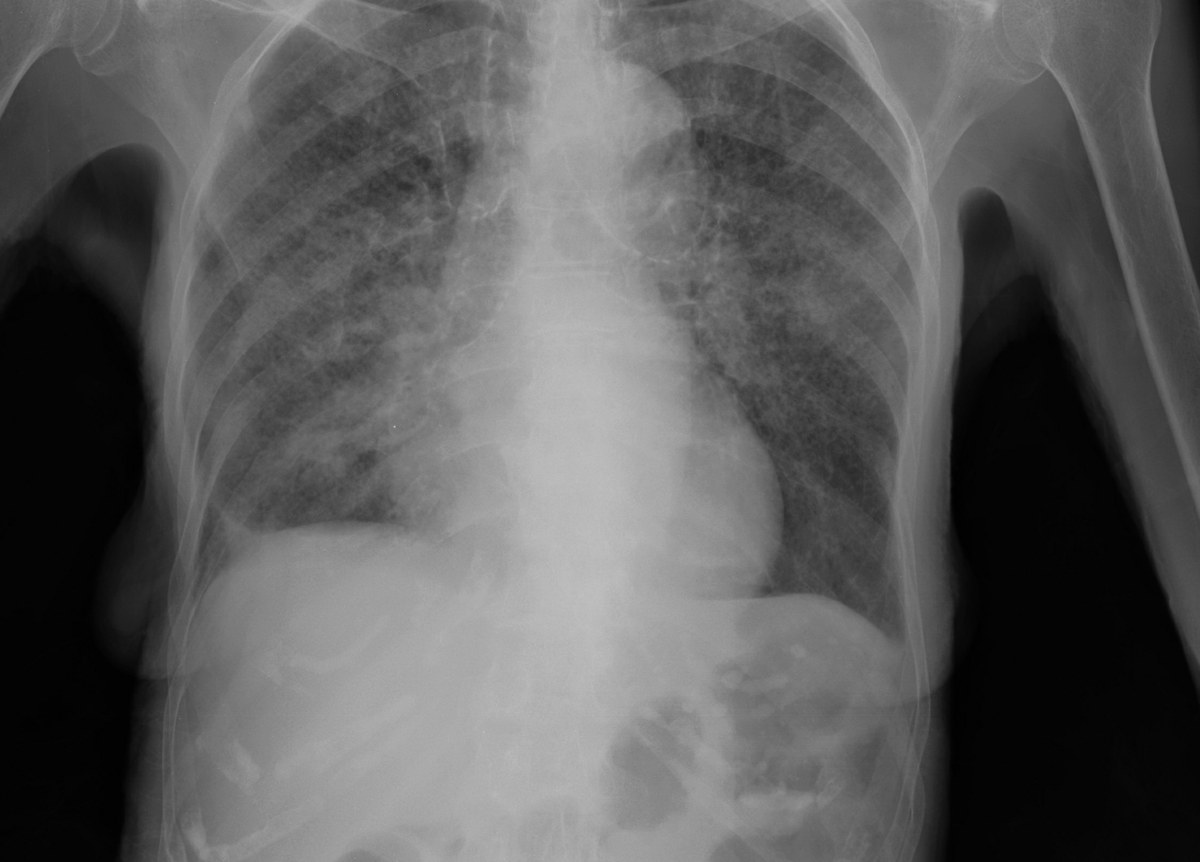
In einem fiktiven Fall kommt ein mobiles Team in ein dicht besiedeltes Viertel einer Stadt mit hoher Tuberkulosebelastung. An einem einzigen Tag machen Hunderte Erwachsene eine digitale Röntgenaufnahme des Brustkorbs, und es gibt nur einen Radiologen für die ganze Region, der die Bilder erst Wochen später sieht. Das Team entscheidet, dass eine Software jedem Bild eine Punktzahl von 0 bis 100 gibt, und wer einen bestimmten Wert überschreitet, wird zum molekularen Sputumtest überwiesen. Die Frage, die das Team spaltet, ist einfach zu stellen und schwer zu beantworten: Welche Zahl soll man verwenden?
Die computergestützte Detektion, bekannt unter der englischen Abkürzung CAD, wurde 2021 in die Empfehlung der Weltgesundheitsorganisation (WHO) als Alternative zum menschlichen Befunder beim Screening und bei der Triagierung der Tuberkulose aufgenommen. Die WHO selbst besteht jedoch darauf, dass der Schwellenwert für jeden Kontext kalibriert werden muss, weil dieselbe Software mit demselben Schwellenwert sich in verschiedenen Populationen unterschiedlich verhält.
Dieser Text zeigt, was die WHO empfohlen hat und mit welcher Stärke, wie Studien die Genauigkeit dieser Programme messen, was mit den falsch positiven Befunden geschieht, wenn der Schwellenwert sinkt, und welche Gruppen die Software eher falsch einschätzt.
Die wichtigsten Punkte
Die Tuberkulose ist die häufigste Todesursache durch einen einzelnen Erreger, und 2024 tötete sie 1,23 Millionen Menschen, von denen 150 000 mit HIV lebten, laut dem Faktenblatt der WHO (WHO, 2026). Im selben Jahr erkrankten 10,7 Millionen Menschen: 5,8 Millionen Männer, 3,7 Millionen Frauen und 1,2 Millionen Kinder.
Die Krankheit konzentriert sich dort, wo es weniger Ressourcen gibt. Mehr als 80 Prozent der Erkrankungen und Todesfälle treten in Ländern mit niedrigem und mittlerem Einkommen auf, und die Regionen Südostasien, Westpazifik und Afrika tragen den größten Teil der Last (WHO, 2026). Reisende und Fachkräfte, die Menschen aus diesen Regionen behandeln, treffen dieselbe diagnostische Frage in einem anderen Szenario an.
Das zentrale Problem ist die Lücke zwischen denen, die erkranken, und denen, die diagnostiziert werden. Im Dokument von 2021 erinnert die WHO daran, dass 2019 etwa 2,9 Millionen der 10 Millionen Menschen mit Tuberkulose nicht diagnostiziert oder nicht gemeldet wurden (WHO, 2021). Ein Teil dieser Menschen hat wenige oder keine Symptome und taucht erst auf, wenn jemand aktiv nach ihnen sucht.
Die WHO trennt zwei Verwendungen der Röntgenaufnahme (WHO, 2021). Beim Screening wird die Röntgenaufnahme einer Risikopopulation angeboten, mit oder ohne Symptome, und die Tuberkuloseprävalenz liegt meist unter 5 Prozent (WHO, 2021). Bei der Triagierung wird die Röntgenaufnahme bei Personen gemacht, die bereits mit Symptomen die Einrichtung aufgesucht haben, und die Prävalenz liegt laut demselben Dokument im Allgemeinen zwischen 10 und 20 Prozent (WHO, 2021).
Dieser Unterschied in der Prävalenz ist sehr wichtig. Wie unter Prätest-Wahrscheinlichkeit erläutert, erzeugt derselbe Test mit derselben Sensitivität und Spezifität sehr unterschiedliche Anteile falsch positiver Befunde, je nachdem, ob die Krankheit in der getesteten Population selten oder häufig ist. Das zu vergessen heißt, in den unter Basisrate in der Diagnostik beschriebenen Fehler zu verfallen.
In beiden Anwendungen bestätigt die Röntgenaufnahme nichts. Wer ein auffälliges Bild hat, wird zu einem bakteriologischen Test weitergeleitet, etwa einem schnellen molekularen Sputumtest, und dieser Test bestätigt die Erkrankung.
Modul 2 der konsolidierten WHO-Leitlinien zur Tuberkulose, das dem Screening gewidmet ist, brachte eine neue Empfehlung zur automatisierten Auswertung (WHO, 2021). Frei übersetzt heißt es dort, dass bei Personen ab 15 Jahren in Bevölkerungen, für die ein Tuberkulose-Screening empfohlen wird, computergestützte Erkennungsprogramme anstelle menschlicher Auswerter eingesetzt werden können, um digitale Thoraxradiographien beim Screening und bei der Triage der Erkrankung zu interpretieren. Die Leitlinie selbst stuft die Empfehlung als bedingt ein, mit geringer Evidenzsicherheit.
Beide Qualifizierungen haben Gewicht. Eine bedingte Empfehlung bedeutet, dass die Gruppe, die die Leitlinie erarbeitete, die Vorteile als wahrscheinlich größer als die Risiken einschätzte, die Entscheidung aber vom Kontext, den Ressourcen und den lokalen Werten abhängt. Die geringe Sicherheit bedeutet, dass neue Studien die Effektschätzung ändern können.
Die Gruppe, die die Leitlinie erarbeitete, prüfte drei unabhängige Bewertungen von drei CE-gekennzeichneten Produkten bis Januar 2020 und führte die Analyse durch, ohne zu wissen, um welche Marken es sich handelte (WHO, 2021). Die Empfehlung gilt für digitale Radiographien in posteroanteriorer oder anteroposteriorer Projektion. Ausgeschlossen blieben die laterale und die oblique Projektion, und die Leistung bei digitalisierten analogen Radiographien ist unbekannt.
Das Dokument grenzt auch das Ziel ab. Die Genauigkeit wurde gegen bakteriologisch bestätigte Tuberkulose gemessen, und die Software erkennt außer Tuberkulose keine anderen Lungenerkrankungen; zu ihrer Leistung in der Differenzialdiagnose gab es keine Daten (WHO, 2021). Das trennt dieses Thema vom Zufallsbefund, der in Zufällig entdeckter Lungenknoten und Wahrscheinlichkeit behandelt wird: dort wurde das Bild aus einem anderen Grund angefertigt und die Überlegung geht von der Krebswahrscheinlichkeit aus; hier wird das Bild gezielt und in großem Umfang angefertigt, um eine einzige Erkrankung zu finden.
Schließlich gilt die Empfehlung für Produkte, die sich in einer externen Validierung nicht als schlechter erweisen als die geprüften. Die WHO nennt auch das Potenzial, den Zugang dort zu erweitern, wo Radiologen fehlen, macht die Machbarkeit aber von Ausstattung, Internetverbindung und Wartung abhängig (WHO, 2021).
Die Gruppe verglich die Software mit menschlichen Auswertern anhand desselben bakteriologischen Referenzstandards. Dazu legte sie die Schwelle der Software auf den Punkt fest, an dem die Sensitivität etwa 90 Prozent erreichte, und verglich die erzielte Spezifität mit der der Auswerter (WHO, 2021). Diese Zahl stammt aus dem WHO-Zielproduktprofil, das für einen Screening-Test eine Sensitivität über 0,90 und eine Spezifität über 0,70 verlangt.
| Anwendung | Auswerter | Sensitivität | Spezifität |
|---|---|---|---|
| Zielproduktprofil | Zielwert | über 0,90 | über 0,70 |
| Screening | CAD-Software | 0,90 bis 0,92 | 0,23 bis 0,66 |
| Screening | Menschlicher Auswerter | 0,82 bis 0,93 | 0,14 bis 0,63 |
| Triage | CAD-Software | 0,90 bis 0,91 | 0,25 bis 0,79 |
| Triage | Menschlicher Auswerter | 0,89 bis 0,96 | 0,36 bis 0,63 |
Quellen: WHO, 2021, Modul 2, Tabelle 4 des Dokuments; Werte als Anteile angegeben, Spannen zwischen den Studien, ohne gepoolte Schätzung.
Die Tabelle zeigt, was die WHO als geringen Unterschied zwischen Software und menschlichem Auswerter bezeichnete. Die Spezifitätsspannen sind in beiden Gruppen breit, und das Dokument fasste die Schätzungen nicht in einer Metaanalyse zusammen (WHO, 2021). Die Schlussfolgerung war eine ähnliche Genauigkeit, nicht eine Überlegenheit.
Eine frühere systematische Übersicht hilft zu verstehen, warum die WHO vorsichtig war (Harris et al., 2019). Die Autoren fassten 53 Studien zusammen, 40 zur Entwicklung und 13 zur klinischen Bewertung. Der Median der Fläche unter der Kurve betrug 0,88 in den Entwicklungsstudien und 0,75 in den klinischen Studien, und die Spezifität in den klinischen Studien lag zwischen 0,23 und 0,69. Die Autoren führten wegen der Heterogenität und des Verzerrungsrisikos keine Metaanalyse durch.
Der Abstand zwischen Labor und realer Welt ist bei KI-Werkzeugen üblich. Dasselbe Phänomen zeigt sich bei autonomer KI im Screening der diabetischen Retinopathie, wo die prospektive Validierung dem klinischen Einsatz Glaubwürdigkeit verlieh. Wer einen breiteren Überblick über das Thema möchte, kann den Einsatz künstlicher Intelligenz im klinischen Denken ansehen.
Zwei unabhängige Bewertungen stellten mehrere Programme vor denselben Satz von Bildern. In einer retrospektiven Studie mit 1196 ambulanten Patientinnen und Patienten aus Nepal und Kamerun, mit dem molekularen Test als Referenz, erreichten drei Programme Flächen unter der Kurve von 0,92 bis 0,94 (Qin et al., 2019). Die Autoren schätzten, dass die Software die erforderlichen molekularen Tests um 66 Prozent senken könnte, während die Sensitivität bei 95 Prozent oder mehr bleibt (Qin et al., 2019).
In Vietnam wurde eine Bibliothek von 1032 Röntgenaufnahmen genutzt, um 12 Programme mit einem erfahrenen Leser und einem mittelmäßig erfahrenen Leser zu vergleichen (Codlin et al., 2021). Sechs Programme schnitten gleich gut ab wie der erfahrene Leser. Die Autoren nennen als Grenzen die Herkunft aus einer einzigen Region, das retrospektive Design und eine Stichprobe, die zu Menschen mit Verdacht auf Tuberkulose hin verschoben ist.
Die Software sagt nicht "Tuberkulose" oder "normal". Sie liefert eine kontinuierliche Punktzahl, und jemand muss entscheiden, ab welchem Wert das Bild als auffällig gilt. Eine qualitative Erhebung mit Nutzern aus neun Ländern mit hoher Belastung fasst das Dilemma zusammen: Ein höherer Schwellenwert macht die Software spezifischer und weniger sensitiv, ein niedrigerer Schwellenwert bewirkt das Gegenteil, und kein Schwellenwert ist zugleich vollkommen sensitiv und vollkommen spezifisch (Creswell et al., 2023). Der beste Punkt ist der, der die Genauigkeit mit der Menge an Bestätigungstests ausbalanciert, die der Dienst aufnehmen kann.
Die Arbeit von Vanobberghen und Kollegen wird von den Autoren als Sekundäranalyse der nationalen Prävalenzerhebung zu Tuberkulose in Lesotho von 2019 beschrieben (Vanobberghen et al., 2024). Teilgenommen haben 17 070 Personen ab 15 Jahren. Da nur Personen mit Symptomen oder auffälligem Röntgenbild den bakteriologischen Test machten, wurde bei nur 5214 Teilnehmenden der Tuberkulosestatus bestimmt, und 142 hatten die Krankheit.
Um mit den nicht getesteten Personen umzugehen, verglichen die Autoren sechs Methoden. Mit multipler Imputation ergab der Schwellenwert 13 eine Sensitivität von 89,7 Prozent, mit einem 95-Prozent-Konfidenzintervall von 84,6 bis 94,8, und eine Spezifität von 74,2 Prozent, mit einem Intervall von 73,6 bis 74,9 (Vanobberghen et al., 2024). Die Annahme, dass alle nicht getesteten Personen negativ waren, führte zu ähnlichen Ergebnissen.
| Schwellenwert der Software | Sensitivität (Prozent) | Spezifität (Prozent) |
|---|---|---|
| 3 | 96,5 | 38,1 |
| 5 | 93,7 | 54,2 |
| 8 | 91,5 | 65,5 |
| 10 | 90,1 | 69,7 |
| 13 | 90,1 | 74,2 |
Quellen: Vanobberghen et al., 2024, Tabelle 3, Ansatz, der die nicht getesteten Personen als negativ behandelt; Punktzahl von 0 bis 100 einer bestimmten Version der Software.
Zwischen den Schwellenwerten 13 und 10 blieb die Sensitivität gleich und die Spezifität sank. Vom Schwellenwert 13 bis zum Schwellenwert 3 gewann die Sensitivität 6,4 Prozentpunkte, während die Spezifität 36,1 Punkte verlor. Die Autoren beschreiben die Rückgänge der Spezifität bei den niedrigeren Schwellenwerten als erheblich.
Eine illustrative Rechnung, die wir anhand von Tabelle 3 von Vanobberghen und Kollegen erstellt haben und nicht die Autoren, hilft, den Effekt zu sehen. Bei 1000 Personen ohne Tuberkulose bleiben bei einer Spezifität von 74,2 Prozent etwa 258 Bilder fälschlich auffällig, während bei einer Spezifität von 38,1 Prozent etwa 619 bleiben, nach den Werten der Studie (Vanobberghen et al., 2024). Jede dieser Personen braucht eine Sputumprobe, einen molekularen Test und eine Antwort, und einige können ohne Bestätigung behandelt werden, die Art von Übermaß, die unter Überdiagnose diskutiert wird.
Dieselbe Studie zeigt einen Kontrast zur menschlichen Befundung vor Ort. Die menschliche Befundung der Röntgenbilder in der Erhebung, einschließlich der zentralen Befundung, wenn verfügbar, ergab eine Sensitivität von 47,2 Prozent und eine Spezifität von 96,5 Prozent (Vanobberghen et al., 2024). Die menschliche Befundung war deutlich spezifischer und deutlich weniger sensitiv als die Software beim gewählten Schwellenwert.
Die Autoren listen wichtige Probleme auf. Viele Röntgenbilder fehlten, vor allem in städtischen Gebieten, was die Repräsentativität beeinträchtigen kann; etwa 19 Prozent der eingeladenen Personen lehnten die Erhebung ab, in größerem Anteil junge Männer aus städtischen Gebieten (Vanobberghen et al., 2024). Die multiple Imputation beruht auf der Annahme, dass die Daten zufällig fehlen. Außerdem schwankte die Prävalenzschätzung je nach Methode zwischen 0,83 und 2,72 Prozent, was zeigt, wie stark das Ergebnis davon abhängt, wie die nicht Getesteten behandelt werden (Vanobberghen et al., 2024). Einer der Autoren ist von der WHO.
Der optimale Schwellenwert von Lesotho gilt nicht für andere Orte. Die Autoren selbst nennen Schwellenwerte von 50 in Bangladesch und von 20 in Südafrika für dieselbe Art von Programm und schließen, dass der Schwellenwert vom Kontext abhängt (Vanobberghen et al., 2024). In der Studie zu Nepal und Kamerun lag der Grenzwert desselben Programms, der die gewünschte Sensitivität sicherte, in einem Land bei 63 und im anderen bei 48, und ein universeller Schwellenwert schnitt an jedem Ort anders ab (Qin et al., 2019).
Die von Creswell und Kollegen befragten Nutzer berichten, dass die Wahl des Schwellenwerts unter politischen Entscheidungsträgern weiterhin umstritten ist und dass die verwendeten Strategien vielfältig und wenig strukturiert waren, und sie halten Kalibrierungsstudien für schwer durchführbar und für wiederholungsbedürftig (Creswell et al., 2023). Das Sonderforschungsprogramm der WHO für Tropenkrankheiten hat einen Prozess veröffentlicht, der diese Wahl anleiten soll.
Die durchschnittliche Spezifität verdeckt Gruppen, bei denen die Software häufiger versagt. Die Meta-Analyse individueller Daten von Tavaziva und Kollegen umfasste 3727 Teilnehmer aus vier Studien, mit etwa 17 Prozent Menschen mit HIV und 17 Prozent mit bestätigter Tuberkulose (Tavaziva et al., 2022). Bei einer gepoolten Sensitivität von 90 Prozent lagen die Spezifitäten von drei Programmen zwischen 54,1 und 60,5 Prozent (Tavaziva et al., 2022).
Der stärkste Abfall zeigte sich bei Menschen mit früherer Tuberkulose. In derselben Meta-Analyse lag die Spezifität bei Personen mit früherer Behandlung bei 26,6 bis 33,7 Prozent und bei den übrigen bei 58,0 bis 69,3 Prozent (Tavaziva et al., 2022). Auch die Sensitivität war bei Tuberkulose mit negativem Sputumausstrich geringer und bei zwei der Produkte bei Menschen mit HIV. Die Autoren schließen, dass die Schwellenwerte anhand der Populationen jedes Nutzers festgelegt werden müssen, und räumen ein, dass Daten aus drei der sieben geeigneten Studien nicht verfügbar waren und CD4-Daten fehlten.
Eine Studie in Lusaka, Sambia, nahm diese Gruppe genauer in den Blick. Die Autoren beschreiben eine retrospektive Analyse einer prospektiven Querschnittsstudie zur Fallfindung mit 1884 symptomatischen Personen ab 15 Jahren, von denen 452, also 24,0 Prozent, eine frühere Tuberkulose hatten (Kagujje et al., 2023). Bei Schwellenwerten für eine Sensitivität von 90 Prozent lag die Spezifität eines Programms bei 24,0 Prozent bei Personen mit früherer Tuberkulose und bei 60,3 Prozent bei Personen ohne; die eines anderen bei 22,2 gegenüber 61,8 Prozent (Kagujje et al., 2023). Die Studie enthielt keinen Vergleich mit einem menschlichen Befunder, die Tuberkulosevorgeschichte war selbstberichtet und der Referenzstandard war der Molekulartest.
Die Narben einer behandelten Tuberkulose bleiben auf dem Röntgenbild sichtbar, und die Software neigt dazu, diese Folgen als aktive Erkrankung zu lesen. In der vietnamesischen Bewertung schnitt die Mehrheit der Programme bei Menschen mit früherer Tuberkulose deutlich schlechter ab (Codlin et al., 2021).
In Südafrika wurde mit einer Fall-Kontroll-Stichprobe von 774 Personen ab 15 Jahren, davon 258 mit Tuberkulose, aus der nationalen Prävalenzerhebung von 2017 bis 2019 eine externe Validierung durchgeführt, um 12 Programme zu testen (Qin et al., 2024). Die Flächen unter der Kurve lagen bei den besten bei etwa 0,9 und bei den schlechtesten unter 0,8, und alle Produkte schnitten bei älteren Menschen, bei Menschen mit früherer Tuberkulose und bei Menschen mit HIV schlechter ab. Die Autoren räumen ein, dass die Studie zu wenig Aussagekraft hatte, mit 258 Personen mit Tuberkulose gegenüber 291 erforderlichen, dass ein Teil der Daten selbstberichtet war und dass asymptomatische Personen mit normalem Röntgenbild ausgeschlossen wurden.
In Lesotho variierte die Sensitivität je nach HIV-Status und Punktwert stark, die Spezifität änderte sich jedoch kaum (Vanobberghen et al., 2024), was zeigt, wie sehr diese Ergebnisse zwischen Populationen schwanken. In der Auswertung für Vietnam beeinflusste auch der Typ des Röntgengeräts die Leistung einiger Programme (Codlin et al., 2021).
Die praktische Lehre ist, dass die bedienende Person wissen muss, wer vor dem Gerät steht. Eine Warteschlange mit vielen älteren Erwachsenen und vielen bereits behandelten Personen erzeugt mehr falsch positive Befunde als eine Warteschlange junger Menschen ohne Tuberkulosevorgeschichte, selbst bei gleichem Schwellenwert.
Die Software ändert sich mit der Zeit. In einem Fall-Kontroll-Datensatz mit 12 890 Röntgenbildern aus Bangladesch stieg die Fläche unter der Kurve eines Programms von 0,823 in einer Version auf 0,903 in der nächsten, die eines anderen von 0,872 auf 0,906 (Qin et al., 2022). Die neueren Versionen erreichten das Zielproduktprofil der WHO, doch die Aktualisierung veränderte die Schwellenwerte, die dieselbe Sensitivität ergaben, und die Autoren empfehlen eine Neubewertung mit lokalen Daten. Die Studie verwendete keine Kultur, nicht die sensitivste Version des molekularen Tests und schloss Personen unter 15 Jahren aus.
Die WHO-Leitlinie behandelt die Einführung in Abschnitt 4.4 (WHO, 2021). Das Dokument beschreibt erhebliche Unterschiede zwischen Standorten selbst bei gleicher Software und gleichem Schwellenwert und fordert daher eine lokale Kalibrierung des Punktwerts entsprechend den Zielen des Programms, gefolgt von kontinuierlichem Monitoring. Dieses Monitoring vergleicht die Ausgaben der Software mit denen menschlicher Befunder, mit den bakteriologischen Ergebnissen und mit dem Anteil der als auffällig eingestuften Bilder. Ein Betriebshandbuch, ein Kalibrierungsprotokoll und ein Online-Werkzeug begleiten die Leitlinie.
Wenn die Maschine entscheidet, wer zum Test weitergeleitet wird, neigt das Team dazu, die Bilder, die sie als unauffällig eingestuft hat, nicht mehr anzusehen. Dieses Risiko ist das Thema des Automatisierungsbias. Der Anteil auffälliger Bilder ist ein gutes Alarmsignal: Steigt oder fällt er ohne Veränderung der Population, hat sich etwas am Gerät, an der Software oder am Ablauf geändert.
Die Software verändert auch, wer was tut. An vielen Orten ist die Person, die das Gerät bedient und die Patientin oder den Patienten weiterleitet, eine technische Kraft oder eine Gesundheitshelferin und kein Arzt, eine Regelung, die unter Aufgabenübertragung erörtert wird. An Orten mit wenigen Ressourcen geht die softwarebefundete Radiografie mit anderen einfachen Untersuchungen einher, wie sie unter Diagnostik mit wenigen Ressourcen beschrieben sind.
Eine aktuelle Studie legt nahe, dass der Punktwert Informationen über den Zeitpunkt der Untersuchung hinaus tragen kann. In einer prospektiven Kohorte von 483 Haushaltskontakten von Personen mit Rifampicin-resistenter Tuberkulose in Südafrika, die im Median 4,6 Jahre nachbeobachtet wurden, gab es 23 Personen mit prävalenter und 38 mit inzidenter Tuberkulose (Macpherson et al., 2025). Die Fläche unter der Kurve lag bei 0,87 bis 0,91 für die prävalente und bei 0,60 bis 0,65 für die inzidente Erkrankung. Mehr als 30 Prozent der Personen über dem Schwellenwert mit negativem Routine-Sputum wurden später diagnostiziert, durch die erweiterte Sputumdiagnostik oder während der Nachbeobachtung (Macpherson et al., 2025). Die Autoren warnen, dass die getesteten niedrigeren Schwellenwerte nicht extern validiert wurden und dass die Studie in einem Umfeld mit hoher Belastung durchgeführt wurde.
Die Empfehlung der WHO gilt für Personen ab 15 Jahren, und die Leitlinie nennt Software für Kinder als dringende Forschungslücke (WHO, 2021). Die Radiografie bei Kindern ist anders: Die Lymphknoten des Hilus und des Mediastinums prägen das Bild, und das Bild ändert sich mit dem Alter.
Die Studie von Palmer und Kollegen verwendete Röntgenbilder von 620 Kindern unter 13 Jahren, die zwischen 2012 und 2017 in eine prospektive Beobachtungsstudie zur Diagnostik in Kapstadt eingeschlossen wurden (Palmer et al., 2023). Analysiert wurden 525 Bilder, mit einem Testsatz von 80, je zur Hälfte mit und ohne Tuberkulose. Der Referenzstandard war die radiologische Befundung durch ein Expertengremium und nicht die bakteriologische Bestätigung.
Die Erwachsenenversion der Software erreichte in diesem Datensatz eine Fläche unter der Kurve von 0,58. Nach einer Feinabstimmung mit pädiatrischen Bildern stieg die Fläche auf 0,72, ein statistisch signifikanter Unterschied mit p von 0,0016 (Palmer et al., 2023). Auch verbessert blieb die Leistung weit von der bei Erwachsenen entfernt.
Die Autoren räumen ein, dass der Datensatz für tiefes Lernen klein war, dass der Referenzstandard von menschlicher Befundung abhing und dass die Fachleute bei 25 der 80 Testbilder untereinander uneinig waren (Palmer et al., 2023). Die Population bestand aus Kindern in diagnostischer Abklärung, nicht aus Screening. Einer der Mitautoren gehört zu dem Unternehmen, das die Software entwickelt. Die Studie ist ein Machbarkeitsnachweis und stützt den Einsatz der Software bei Kindern nicht.
Das Team unseres fiktiven Falls hat jetzt nützlichere Fragen als "welche Zahl verwenden". Wie viele molekulare Tests pro Tag hält das Labor aus? Welche Prävalenz ist in dieser Warteschlange zu erwarten? Wie viele Menschen hatten bereits Tuberkulose? Ist die Softwareversion dieselbe wie in den Kalibrierungsstudien?
Mit diesen Antworten kann das Team einen anfänglichen Schwellenwert wählen, den Anteil auffälliger Bilder erfassen und eine Stichprobe der Befunde mit dem Radiologen und den Sputumergebnissen vergleichen. Hat die Warteschlange viele früher behandelte Erwachsene, muss sie mit mehr falsch positiven Befunden rechnen und den Ablauf anpassen. Und sie muss bedenken, dass kleine Kinder, die die Einheit durchlaufen, außerhalb der Empfehlung liegen und eine klinische Beurteilung brauchen.
Bei NEXO ist der Fall des Tages fiktiv, mit realer klinischer Präsentation und bis zu sechs fortschreitenden Hinweisen, und Sie stellen die Diagnose, indem Sie den Code in der ICD-10 suchen. Einen Schwellenwert zu wählen verlangt dieselbe Übung: die Wahrscheinlichkeit vor der Untersuchung abwägen, fragen, wer getestet wird, und entscheiden, was mit einem Ergebnis zu tun ist, das nicht aufgeht, wie beim Training der Differenzialdiagnose mit Hinweisen.
Die Grenzen der Nutzung des Spiels sind auf der Seite zur Wirtschaft von NEXO beschrieben. Wenn Sie die Vermittlung klinischen Denkens erforschen, erklärt die Seite für Researcher, wie Sie Kontakt aufnehmen. Fachleute, die Fälle schreiben oder überprüfen, finden Informationen unter Curator und unter Creators, und Institutionen können das Angebot auf der Seite für Partnerschaften kennenlernen. Die Suche nach dem richtigen Code in der ICD-10 vervollständigt dieses Training.
Sie zeigt an, wer zu einem Bestätigungstest weitergeleitet werden sollte. Die WHO hat die Software gegen bakteriologisch bestätigte Tuberkulose bewertet, und die Bestätigung hängt weiterhin vom Sputumtest ab (WHO, 2021).
Die WHO stuft sie als bedingt ein, mit geringer Evidenzsicherheit, und beschränkt auf Personen ab 15 Jahren und auf digitale Röntgenaufnahmen in frontaler Projektion (WHO, 2021).
Die Studien zeigen sehr unterschiedliche optimale Schwellenwerte zwischen Ländern und zwischen Versionen desselben Programms, und die WHO verlangt eine lokale Kalibrierung (Vanobberghen et al., 2024; Qin et al., 2022).
Weil nahe dem Punkt, an dem die Sensitivität bereits hoch ist, jeder kleine Gewinn an Sensitivität einen großen Verlust an Spezifität verursacht. In Lesotho brachte der Wechsel vom Schwellenwert 13 auf 3 einen Gewinn von 6,4 Punkten Sensitivität und einen Verlust von 36,1 Punkten Spezifität (Vanobberghen et al., 2024).
Ja, aber die Spezifität sinkt in dieser Gruppe stark, und der Dienst muss mit vielen Überweisungen ohne aktive Erkrankung rechnen (Tavaziva et al., 2022; Kagujje et al., 2023).
Die WHO-Empfehlung schließt Personen unter 15 Jahren aus, und die beste verfügbare pädiatrische Studie ist ein Machbarkeitsnachweis mit kleiner Stichprobe (Palmer et al., 2023).