Digitale Medizin und KIDenkfehler und DiagnosefehlerKlinisches Denken
KI in der Dermatologie: schlechtere Werte bei dunkler Haut
Inhaltsverzeichnis
- Warum KI für die Haut zum Versprechen und zum Risiko wurde
- Was Diverse Dermatology Images gemessen hat
- Transparenz der Datensätze
- Feinabstimmung und was sich mit vielfältigen Daten ändert
- CLEAR Derm Checkliste und was man vom Anbieter verlangen sollte
- Was sich bei der klinischen Entscheidung ändert
- Studien im Überblick
- Wie NEXO hilft, dieses Denken zu trainieren
- Häufige Fragen
- Take-home messages
- Literatur
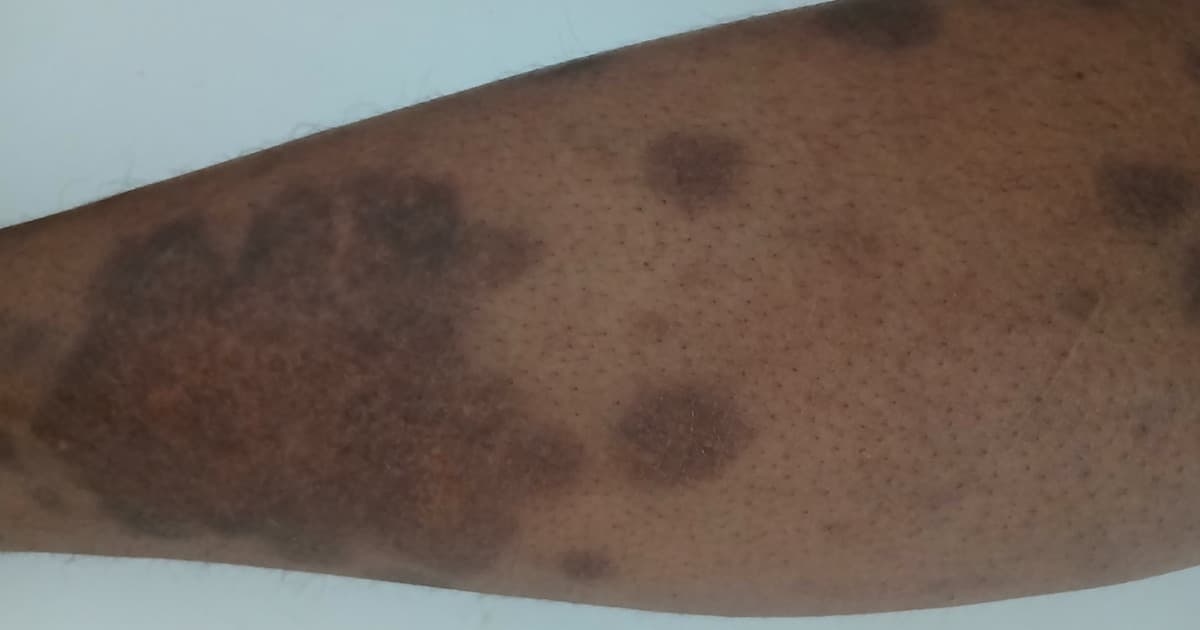
In einer fiktiven Sprechstunde testet eine Hautklinik eine App, die Fotos von Läsionen als gutartig oder bösartig einordnet. Der Algorithmus liegt bei den hellen Bildern aus der Demonstrationsdatenbank häufig richtig. In derselben Woche bringen drei Patienten mit dunklem Hautton Fotos von Flecken und Knoten mit: Die App liefert niedrige Konfidenzwerte oder schlägt Gutartigkeit bei Läsionen vor, die der Dermatologe als verdächtig einschätzt. Das Team fragt, ob das Problem das Foto, das Gerät oder das Modell ist.
Dieses Szenario fasst zusammen, was aktuelle Studien gemessen haben: Bildklassifikatoren für Haut, die mit wenig vielfältigen Datenbanken trainiert wurden, verlieren an Leistung bei dunklen Hauttönen und bei selteneren Erkrankungen. Dieser Text sammelt, was die Literatur zu diesem Leistungsabfall zeigt, warum die Datensätze bei der Transparenz versagen und was der Kliniker fragen kann, bevor er dem Ergebnis vertraut. In jedem Abschnitt nennt der Text das Design und die Größe der Studien und trennt, was gemessen wurde, von dem, was unsere Schlussfolgerung ist.
Die wichtigsten Punkte
- Im Datensatz Diverse Dermatology Images lagen drei Spitzenalgorithmen bei der Fläche unter der ROC-Kurve zwischen 0,56 und 0,67, deutlich unter der in ihren eigenen Tests berichteten Leistung (Daneshjou et al., 2022).
- Die Sensitivität sank bei Fitzpatrick V-VI deutlich: ModelDerm von 0,41 auf 0,12 und DeepDerm von 0,69 auf 0,23 (Daneshjou et al., 2022).
- In 70 KI-Studien zur Dermatologie waren nur 24,2 Prozent der Bilder öffentlich, 20 Prozent beschrieben Rasse oder Ethnizität und 10 Prozent nannten den Hautton (Daneshjou et al., 2021).
- Feinabstimmung mit vielfältigen Bildern schloss die Lücke zwischen hellen und dunklen Hauttönen bei DeepDerm und beim mit HAM10000 trainierten Modell (Daneshjou et al., 2022).
- Auch Dermatologen irrten bei dunklen Hauttönen und bei ungewöhnlichen Erkrankungen häufiger, was wichtig ist, weil sie viele Trainingsdatenbanken beschriften (Daneshjou et al., 2022).
- Warum KI für die Haut zum Versprechen und zum Risiko wurde
- Was Diverse Dermatology Images gemessen hat
- Transparenz der Datensätze
- Feinabstimmung und was sich mit vielfältigen Daten ändert
- Checkliste CLEAR Derm und was man vom Anbieter verlangen sollte
- Was sich bei der klinischen Entscheidung ändert
- Die Studien im Überblick
- Wie NEXO hilft, dieses Denken zu trainieren
- Häufige Fragen
- Take-home messages
Warum KI für die Haut zum Versprechen und zum Risiko wurde
Die automatische Klassifikation von Hautläsionen erhielt Aufmerksamkeit, nachdem tiefe neuronale Netze bei Melanom- und Karzinomaufgaben in großen Datenbanken mit Dermatologen gleichzogen (Esteva et al., 2017). Die Stanford-Studie trainierte mit 129.450 Bildern und testete an 2.032 biopsierten Bildern, mit einer Leistung nahe der von 21 zertifizierten Dermatologen (Esteva et al., 2017).
Der Sprung von 2017 und die Warnung von 2018
Dieser Meilenstein beschleunigte Apps, Teledermatologie und die Hoffnung auf Screening in der Grundversorgung. Im Jahr darauf warnten Adamson und Smith, dass Modelle, die mit wenig repräsentativen Daten trainiert wurden, Ungleichheiten verstärken können, wenn sie eingesetzt werden, ohne die Leistung nach Untergruppe zu messen (Adamson und Smith, 2018). Die Warnung nahm vorweg, was Diverse Dermatology Images (DDI) Jahre später mit Zahlen maß.
Das Versprechen gilt weiterhin für häufige Läsionen in ausgewogenen Datenbanken, aber die klinische Frage lautet nicht mehr "Liegt der Algorithmus richtig?", sondern "Bei wem liegt er richtig?". Dieser Wechsel der Frage hängt mit der Nutzung künstlicher Intelligenz im klinischen Denken zusammen und mit dem Risiko, der Maschine zu sehr zu vertrauen.
Was Diverse Dermatology Images gemessen hat
Das DDI wurde geschaffen, um Algorithmen an klinisch bestätigten Bildern zu testen, mit vielfältigen Hauttönen und häufigen wie ungewöhnlichen Erkrankungen (Daneshjou et al., 2022). Nach Ausschluss von Fotos, die die Qualitätskontrolle nicht bestanden, blieben 656 Bilder übrig, ausgewogen zwischen gutartig und bösartig an den Fitzpatrick-Extremen (Daneshjou et al., 2022).
Zusammensetzung des Datensatzes
Es gab 208 Bilder von Fitzpatrick I-II (159 gutartig und 49 bösartig), 241 von III-IV und 207 von V-VI (159 gutartig und 48 bösartig) (Daneshjou et al., 2022). Die Teilmengen der Extreme wurden nach diagnostischer Klasse gepaart, um helle und dunkle Hauttöne zu vergleichen.
Leistung der drei Algorithmen
Im vollständigen DDI erreichte ModelDerm eine Fläche unter der ROC-Kurve von 0,65 (95-Prozent-KI 0,61 bis 0,70), DeepDerm 0,56 (0,51 bis 0,61) und das auf HAM10000 trainierte Modell 0,67 (0,62 bis 0,71) (Daneshjou et al., 2022). In den eigenen Testsets hatten diese Algorithmen deutlich höhere Werte erreicht, was den Rückgang beim Verlassen der ursprünglichen Umgebung zeigt.
Im Vergleich zwischen Fitzpatrick I-II und V-VI fiel ModelDerm von 0,64 (0,55 bis 0,7) auf 0,55 (0,46 bis 0,64), DeepDerm von 0,61 (0,50 bis 0,71) auf 0,50 (0,41 bis 0,58) und HAM10000 von 0,72 (0,63 bis 0,79) auf 0,57 (0,48 bis 0,67) (Daneshjou et al., 2022). Die Sensitivität sank bei ModelDerm von 0,41 auf 0,12 und bei DeepDerm von 0,69 auf 0,23 (Daneshjou et al., 2022).
Auch Dermatologen scheitern an dunkler Haut
Das DDI bat drei Dermatologen, jedes Bild als gutartigen oder bösartigen Prozess zu klassifizieren, und bildete eine Mehrheitsentscheidung (Daneshjou et al., 2022). Die Labels der Fachleute übertrafen die Algorithmen vor der Feinabstimmung, doch auch die Sensitivität der Dermatologen sank von 0,72 bei Fitzpatrick I-II auf 0,59 bei V-VI (Daneshjou et al., 2022).
Der Test mit 848 Ärzten
Groh und Kollegen führten ein digitales Experiment mit 389 Dermatologen und 459 Ärzten der Primärversorgung aus 39 Ländern durch, die 364 Bilder von 46 Erkrankungen in einer Simulation der Teledermatologie bewerteten (Groh et al., 2024). Die diagnostische Genauigkeit lag bei 38 Prozent unter Dermatologen und bei 19 Prozent unter Allgemeinmedizinern, und beide Gruppen waren bei dunkler Haut um 4 Prozentpunkte weniger genau (Groh et al., 2024). Die Unterstützung durch einen Algorithmus des tiefen Lernens erhöhte die Genauigkeit um mehr als 33 Prozent, vergrößerte aber den Unterschied zwischen den Hauttönen bei den Allgemeinmedizinern (Groh et al., 2024). Die Autoren schließen, dass eine höhere Gesamtgenauigkeit für sich genommen den Bias nicht behebt (Groh et al., 2024).
Warum das für das Training zählt
Viele Datenbanken verwenden Labels von Dermatologen als Referenzwahrheit. Ist der menschliche Fehler bei dunklen Hauttönen und bei ungewöhnlichen Erkrankungen größer, erbt der Algorithmus diesen Fehler und kann ihn verstärken (Daneshjou et al., 2022). Die Diskussion überschneidet sich mit implizitem Bias in der Diagnose und mit der Kalibrierung des Vertrauens: Treffer und Sicherheit gehen nicht zusammen, wenn sich die Untergruppe ändert.
Unsere Zusammenfassung ist, dass der Dermatologe weiterhin unverzichtbar ist, aber kein von fotografischem Bias freier Goldstandard; seine Rolle ist, den Algorithmus zu filtern, nicht nur die Datenbank zu labeln.
Transparenz der Datensätze
Vor dem DDI untersuchte die Scoping-Review in JAMA Dermatology 70 Studien zum tiefen Lernen in der Dermatologie (Daneshjou et al., 2021). Von 1.065.291 Bildern, die zur Entwicklung oder zum Test von Algorithmen verwendet wurden, waren nur 257.372 (24,2 Prozent) öffentlich verfügbar (Daneshjou et al., 2021).
Was fast niemand berichtet
Nur 14 Studien (20,0 Prozent) beschrieben Ethnie oder Rasse in mindestens einem Datensatz, und nur 7 (10,0 Prozent) gaben irgendeine Angabe zum Hautton an (Daneshjou et al., 2021). Ohne diese Information kann der Leser nicht wissen, ob das Modell an der Bevölkerung getestet wurde, in der es eingesetzt wird.
Öffentliche Datenbanken und Netzeffekt
Öffentliche Datensätze wurden häufiger zitiert als private, was das Training auf wenige Quellen und auf Fotografien mit ähnlichem demografischem Profil konzentriert (Daneshjou et al., 2021). Eine unsere Hypothesen ist, dass die Wiederholung derselben Datenbanken einen Teil des im DDI beobachteten Rückgangs erklärt, wenn sich das klinische Szenario ändert.
Die Scoping-Review zeigte außerdem, dass der Median der Bilder in Studien, die neue Algorithmen trainierten, bei etwa 10.000 lag, mit großer Streuung, was die Ungleichheit der Ressourcen zwischen Forschungsgruppen verstärkt (Daneshjou et al., 2021). Ohne öffentliche Daten und ohne demografische Beschreibung kann die klinische Gemeinschaft die Leistung nach Untergruppe vor dem Kauf oder der Einführung weder reproduzieren noch prüfen.
Was die öffentlichen Datenbanken enthalten
Wen und Kollegen überprüften systematisch 21 offen zugängliche Bilddatenbanken für Hautkrebs mit 106.950 Bildern (Wen et al., 2022). Von den 14 Datenbanken, die das Herkunftsland angaben, stammten 11 (79 Prozent) aus Europa, Nordamerika und Ozeanien, und 19 Datenbanken (91 Prozent) enthielten nur dermatoskopische oder makroskopische Bilder (Wen et al., 2022). Die Ethnizität war für 1.415 Bilder verfügbar (1,3 Prozent) und der Fitzpatrick-Fototyp für 2.236 (2,1 Prozent) (Wen et al., 2022). Die Autoren fordern Qualitätsstandards für die Metadaten der Datenbanken (Wen et al., 2022).
Diese Undurchsichtigkeit erinnert an die Warnung des Berichts über Diagnosefehler: Systeme, die Fehler nicht nach Untergruppe messen, wiederholen Ungleichheit, das Thema des Textes über den Bericht Improving Diagnosis.
Feinabstimmung und was sich mit vielfältigen Daten ändert
Die Autoren des DDI trainierten DeepDerm und das HAM10000-Modell mit vielfältigen Bildern neu (Daneshjou et al., 2022). Nach der Feinabstimmung erreichte DeepDerm eine Fläche unter der Kurve von 0,73 (95-Prozent-KI 0,70 bis 0,77) bei Fitzpatrick I-II und 0,76 (0,71 bis 0,80) bei V-VI (Daneshjou et al., 2022).
HAM10000 nach der Feinabstimmung
Das auf HAM10000 basierende Modell erreichte 0,77 (0,73 bis 0,80) bei I-II und 0,78 (0,75 bis 0,81) bei V-VI (Daneshjou et al., 2022). Die Lücke zwischen hellen und dunklen Hauttönen schloss sich, und die Leistung erreichte oder übertraf in mehreren Datenabschnitten die Abstimmung der Dermatologen.
Einordnung für die Klinik
Das Ergebnis bedeutet nicht, dass jede kommerzielle Anwendung bereits angepasst wurde. Es bedeutet, dass der Fehler behebbar ist, wenn gekennzeichnete und vielfältige Bilder vorliegen, und dass die Forderung nach Testbelegen nach Hautton eine berechtigte Frage vor der Einführung ist. Die narrative Übersichtsarbeit von 2025 kam zu einem ähnlichen Schluss: Die meisten Studien zeigten eine schlechtere Genauigkeit bei Fitzpatrick IV-VI, mit Verbesserung nach Training mit vielfältigen Datensätzen (Dowie, 2025).
Hautton ist nicht dasselbe wie Rasse
Fitzpatrick wurde entwickelt, um die Reaktion auf ultraviolettes Licht zu schätzen, nicht um Abstammung abzubilden. Ulrich und Kollegen beschrieben eine automatisierte Methode, die den Hautton schätzt und ihn in die Skalen Monk und Fitzpatrick umrechnet; bei der Validierung mit 3D-Körperscans und KI-generierten Bildern war die Übereinstimmung mit Monk hoch und mit Fitzpatrick weniger konsistent (Ulrich et al., 2025).
Warum die Unterscheidung in der Sprechstunde zählt
Selbst angegebene Rasse, Ethnizität und der auf dem Foto gemessene Hautton beantworten unterschiedliche Fragen. Ein Algorithmus kann wegen Pigmentierung, wegen Beleuchtung, wegen des Läsionstyps oder wegen einer Mischung dieser Faktoren versagen (Daneshjou et al., 2022; Ulrich et al., 2025). "Dunkle Haut" als einzige Kategorie zu behandeln, ohne die Methode der Klassifizierung zu beschreiben, verbirgt den Mechanismus des Fehlers.
In der Praxis hilft der Kliniker, der den beobachteten Hautton und die Qualität des Fotos dokumentiert, sowohl der Prüfung des Algorithmus als auch dem menschlichen Denken, im selben Geist, Etiketten zu vermeiden, die den Rest des Bildes verbergen.
CLEAR Derm Checkliste und was man vom Anbieter verlangen sollte
Die KI-Arbeitsgruppe der International Skin Imaging Collaboration veröffentlichte CLEAR Derm, eine Checkliste guter Praxis für Entwicklung und Bewertung bildbasierter KI in der Dermatologie (Daneshjou et al., 2022). Das Dokument umfasst Datenkuratierung, Modellaufbau und Bewertung, mit Aufmerksamkeit für fotografische Verzerrung und ethische Erwägungen (Daneshjou et al., 2022).
Fünf praktische Fragen (unsere Zusammenfassung)
Bevor ein Klassifikator in die Routine aufgenommen wird, umfasst eine Liste von uns, nicht als Instrument validiert:
- Wurde die Leistung nach Hautton oder nach einer gleichwertigen Skala berichtet?
- Ist der Testsatz extern zum Trainingssatz?
- Gibt es Sensitivitäts- und Spezifitätsraten nach Untergruppe, nicht nur die globale Fläche unter der Kurve?
- Sind die Trainingsbilder öffentlich prüfbar oder zumindest in ihrer demografischen Zusammensetzung beschrieben?
- Gibt es einen Plan für menschliche Aufsicht und für die Dokumentation, wenn Algorithmus und Kliniker nicht übereinstimmen?
Diese Fragen stehen im Dialog mit der kritischen Lektüre von Artikeln und mit der Sorgfalt im Melanom-Team, in dem das Bild nur ein Schritt auf dem Weg ist.
Beleuchtung, Aufnahme und der Weg bis zum Pixel
Der Algorithmus sieht nur, was die Kamera liefert. Seitenlicht, Schatten, Dateikomprimierung und ein farbiger Hintergrund verändern die scheinbare Textur und Farbe. Die Übersicht über Prinzipien und Anwendungen der KI in der Dermatologie bestätigt, dass die Bildqualität und die Repräsentativität der Datenbank jedes Modell begrenzen (Omiye et al., 2023).
Was in der Praxis standardisiert werden sollte
Eine operative Liste von uns, die auf den in den Studien beschriebenen Grenzen beruht und nicht als Protokoll getestet wurde, umfasst:
- Frontales, diffuses Licht verwenden und hartes Blitzlicht vermeiden, das die Glanzlichter überstrahlt.
- Die Läsion mit einem Rand gesunder Haut ringsum erfassen.
- Bei Verlaufsfotos denselben Abstand und denselben Winkel beibehalten.
- Gerät und Datum zusammen mit der klinischen Datei erfassen.
- Keine verschwommenen Fotos oder Fotos mit Beauty-Filter an den Algorithmus senden.
Diese Vorsichtsmaßnahmen gelten auch für Reisekrankheitsläsionen und für Differenzialdiagnosen der Haut bei Mpox und bei Reisedermatosen, selbst wenn der Algorithmus nicht in die Entscheidung einbezogen wird.
Was sich bei der klinischen Entscheidung ändert
In der Primärversorgung bedeutet das, die Biopsieentscheidung nicht an einen Score zu delegieren, ohne zu wissen, in welcher Population er validiert wurde. Dieselbe Vorsicht gilt, wenn das Foto per Nachricht eintrifft: schlechte Qualität und ein Hautton außerhalb der Trainingsdatenbank erhöhen die Unsicherheit, und der Kliniker muss dem Patienten das klar sagen.
Angesichts eines algorithmischen Scores braucht der Kliniker weiterhin die Anamnese, die Untersuchung und den epidemiologischen Kontext. Eine Hypothese von uns ist, dass das größere Risiko nicht das falsch positive Ergebnis auf heller Demonstrationshaut ist, sondern das falsch negative Ergebnis auf dunkler Haut, wenn die App mit scheinbarer Sicherheit "wahrscheinlich gutartig" vorschlägt.
Wie man integriert, ohne den Abschluss zu automatisieren
Praktische Empfehlungen, als Zusammenfassung gekennzeichnet:
- Das Ergebnis des Algorithmus als Hinweis behandeln, nicht als Befund.
- Eine Entscheidung allein aufgrund eines Scores ablehnen, wenn der Hautton oder die Erkrankung außerhalb des Spektrums der Validierungsstudie liegen.
- Die Uneinigkeit zwischen Kliniker und Maschine für eine spätere Prüfung dokumentieren.
- Biopsie oder Überweisung vorrangig erwägen, wenn die Läsion klinisch verdächtig ist, unabhängig von der App.
- Dem Patienten keine "Bestätigung durch künstliche Intelligenz" ankündigen, ohne die Grenzen zu erklären.
Diese Nutzung passt zum Training der Differenzialdiagnose mit Hinweisen und verringert den diagnostischen Fehler in der Primärversorgung, der mit einem vorschnellen Abschluss zusammenhängt.
Wenn Algorithmus und Klinik voneinander abweichen
Wirkt die Läsion bei der Untersuchung verdächtig und schlägt die App Gutartigkeit vor, richtet sich das Vorgehen nach der Klinik. Der DDI zeigte eine niedrige Sensitivität bei Fitzpatrick V-VI gerade in den Teilen, in denen das falsch negative Ergebnis am meisten schmerzt (Daneshjou et al., 2022). In diesen Fällen wiegen Biopsie, Dermatoskopie in der Praxis oder eine Zweitmeinung mehr als der Score.
Eine Zusammenfassung von uns ist, in der Patientenakte das Ergebnis des Algorithmus, den beobachteten Hautton und die endgültige Entscheidung zu erfassen. Diese Erfassung schafft die lokale Prüfungsgrundlage, die multizentrische Studien nach Untergruppe noch selten veröffentlichen.
Grenzen, die der Text nicht auflöst
Die Zahlen des DDI stammen aus einem kuratierten Datensatz an einem akademischen Zentrum und messen nicht die Leistung jeder heute verfügbaren kommerziellen App. Die narrative Übersicht von Dowie wählte nach restriktiven Filtern nur wenige Artikel aus (Dowie, 2025). Ulrich validiert eine Methode zur Klassifizierung des Hauttons, nicht einen Krebsklassifikator (Ulrich et al., 2025).
Daher wäre die Verallgemeinerung "jede KI für Haut versagt" eine unzulässige Schlussfolgerung. Was die Daten stützen, ist enger: Algorithmen, die mit wenig transparenten und wenig vielfältigen Datenbanken trainiert wurden, haben ein messbares Risiko schlechterer Leistung bei dunklen Hauttönen, und dieses Risiko sinkt, wenn Training und Test diese Bilder gezielt einschließen (Daneshjou et al., 2022; Daneshjou et al., 2021).
Was der Kliniker in die nächste Konsultation mitnimmt
Nach der Lektüre des DDI und der Übersicht zur Transparenz besteht die praktische Änderung nicht darin, die Technologie aufzugeben, sondern dieselbe Strenge zu verlangen, die man von einem neuen Labortest verlangt. Eine Zusammenfassung von uns, im Einklang mit den zitierten Befunden, ist, die Konsultation in drei Schritte zu gliedern: (1) Qualität des Fotos und beobachteter Hautton; (2) Ergebnis des Algorithmus als Hinweis, nie als Befund; (3) dokumentierte Entscheidung bei Uneinigkeit.
Wie man dem Patienten die Grenze erklärt
Eine eigene Formulierung von uns, nicht als Skript getestet, lautet: Die Anwendung hilft, Hypothesen zu ordnen, wurde aber vor allem mit Bildern bestimmter Hauttöne trainiert, und die Entscheidung für Biopsie oder Beobachtung bleibt klinisch. Das vermeidet sowohl das blinde Verwerfen des Werkzeugs als auch das automatische Vertrauen, das der Automatisierungsbias beschreibt.
Minimale Prüfung im Versorgungsbetrieb
Für Einrichtungen, die bereits einen Klassifikator nutzen, umfasst eine operative Liste von uns: monatlich die Fälle prüfen, in denen Algorithmus und Dermatologe voneinander abwichen, die Dateien nach beobachtetem Hautton trennen und prüfen, ob sich die falsch negativen Befunde bei Fitzpatrick V-VI häufen, wie es das DDI vorhersagte (Daneshjou et al., 2022). Ohne diesen Zyklus wiederholt die Einrichtung die Undurchsichtigkeit, die die Übersicht über 70 Studien dokumentierte (Daneshjou et al., 2021).
Derselbe Gedanke der Messung nach Untergruppe zeigt sich in der teambezogenen Melanomversorgung und in der Vorbeugung vorschneller Entlassung, Thema des Trainings der Differenzialdiagnose mit Hinweisen. Technologie verringert Schaden nur, wenn die Einrichtung weiß, bei wem sie versagt.
Studien im Überblick
| Studie | Design, Stichprobe und Einheit | Wichtigster Befund |
|---|---|---|
| Esteva 2017 | Neuronales Netz; 129.450 Trainingsbilder, 2.032 Testbilder | Leistung nahe der von Dermatologen im eigenen Datensatz |
| Adamson 2018 | Kommentar | Warnung vor Ungleichheit, wenn die Messung nach Untergruppe fehlt |
| Daneshjou 2021 | Scoping-Review; 70 Studien | Geringe Transparenz zu Ethnie und Hautton |
| Daneshjou 2022 (DDI) | Externe Bewertung; 656 Bilder | Rückgang von AUC und Sensitivität bei Fitzpatrick V-VI |
| Wen 2022 | Systematische Übersicht; 21 öffentliche Datensätze, 106.950 Bilder | Fitzpatrick bei 2,1 Prozent der Bilder angegeben (Wen et al., 2022) |
| Groh 2024 | Digitales Experiment; 848 Ärzte, 364 Bilder | Dunkle Haut mit geringerer Genauigkeit; die Unterstützung durch KI vergrößerte den Unterschied zwischen Allgemeinmedizinern (Groh et al., 2024) |
| CLEAR Derm 2022 | Konsens-Checkliste | Punkte zu Daten, Modell und fairer Bewertung |
| Omiye 2023 | Narrative Übersicht | Grenzen von Bild und Repräsentativität |
| Dowie 2025 | Narrative Übersicht; 8 endgültige Artikel | Schlechtere Genauigkeit bei dunklen Tönen; Besserung mit vielfältigen Daten |
| Ulrich 2025 | Methode zur Analyse des Hauttons | Monk-Skala mit besserer Übereinstimmung in einigen Tests |
Quellen: Esteva et al., 2017; Adamson und Smith, 2018; Daneshjou et al., 2021; Daneshjou et al., 2022; Daneshjou et al., 2022; Wen et al., 2022; Groh et al., 2024; Omiye et al., 2023; Dowie, 2025; Ulrich et al., 2025.
Wie NEXO hilft, dieses Denken zu trainieren
Bei NEXO ist der Fall des Tages fiktiv, mit realer klinischer Darstellung und bis zu sechs fortschreitenden Hinweisen, und Sie schlagen die Diagnose vor, indem Sie den Code in der ICD-10 suchen. Ein Hinweis kann lauten: "asymmetrischer Fleck am Rücken, Patient mit dunklem Hautton"; ein anderer: "Hautanwendung schlug Benignität mit geringer Zuversicht vor". Die Rückmeldung zur Nähe in fünf Stufen hilft, Nävus, Melanom, Basalzellkarzinom und Dermatitis zu unterscheiden, ohne das Training in ein Softwareprotokoll zu verwandeln.
Häufige Fragen
Versagt jede Hautanwendung bei dunklem Ton?
Die drei im DDI getesteten Spitzenalgorithmen fielen bei Fitzpatrick V-VI ab, und spätere Übersichten fanden dasselbe Muster in den meisten Studien (Daneshjou et al., 2022; Dowie, 2025).
Löst eine Anpassung des Modells mit vielfältigen Daten das Problem?
Im DDI schloss die Feinabstimmung die Lücke zwischen I-II und V-VI beim DeepDerm und beim HAM10000-Modell, aber jedes kommerzielle Produkt muss den eigenen Test vorlegen (Daneshjou et al., 2022).
Sind Dermatologen gegen den Bias des Fotos immun?
Die Sensitivität des Mehrheitsvotums sank im DDI zwischen hellen und dunklen Tönen von 0,72 auf 0,59 (Daneshjou et al., 2022).
Sind Hautton und Ethnie dieselbe Variable?
Fitzpatrick beschreibt die Reaktion auf Licht; Ethnie und Herkunft sind unterschiedliche soziale Kategorien, und Skalen wie Monk versuchen, den im Bild beobachteten Ton zu erfassen (Ulrich et al., 2025).
Was sollte man vor der Einführung eines Klassifikators verlangen?
Leistung nach Untergruppe des Hauttons, externe Testung, Sensitivität und Spezifität, nicht nur die Fläche unter der globalen Kurve, und einen Plan zur menschlichen Aufsicht, im Sinne von CLEAR Derm (Daneshjou et al., 2022).
Take-home messages
- Spitzenalgorithmen verloren im DDI AUC und Sensitivität bei dunkler Haut (Daneshjou et al., 2022).
- Die meisten Studien zu KI in der Dermatologie berichten weder Ethnie noch Hautton (Daneshjou et al., 2021).
- Eine Feinabstimmung mit vielfältigen Bildern kann die Lücke schließen, wenn Daten und Prüfung vorhanden sind (Daneshjou et al., 2022).
- Auch Dermatologen irren bei dunklen Hauttönen häufiger, und die Unterstützung durch KI kann den Unterschied zwischen Generalisten vergrößern (Daneshjou et al., 2022; Groh et al., 2024).
- Der Kliniker sollte den Score als Hinweis behandeln und Transparenz im Stil von CLEAR Derm verlangen (Daneshjou et al., 2022).
Literatur
- Esteva A, Kuprel B, Novoa RA, et al. Dermatologist-level classification of skin cancer with deep neural networks. Nature. 2017;542(7639):115-118. PMID: 28117445. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC8382232/
- Adamson AS, Smith A. Machine Learning and Health Care Disparities in Dermatology. JAMA Dermatol. 2018;154(11):1247-1248. PMID: 30073260. https://pubmed.ncbi.nlm.nih.gov/30073260/
- Daneshjou R, Smith MP, Sun MD, et al. Lack of Transparency and Potential Bias in Artificial Intelligence Data Sets and Algorithms: A Scoping Review. JAMA Dermatol. 2021;157(11):1362-1369. PMID: 34550305. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC9379852/
- Daneshjou R, Vodrahalli K, Novoa RA, et al. Disparities in dermatology AI performance on a diverse, curated clinical image set. Sci Adv. 2022;8(32):eabq6147. PMID: 35960806. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC9374341/
- Daneshjou R, Barata C, Betz-Stablein B, et al. Checklist for Evaluation of Image-Based Artificial Intelligence Reports in Dermatology: CLEAR Derm Consensus Guidelines from the International Skin Imaging Collaboration Artificial Intelligence Working Group. JAMA Dermatol. 2022;158(1):58-66. PMID: 34851366. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC9845064/
- Omiye JA, Gui H, Daneshjou R, et al. Principles, applications, and future of artificial intelligence in dermatology. Front Med (Lausanne). 2023;10:1278232. PMID: 37901399. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC10602645/
- Dowie T. Exploring the Diagnostic Capability of Artificial Intelligence in Dermatology for Darker Skin Tones: A Narrative Review. Cureus. 2025;17(10):e94909. PMID: 41262830. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC12624499/
- Ulrich P, Zink A, Biedermann T, Sitaru S. Beyond Fitzpatrick: automated artificial intelligence-based skin tone analysis in dermatological patients. NPJ Digit Med. 2025;8:378. PMID: 40537526. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC12179258/
- Wen D, Khan SM, Ji Xu A, et al. Characteristics of publicly available skin cancer image datasets: a systematic review. Lancet Digit Health. 2022;4(1):e64-e74. PMID: 34772649. https://pubmed.ncbi.nlm.nih.gov/34772649/
- Groh M, Badri O, Daneshjou R, et al. Deep learning-aided decision support for diagnosis of skin disease across skin tones. Nat Med. 2024;30(2):573-583. PMID: 38317019. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC10878981/