Инфекционные болезниТропическая медицина и путешествияПервичная медицинская помощь
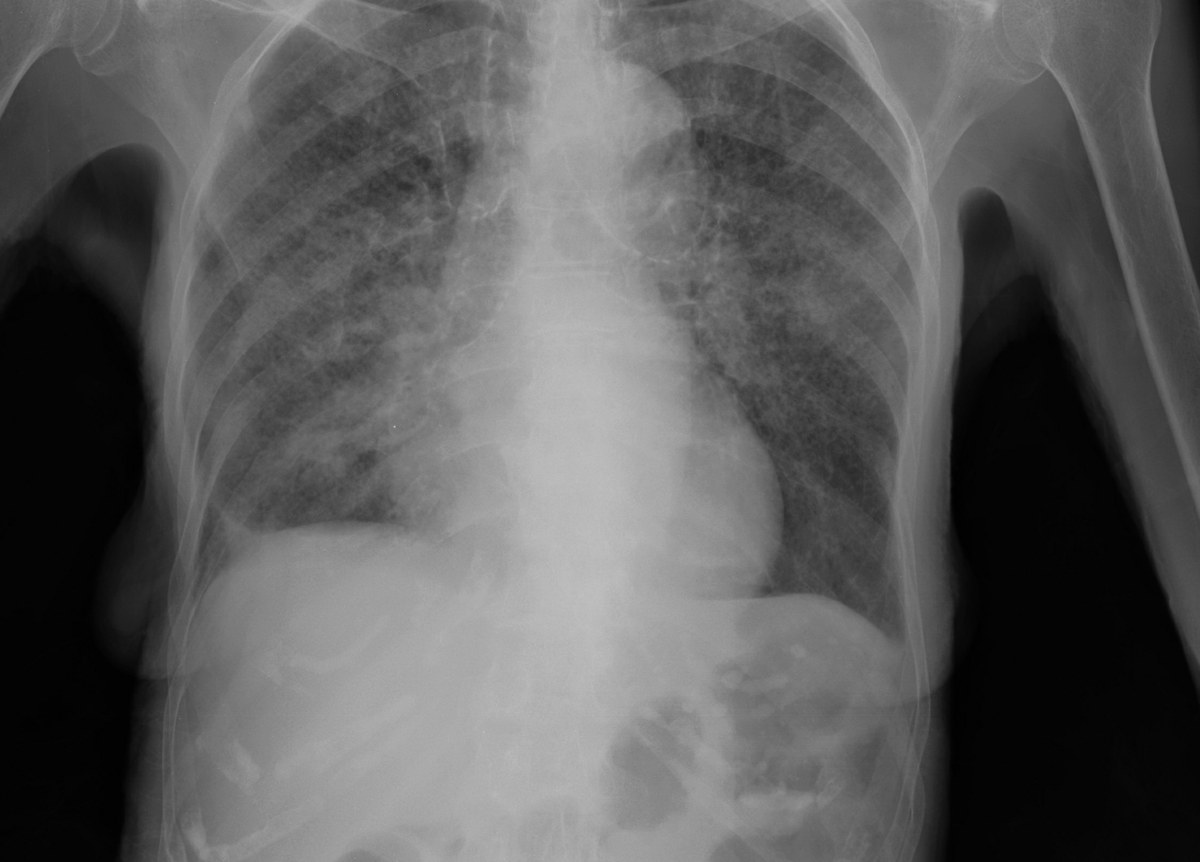
В вымышленном случае мобильная бригада приезжает в густонаселённый район города с высокой нагрузкой туберкулёза. За один день сотни взрослых делают цифровую рентгенографию грудной клетки, а на весь регион есть единственный рентгенолог, который увидит снимки только через несколько недель. Бригада решает, что программа будет присваивать каждому снимку балл от 0 до 100, и тех, у кого балл превысит определённое число, направят на молекулярный тест мокроты. Вопрос, который раскалывает бригаду, легко сформулировать и трудно решить: какое число использовать?
Компьютерная диагностика, известная по английской аббревиатуре CAD, вошла в рекомендацию Всемирной организации здравоохранения (ВОЗ) в 2021 году как альтернатива человеческому чтецу при скрининге и сортировке туберкулёза. Сама ВОЗ, однако, настаивает, что порог нужно калибровать для каждого контекста, потому что одна и та же программа с одним и тем же порогом ведёт себя по-разному в разных популяциях.
Этот текст показывает, что рекомендовала ВОЗ и с какой силой, как исследования измеряют точность таких программ, что происходит с ложноположительными результатами, когда порог снижается, и в каких группах программа чаще ошибается.
Главные пункты
Туберкулёз — главная причина смерти от одного инфекционного агента, и в 2024 году он убил 1,23 миллиона человек, из которых 150 000 жили с ВИЧ, согласно информационному листку ВОЗ (ВОЗ, 2026). В том же году заболели 10,7 миллиона человек: 5,8 миллиона мужчин, 3,7 миллиона женщин и 1,2 миллиона детей.
Болезнь сосредоточена там, где меньше ресурсов. Более 80 процентов случаев заболевания и смерти приходится на страны с низким и средним доходом, а регионы Юго-Восточной Азии, Западной части Тихого океана и Африки дают большую часть нагрузки (ВОЗ, 2026). Путешественники и специалисты, которые принимают людей из этих регионов, встречают тот же диагностический вопрос в другом сценарии.
Главная проблема — разрыв между теми, кто заболевает, и теми, кому ставят диагноз. В документе 2021 года ВОЗ напоминает, что в 2019 году около 2,9 миллиона из 10 миллионов человек с туберкулёзом не были диагностированы или не были зарегистрированы (ВОЗ, 2021). У части этих людей мало симптомов или их нет вовсе, и они обнаруживаются, только когда кто-то активно их ищет.
ВОЗ разделяет два применения рентгенографии (ВОЗ, 2021). При скрининге рентгенографию предлагают популяции в группе риска, с симптомами или без, и распространённость туберкулёза обычно остаётся ниже 5 процентов (ВОЗ, 2021). При сортировке рентгенографию делают людям, которые уже обратились в службу с симптомами, и распространённость в целом составляет от 10 до 20 процентов, согласно тому же документу (ВОЗ, 2021).
Эта разница в распространённости очень важна. Как обсуждается в разделе предтестовая вероятность, один и тот же тест с одной и той же чувствительностью и специфичностью даёт очень разные доли ложноположительных результатов в зависимости от того, редка или часта болезнь в тестируемой популяции. Забыть об этом — значит попасть в ошибку, описанную в разделе базовая частота в диагностике.
В обоих случаях рентгенография ничего не подтверждает. Пациент с аномальной картиной направляется на бактериологическое исследование, например на быстрый молекулярный тест мокроты, и именно этот тест подтверждает заболевание.
Модуль 2 сводных руководств ВОЗ по туберкулёзу, посвящённый скринингу, принёс новую рекомендацию об автоматизированном чтении (ВОЗ, 2021). В вольном переводе текст говорит, что среди лиц от 15 лет и старше в популяциях, где рекомендован скрининг туберкулёза, программы компьютерного обнаружения могут использоваться вместо людей-читателей для интерпретации цифровых рентгенограмм грудной клетки при скрининге и сортировке заболевания. Само руководство классифицирует рекомендацию как условную, с низкой уверенностью в доказательствах.
Обе оговорки имеют вес. Условная рекомендация означает, что группа, разработавшая руководство, сочла, что польза, вероятно, перевешивает риски, но решение зависит от контекста, ресурсов и местных ценностей. Низкая уверенность указывает на то, что новые исследования могут изменить оценку эффекта.
Группа разработчиков руководства рассмотрела три независимые оценки трёх продуктов с маркировкой CE по состоянию на январь 2020 года и провела анализ, не зная, какие это бренды (ВОЗ, 2021). Рекомендация действует для цифровых рентгенограмм в заднепередней или переднезадней проекции. За рамками остались боковая и косая проекции, а эффективность на оцифрованных аналоговых рентгенограммах неизвестна.
Документ также очерчивает цель. Точность измерялась относительно бактериологически подтверждённого туберкулёза, и программное обеспечение не выявляет других лёгочных заболеваний, кроме туберкулёза; данных об эффективности в дифференциальной диагностике не было (ВОЗ, 2021). Это отделяет данную тему от случайной находки, обсуждаемой в материале случайный лёгочный узел и вероятность: там снимок сделан по другой причине, и рассуждение исходит из вероятности рака; здесь снимок делается намеренно, массово, чтобы найти одно-единственное заболевание.
Наконец, рекомендация применима к продуктам, которые не окажутся хуже оценённых при внешней валидации. ВОЗ также упоминает потенциал расширения доступа там, где не хватает рентгенологов, но ставит осуществимость в зависимость от оборудования, интернет-соединения и технического обслуживания (ВОЗ, 2021).
Группа сравнила программное обеспечение с людьми-читателями, используя один и тот же бактериологический эталон. Для этого порог программного обеспечения зафиксировали в точке, где чувствительность достигала около 90 процентов, и сравнили полученную специфичность со специфичностью читателей (ВОЗ, 2021). Это число взято из целевого профиля продукта ВОЗ, который требует чувствительности выше 0,90 и специфичности выше 0,70 для скринингового теста.
| Применение | Читатель | Чувствительность | Специфичность |
|---|---|---|---|
| Целевой профиль продукта | Цель | выше 0,90 | выше 0,70 |
| Скрининг | Программное обеспечение CAD | 0,90–0,92 | 0,23–0,66 |
| Скрининг | Человек-читатель | 0,82–0,93 | 0,14–0,63 |
| Сортировка | Программное обеспечение CAD | 0,90–0,91 | 0,25–0,79 |
| Сортировка | Человек-читатель | 0,89–0,96 | 0,36–0,63 |
Источники: ВОЗ, 2021, Модуль 2, таблица 4 документа; значения выражены как доли, интервалы между исследованиями, без объединённой оценки.
Таблица показывает то, что ВОЗ назвала небольшой разницей между программным обеспечением и человеком-читателем. Диапазоны специфичности широки в обеих группах, и документ не объединил оценки в мета-анализ (ВОЗ, 2021). Вывод состоял в сходной точности, а не в превосходстве.
Более ранний систематический обзор помогает понять, почему ВОЗ проявила осторожность (Harris et al., 2019). Авторы собрали 53 исследования, 40 по разработке и 13 клинических. Медиана площади под кривой составила 0,88 в исследованиях по разработке и 0,75 в клинических, а специфичность в клинических исследованиях варьировала от 0,23 до 0,69. Авторы не проводили мета-анализ из-за неоднородности и риска систематической ошибки.
Разрыв между лабораторией и реальным миром обычен для инструментов ИИ. То же явление проявляется в материале автономный ИИ в скрининге диабетической ретинопатии, где именно проспективная валидация придала credibilidade клиническому применению. Читателям, которым нужен более широкий взгляд на тему, может быть полезен материал использование искусственного интеллекта в клиническом мышлении.
Две независимые оценки проверили несколько программ на одном и том же наборе изображений. В ретроспективном исследовании с участием 1196 амбулаторных пациентов из Непала и Камеруна, где эталоном служил молекулярный тест, у трёх программ площадь под кривой составила от 0,92 до 0,94 (Qin et al., 2019). Авторы подсчитали, что программное обеспечение могло бы сократить на 66 процентов число необходимых молекулярных тестов, сохраняя чувствительность на уровне 95 процентов или выше (Qin et al., 2019).
Во Вьетнаме библиотеку из 1032 рентгенограмм использовали, чтобы сравнить 12 программ с заключением эксперта и заключением специалиста среднего уровня (Codlin et al., 2021). Шесть программ показали результат, эквивалентный заключению эксперта. Авторы называют ограничениями происхождение данных из одного региона, ретроспективный дизайн и выборку со смещением в сторону людей с подозрением на туберкулёз.
Программа не говорит «туберкулёз» или «норма». Она выдаёт непрерывную оценку, и кто-то должен выбрать, начиная с какого значения изображение будет считаться аномальным. Качественный обзор с пользователями из девяти стран с высокой нагрузкой суммирует дилемму: повышение порога делает программу более специфичной и менее чувствительной, понижение порога даёт обратное, и ни один порог не бывает одновременно идеально чувствительным и идеально специфичным (Creswell et al., 2023). Лучшая точка — та, что уравновешивает точность с объёмом подтверждающих обследований, которые служба способна принять.
Работу Vanobberghen и коллег авторы описывают как вторичный анализ национального обследования распространённости туберкулёза в Лесото 2019 года (Vanobberghen et al., 2024). В нём участвовали 17 070 человек в возрасте 15 лет и старше. Поскольку бактериологическое исследование проходили только те, у кого были симптомы или изменённая рентгенограмма, статус по туберкулёзу был определён лишь у 5214 участников, и у 142 из них была болезнь.
Чтобы учесть тех, кого не обследовали, авторы сравнили шесть методов. При множественном вменении порог 13 дал чувствительность 89,7 процента с 95-процентным доверительным интервалом от 84,6 до 94,8 и специфичность 74,2 процента с интервалом от 73,6 до 74,9 (Vanobberghen et al., 2024). Предположение, что все необследованные были отрицательными, привело к похожим результатам.
| Порог программы | Чувствительность (процентов) | Специфичность (процентов) |
|---|---|---|
| 3 | 96,5 | 38,1 |
| 5 | 93,7 | 54,2 |
| 8 | 91,5 | 65,5 |
| 10 | 90,1 | 69,7 |
| 13 | 90,1 | 74,2 |
Источники: Vanobberghen et al., 2024, таблица 3, подход, при котором необследованные считаются отрицательными; оценка от 0 до 100 для конкретной версии программы.
Между порогами 13 и 10 чувствительность осталась прежней, а специфичность снизилась. От порога 13 к порогу 3 чувствительность выросла на 6,4 процентного пункта, тогда как специфичность потеряла 36,1 пункта. Авторы называют падение специфичности на более низких порогах существенным.
Иллюстративный расчёт, сделанный нами по таблице 3 Vanobberghen и коллег, а не самими авторами, помогает увидеть эффект. Среди 1000 человек без туберкулёза специфичность 74,2 процента оставляет около 258 ложно аномальных изображений, тогда как специфичность 38,1 процента оставляет около 619, согласно значениям исследования (Vanobberghen et al., 2024). Каждому из этих людей нужны сбор мокроты, молекулярный тест и ответ, а некоторые могут в итоге получить лечение без подтверждения — тот вид избытка, который обсуждается в материале о сверхдиагностике.
То же исследование даёт контраст с человеческим чтением в полевых условиях. Человеческое чтение рентгенограмм в обследовании, с учётом центрального чтения, когда оно было доступно, дало чувствительность 47,2 процента и специфичность 96,5 процента (Vanobberghen et al., 2024). Человеческое чтение было гораздо более специфичным и гораздо менее чувствительным, чем программа на выбранном пороге.
Авторы перечисляют важные проблемы. Многих рентгенограмм не хватало, чаще в городских районах, что может снизить репрезентативность; около 19 процентов приглашённых отказались от обследования, в большей доле это молодые мужчины из городских районов (Vanobberghen et al., 2024). Множественная импутация опирается на предположение, что данные отсутствуют случайно. Кроме того, оценка распространённости варьировала от 0,83 до 2,72 процента в зависимости от метода, что показывает, насколько результат зависит от способа учёта необследованных (Vanobberghen et al., 2024). Один из авторов — из ВОЗ.
Оптимальный порог Лесото не подходит для других мест. Сами авторы приводят пороги 50 в Бангладеш и 20 в Южной Африке для однотипной программы и заключают, что порог зависит от контекста (Vanobberghen et al., 2024). В исследовании в Непале и Камеруне порог одной и той же программы, обеспечивавший нужную чувствительность, составил 63 в одной стране и 48 в другой, а единый порог показал разный результат в каждом месте (Qin et al., 2019).
Пользователи, опрошенные Creswell и коллегами, сообщают, что выбор порога по-прежнему вызывает споры среди разработчиков политики и что применявшиеся стратегии были разнообразными и слабо структурированными, а калибровочные исследования они считают трудными в проведении и требующими повторения (Creswell et al., 2023). Специальная программа исследований тропических болезней ВОЗ опубликовала процесс, призванный помочь в этом выборе.
Средняя специфичность скрывает группы, в которых программное обеспечение ошибается чаще. Мета-анализ индивидуальных данных Tavaziva и коллег объединил 3727 участников из четырёх исследований, из них около 17 процентов с ВИЧ и 17 процентов с подтверждённым туберкулёзом (Tavaziva et al., 2022). При объединённой чувствительности, зафиксированной на уровне 90 процентов, специфичность трёх программ составила от 54,1 до 60,5 процента (Tavaziva et al., 2022).
Самое сильное падение оказалось у тех, кто уже перенёс туберкулёз. В том же мета-анализе специфичность составила от 26,6 до 33,7 процента у людей с предшествующим лечением и от 58,0 до 69,3 процента у остальных (Tavaziva et al., 2022). Чувствительность также была ниже при туберкулёзе с отрицательным результатом мазка и, для двух продуктов, у людей с ВИЧ. Авторы заключают, что пороги следует определять исходя из популяций каждого пользователя, и признают, что данные трёх из семи подходящих исследований были недоступны и что не хватало данных о CD4.
Одно исследование в Лусаке, Замбия, рассмотрело эту группу подробно. Авторы описывают ретроспективный анализ проспективного поперечного исследования по активному выявлению случаев с участием 1884 человек с симптомами в возрасте 15 лет и старше, из которых 452, или 24,0 процента, имели перенесённый туберкулёз (Kagujje et al., 2023). При порогах, установленных для чувствительности 90 процентов, специфичность одной программы составила 24,0 процента у тех, кто перенёс туберкулёз, и 60,3 процента у тех, кто нет; у другой — 22,2 против 61,8 процента (Kagujje et al., 2023). В исследовании не было сравнения с человеческим чтением, история туберкулёза была со слов участников, а референсным стандартом был молекулярный тест.
Рубцы после излеченного туберкулёза остаются видны на рентгенограмме, и программное обеспечение склонно читать эти последствия как активную болезнь. В оценке во Вьетнаме большинство программ показали значительно худший результат у людей с перенесённым туберкулёзом (Codlin et al., 2021).
В Южной Африке внешняя валидация использовала выборку случай—контроль из 774 человек в возрасте 15 лет и старше, 258 из них с туберкулёзом, взятую из национального обследования распространённости 2017–2019 годов, для проверки 12 программ (Qin et al., 2024). Площади под кривой составили около 0,9 у лучших и менее 0,8 у худших, и все продукты показали худший результат у людей старшего возраста, с перенесённым туберкулёзом и с ВИЧ. Авторы признают, что исследованию не хватило мощности: 258 человек с туберкулёзом при необходимых 291, что часть данных была со слов участников и что люди без симптомов с нормальной рентгенограммой были исключены.
В Лесото чувствительность сильно зависела от ВИЧ-статуса и от порогового балла, а специфичность почти не менялась (Vanobberghen et al., 2024), что показывает, насколько эти результаты различаются между популяциями. В исследовании во Вьетнаме тип рентгеновского оборудования также влиял на работу некоторых программ (Codlin et al., 2021).
Практический вывод: оператор должен понимать, кто находится перед аппаратом. Очередь, в которой много пожилых людей и много уже пролеченных, даст больше ложноположительных результатов, чем очередь из молодых людей без туберкулёза в анамнезе, даже при одном и том же пороге.
Программное обеспечение со временем меняется. В наборе «случай — контроль» из 12 890 рентгенограмм из Бангладеш площадь под кривой одной программы выросла с 0,823 в одной версии до 0,903 в следующей, а другой — с 0,872 до 0,906 (Qin et al., 2022). Новые версии достигли целевого профиля продукта ВОЗ, но обновление изменило пороги, дававшие ту же чувствительность, и авторы рекомендуют переоценивать их на локальных данных. В исследовании не использовали культуру, не использовали наиболее чувствительную версию молекулярного теста и исключили лиц младше 15 лет.
В руководстве ВОЗ внедрение рассматривается в разделе 4.4 (ВОЗ, 2021). В документе описана существенная вариация между площадками даже при одном и том же программном обеспечении и одном и том же пороге, поэтому требуется локальная калибровка балла в соответствии с целями программы с последующим непрерывным мониторингом. Такой мониторинг сравнивает показания программного обеспечения с оценками людей-читателей, с бактериологическими результатами и с долей изображений, классифицированных как аномальные. К руководству прилагаются операционное пособие, протокол калибровки и онлайн-инструмент.
Когда машина решает, кого направить на тест, команда склонна перестать смотреть на снимки, которые она назвала нормальными. Этот риск — тема автоматизационной предвзятости. Доля аномальных изображений служит хорошим сигналом тревоги: если она растёт или падает без изменений в популяции, значит, что-то изменилось в аппарате, программном обеспечении или в потоке пациентов.
Программное обеспечение также меняет распределение обязанностей. Во многих местах аппарат обслуживает и направляет пациента техник или медработник, а не врач, — схема, обсуждаемая в материале передача задач. В местах с ограниченными ресурсами рентгенограмма, прочитанная программным обеспечением, соседствует с другими простыми исследованиями, как описано в материале диагностика при ограниченных ресурсах.
Недавнее исследование предполагает, что балл может нести информацию, выходящую за пределы момента обследования. В проспективной когорте из 483 бытовых контактов людей с туберкулёзом, устойчивым к рифампицину, в Южной Африке, наблюдавшихся медианно 4,6 года, было 23 человека с распространённым туберкулёзом и 38 с инцидентным туберкулёзом (Macpherson et al., 2025). Площадь под кривой составила от 0,87 до 0,91 для распространённой болезни и от 0,60 до 0,65 для инцидентной. Более 30 процентов людей выше порога с отрицательной рутинной мокротой были диагностированы позже — при расширенном исследовании мокроты или во время наблюдения (Macpherson et al., 2025). Авторы предупреждают, что более низкие проверенные пороги не прошли внешней валидации и что исследование проводилось в условиях высокой нагрузки.
Рекомендация ВОЗ относится к людям 15 лет и старше, а руководство называет программное обеспечение для детей неотложным пробелом в исследованиях (ВОЗ, 2021). Детская рентгенограмма выглядит иначе: преобладают лимфоузлы корня лёгкого и средостения, и картина меняется с возрастом.
В исследовании Palmer и коллег использовались рентгенограммы 620 детей младше 13 лет, включённых в проспективное наблюдательное диагностическое исследование в Кейптауне в 2012–2017 годах (Palmer et al., 2023). Проанализировали 525 изображений, тестовый набор составил 80, половина с туберкулёзом и половина без. Эталоном служило радиологическое заключение панели экспертов, а не бактериологическое подтверждение.
Версия программного обеспечения для взрослых имела площадь под кривой 0,58 на этом наборе. После тонкой настройки на педиатрических изображениях площадь выросла до 0,72 — статистически значимая разница с p = 0,0016 (Palmer et al., 2023). Даже после улучшения результат был далёк от показателей у взрослых.
Авторы признают, что набор данных был мал для глубокого обучения, что эталонный стандарт зависел от человеческого чтения и что специалисты разошлись между собой по 25 из 80 тестовых изображений (Palmer et al., 2023). Популяция состояла из детей в ходе диагностического обследования, а не скрининга. Один из соавторов работает в компании, разрабатывающей программное обеспечение. Исследование представляет собой проверку концепции и не обосновывает применение программного обеспечения у детей.
У команды нашего вымышленного случая теперь есть вопросы полезнее, чем «какое число использовать». Сколько молекулярных тестов в день выдерживает лаборатория? Какова ожидаемая распространённость в этой очереди? Сколько человек уже перенесли туберкулёз? Та ли это версия программного обеспечения, что в калибровочных исследованиях?
С этими ответами команда может выбрать начальный порог, регистрировать долю аномальных изображений и сравнить выборку прочтений с рентгенологом и с результатами мокроты. Если в очереди много взрослых, лечившихся в прошлом, следует ожидать больше ложноположительных результатов и скорректировать поток. И нужно помнить, что маленькие дети, проходящие через учреждение, выходят за рамки рекомендации и нуждаются в клинической оценке.
В NEXO случай дня вымышленный, с реальной клинической картиной и до шести последовательных подсказок, а вы предлагаете диагноз, ища код в МКБ-10. Выбор порога требует того же упражнения: взвесить вероятность до обследования, спросить, кого тестируют, и решить, что делать с результатом, который не сходится, как в тренировке дифференциального диагноза с подсказками.
Границы использования игры описаны на странице экономики NEXO. Если вы исследуете преподавание клинического рассуждения, страница для Researcher объясняет, как связаться. Специалисты, которые пишут или рецензируют случаи, найдут информацию в разделах Curator и Creators, а учреждения могут узнать о предложении на странице для партнёрств. Поиск нужного кода в МКБ-10 завершает эту тренировку.
Оно указывает, кому следует пройти подтверждающий тест. ВОЗ оценивала программное обеспечение по отношению к бактериологически подтверждённому туберкулёзу, и подтверждение по-прежнему зависит от теста мокроты (ВОЗ, 2021).
ВОЗ классифицирует её как условную, с низкой достоверностью доказательств, и ограничивает людьми от 15 лет и цифровыми рентгенограммами в прямой проекции (ВОЗ, 2021).
Исследования показывают очень разные оптимальные пороги между странами и между версиями одной и той же программы, и ВОЗ требует локальной калибровки (Vanobberghen et al., 2024; Qin et al., 2022).
Потому что вблизи точки, где чувствительность уже высока, каждый небольшой прирост чувствительности вызывает большую потерю специфичности. В Лесото переход с порога 13 на 3 дал 6,4 пункта чувствительности и отнял 36,1 пункта специфичности (Vanobberghen et al., 2024).
Можно, но специфичность в этой группе сильно падает, и службе следует ожидать много направлений без активного заболевания (Tavaziva et al., 2022; Kagujje et al., 2023).
Рекомендация ВОЗ исключает лиц младше 15 лет, а лучшее доступное педиатрическое исследование — это проверка концепции на небольшой выборке (Palmer et al., 2023).