Цифровая медицина и ИИКогнитивные искажения и врачебные ошибкиКлиническое мышление
ИИ в дерматологии: хуже работает на тёмной коже
Содержание
- Почему ИИ в дерматологии стал и обещанием, и риском
- Что измерил Diverse Dermatology Images
- Прозрачность наборов данных
- Дообучение и что меняется при разнообразных данных
- Чек-лист CLEAR Derm и что спрашивать у поставщика
- Что меняется в клиническом решении
- Исследования вкратце
- Как NEXO помогает тренировать это рассуждение
- Частые вопросы
- Ключевые выводы
- Литература
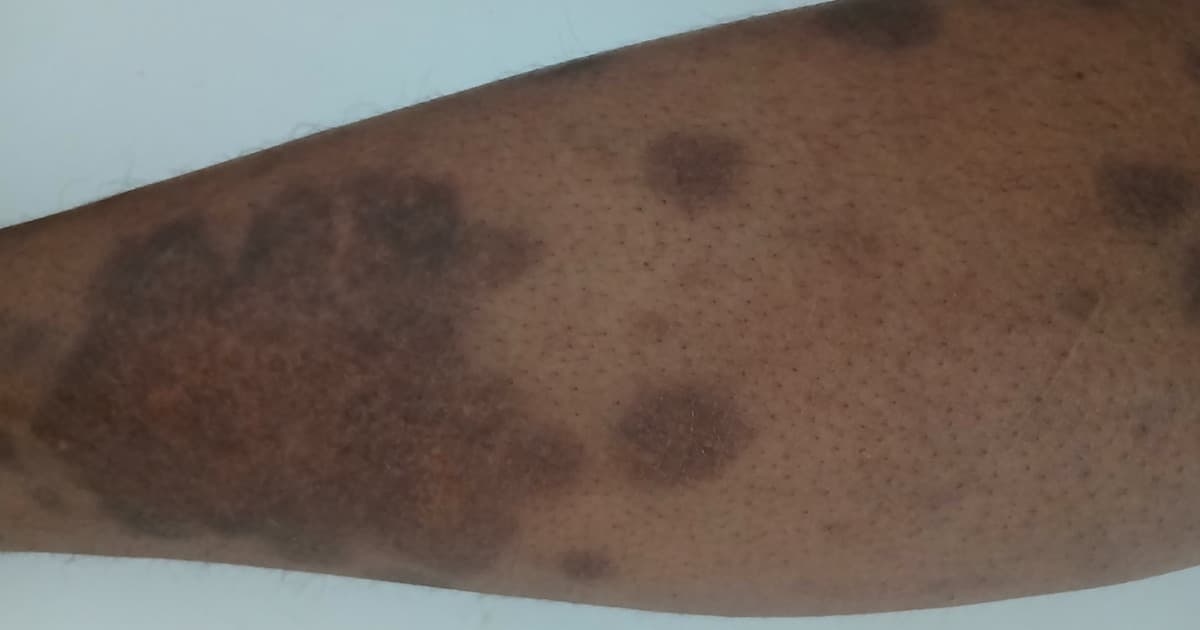
В вымышленном приёме клиника кожных болезней тестирует приложение, которое классифицирует фотографии поражений как доброкачественные или злокачественные. Алгоритм часто угадывает на светлых изображениях из демонстрационного банка. На той же неделе трое пациентов с тёмным тоном кожи приносят фотографии пятен и узелков: приложение выдаёт низкие оценки уверенности или предполагает доброкачественность поражений, которые дерматолог считает подозрительными. Команда спрашивает, проблема в фотографии, в аппарате или в модели.
Этот сценарий резюмирует то, что измерили недавние исследования: классификаторы изображений кожи, обученные на малоразнообразных банках, теряют эффективность на тёмных тонах и на менее распространённых заболеваниях. Этот текст собирает то, что показывает литература об этом снижении, почему наборы данных не отличаются прозрачностью и что клиницист может спросить, прежде чем доверять результату. В каждой части текст сообщает дизайн и размер исследований и отделяет то, что было измерено, от того, что является нашим выводом.
Основные пункты
- В наборе Diverse Dermatology Images три передовых алгоритма имели площадь под кривой ROC от 0,56 до 0,67, что значительно ниже эффективности, заявленной в их собственных тестах (Daneshjou et al., 2022).
- Чувствительность резко снизилась при Fitzpatrick V-VI: у ModelDerm с 0,41 до 0,12, у DeepDerm с 0,69 до 0,23 (Daneshjou et al., 2022).
- В 70 исследованиях ИИ в дерматологии только 24,2 процента изображений были публичными, 20 процентов описывали расу или этническую принадлежность и 10 процентов указывали тон кожи (Daneshjou et al., 2021).
- Дообучение на разнообразных изображениях закрыло разрыв между светлыми и тёмными тонами у DeepDerm и у модели, обученной на HAM10000 (Daneshjou et al., 2022).
- Дерматологи также чаще ошибались на тёмных тонах и при необычных заболеваниях, что важно, поскольку они размечают многие обучающие банки (Daneshjou et al., 2022).
- Почему ИИ в дерматологии стал и обещанием, и риском
- Что измерил Diverse Dermatology Images
- Прозрачность наборов данных
- Дообучение и что меняется с разнообразными данными
- Чек-лист CLEAR Derm и что спрашивать у поставщика
- Что меняется в клиническом решении
- Исследования вкратце
- Как NEXO помогает тренировать это мышление
- Часто задаваемые вопросы
- Ключевые выводы
Почему ИИ в дерматологии стал и обещанием, и риском
Автоматическая классификация кожных поражений привлекла внимание после того, как глубокие нейронные сети сравнялись с дерматологами в задачах по меланоме и карциноме на больших банках (Esteva et al., 2017). Стэнфордское исследование обучило модель на 129 450 изображениях и протестировало на 2 032 изображениях с биопсией, показав эффективность, близкую к эффективности 21 сертифицированного дерматолога (Esteva et al., 2017).
Прорыв 2017 года и предупреждение 2018 года
Этот рубеж ускорил развитие приложений, теледерматологии и надежды на скрининг в первичной помощи. В следующем году Adamson и Smith предупредили, что модели, обученные на недостаточно репрезентативных данных, могут усиливать неравенство, если их внедрять без измерения эффективности по подгруппам (Adamson e Smith, 2018). Предупреждение предвосхитило то, что Diverse Dermatology Images (DDI) измерил в цифрах годы спустя.
Обещание остаётся действительным для распространённых поражений в сбалансированных банках, но клинический вопрос перестал быть «угадывает ли алгоритм?» и стал «на ком он угадывает?». Эта смена вопроса перекликается с использованием искусственного интеллекта в клиническом мышлении и с риском слишком полагаться на машину.
Что измерил Diverse Dermatology Images
DDI был создан для тестирования алгоритмов на клинически подтверждённых изображениях с разнообразными тонами кожи и распространёнными и необычными заболеваниями (Daneshjou et al., 2022). После исключения фотографий, не прошедших контроль качества, осталось 656 изображений, сбалансированных между доброкачественными и злокачественными на крайних значениях шкалы Fitzpatrick (Daneshjou et al., 2022).
Состав набора
Было 208 изображений Fitzpatrick I-II (159 доброкачественных и 49 злокачественных), 241 изображение III-IV и 207 изображений V-VI (159 доброкачественных и 48 злокачественных) (Daneshjou et al., 2022). Подмножества крайних значений были сопоставлены по диагностическому классу для сравнения между светлыми и тёмными тонами.
Эффективность трёх алгоритмов
В полном DDI площадь под кривой ROC у ModelDerm составила 0,65 (95% ДИ от 0,61 до 0,70), у DeepDerm — 0,56 (0,51–0,61), а у модели, обученной на HAM10000, — 0,67 (0,62–0,71) (Daneshjou et al., 2022). На собственных тестовых наборах эти алгоритмы достигали заметно более высоких значений, что показывает падение при выходе из исходной среды.
При сравнении Fitzpatrick I-II и V-VI ModelDerm снизился с 0,64 (0,55–0,7) до 0,55 (0,46–0,64), DeepDerm — с 0,61 (0,50–0,71) до 0,50 (0,41–0,58), а HAM10000 — с 0,72 (0,63–0,79) до 0,57 (0,48–0,67) (Daneshjou et al., 2022). Чувствительность упала с 0,41 до 0,12 у ModelDerm и с 0,69 до 0,23 у DeepDerm (Daneshjou et al., 2022).
Дерматологи тоже ошибаются на тёмной коже
В DDI трёх дерматологов попросили классифицировать каждое изображение как доброкачественный или злокачественный процесс и сформировали мажоритарное голосование (Daneshjou et al., 2022). Метки специалистов превосходили алгоритмы до тонкой настройки, но чувствительность дерматологов также упала с 0,72 при Fitzpatrick I-II до 0,59 при V-VI (Daneshjou et al., 2022).
Тест с 848 врачами
Гро и коллеги провели цифровой эксперимент с 389 дерматологами и 459 врачами первичного звена из 39 стран, которые оценили 364 изображения 46 заболеваний в симуляции теледерматологии (Groh et al., 2024). Диагностическая точность составила 38 процентов среди дерматологов и 19 процентов среди терапевтов, и обе группы были на 4 процентных пункта менее точны на тёмной коже (Groh et al., 2024). Поддержка алгоритма глубокого обучения повысила точность более чем на 33 процента, но увеличила разрыв между тонами кожи у терапевтов (Groh et al., 2024). Авторы заключают, что повышение общей точности само по себе не устраняет смещение (Groh et al., 2024).
Почему это важно для обучения
Многие банки используют метки дерматологов как эталонную истину. Если человеческая ошибка больше на тёмных тонах и при необычных заболеваниях, алгоритм наследует и может усилить этот недостаток (Daneshjou et al., 2022). Обсуждение пересекается с неявным смещением в диагностике и с калибровкой уверенности: точность и уверенность не идут вместе, когда меняется подгруппа.
Наш вывод таков: дерматолог остаётся незаменимым, но не является эталоном, свободным от фотографического смещения; его роль — фильтровать алгоритм, а не только размечать банк.
Прозрачность наборов данных
До DDI обзорный обзор в JAMA Dermatology изучил 70 исследований глубокого обучения в дерматологии (Daneshjou et al., 2021). Из 1.065.291 изображения, использованных для разработки или тестирования алгоритмов, публично доступны были только 257.372 (24,2 процента) (Daneshjou et al., 2021).
О чём почти никто не сообщает
Лишь 14 исследований (20,0 процента) описывали этническую принадлежность или расу хотя бы в одном наборе, и только 7 (10,0 процента) сообщали какие-либо данные о тоне кожи (Daneshjou et al., 2021). Без этой информации читатель не может узнать, тестировалась ли модель на той популяции, где она будет применяться.
Публичные банки и сетевой эффект
Публичные наборы цитировались чаще частных, что концентрирует обучение на немногих источниках и на фотографиях со схожим демографическим профилем (Daneshjou et al., 2021). Наша гипотеза состоит в том, что повторение одних и тех же банков объясняет часть падения, наблюдавшегося в DDI при изменении клинического сценария.
Обзорный обзор также показал, что медиана числа изображений в исследованиях, обучавших новые алгоритмы, составляла около 10 тысяч при широком разбросе, что усиливает неравенство ресурсов между исследовательскими группами (Daneshjou et al., 2021). Без публичных данных и без демографического описания клиническое сообщество не может воспроизвести или проверить работу по подгруппам до покупки или внедрения.
Что содержат публичные банки
Wen и коллеги систематически изучили 21 открытый банк изображений рака кожи, содержащий 106 950 изображений (Wen et al., 2022). Из 14 банков, указывавших страну происхождения, 11 (79 процентов) были из Европы, Северной Америки и Океании, а 19 банков (91 процент) содержали только дерматоскопические или макроскопические изображения (Wen et al., 2022). Этническая принадлежность была указана для 1 415 изображений (1,3 процента), а фототип по Фицпатрику — для 2 236 (2,1 процента) (Wen et al., 2022). Авторы призывают к стандартам качества метаданных банков (Wen et al., 2022).
Эта непрозрачность перекликается с предупреждением из отчёта об ошибках диагностики: системы, не измеряющие сбои по подгруппам, воспроизводят неравенство — тема текста о докладе Improving Diagnosis.
Дообучение и что меняется при разнообразных данных
Авторы DDI дообучили DeepDerm и модель HAM10000 на разнообразных изображениях (Daneshjou et al., 2022). После дообучения DeepDerm достиг площади под кривой 0,73 (95-процентный ДИ от 0,70 до 0,77) при Fitzpatrick I-II и 0,76 (0,71–0,80) при V-VI (Daneshjou et al., 2022).
HAM10000 после дообучения
Модель на основе HAM10000 достигла 0,77 (0,73–0,80) при I-II и 0,78 (0,75–0,81) при V-VI (Daneshjou et al., 2022). Разрыв между светлыми и тёмными тонами закрылся, и качество стало равняться голосованию дерматологов или превосходить его на многих срезах данных.
Что это значит для клинициста
Результат не означает, что какое-либо коммерческое приложение уже дообучено. Он означает, что сбой исправим при наличии размеченных и разнообразных изображений, и что требовать доказательств тестирования по тону кожи — законный вопрос перед внедрением. Обзор 2025 года пришёл к похожему выводу: большинство исследований показало худшую точность при Fitzpatrick IV-VI с улучшением после обучения на разнообразных наборах (Dowie, 2025).
Тон кожи — не то же самое, что раса
Шкала Фицпатрика создавалась для оценки реакции на ультрафиолет, а не для отображения происхождения. Ulrich и коллеги описали автоматизированный метод, который оценивает тон кожи и переводит его в шкалы Monk и Фицпатрика; при валидации на 3D-сканированиях тела и изображениях, созданных ИИ, согласие было высоким с Monk и менее устойчивым с Фицпатриком (Ulrich et al., 2025).
Почему это различие важно на приёме
Самостоятельно указанная раса, этническая принадлежность и измеренный на фото тон кожи отвечают на разные вопросы. Алгоритм может давать сбой из-за пигментации, освещения, типа поражения или сочетания этих факторов (Daneshjou et al., 2022; Ulrich et al., 2025). Рассматривать «тёмную кожу» как единую категорию без описания метода классификации значит скрывать механизм ошибки.
На практике клиницист, документирующий наблюдаемый тон и качество фото, помогает и аудиту алгоритма, и человеческому рассуждению — в том же духе, что и избегание ярлыков, скрывающих остальную картину.
Чек-лист CLEAR Derm и что спрашивать у поставщика
Рабочая группа по ИИ International Skin Imaging Collaboration опубликовала CLEAR Derm — чек-лист лучших практик для разработки и оценки ИИ на основе изображений в дерматологии (Daneshjou et al., 2022). Документ охватывает курирование данных, построение модели и оценку, уделяя внимание фотографическому смещению и этическим соображениям (Daneshjou et al., 2022).
Пять практических вопросов (наш обзор)
Прежде чем включать классификатор в рутину, наш список — не валидированный как инструмент — включает:
- Сообщалось ли качество по тону кожи или по эквивалентной шкале?
- Является ли тестовый набор внешним по отношению к обучающему?
- Есть ли чувствительность и специфичность по подгруппам, а не только общая площадь под кривой?
- Доступны ли обучающие изображения для публичного аудита или хотя бы описаны по демографическому составу?
- Есть ли план человеческого надзора и регистрации случаев, когда алгоритм и клиницист расходятся?
Эти вопросы перекликаются с критическим чтением статей и с вниманием в команде по меланоме, где изображение — лишь один шаг пути.
Освещение, съёмка и путь к пикселю
Алгоритм видит только то, что передаёт камера. Боковой свет, тень, сжатие файла и цветной фон меняют видимую текстуру и цвет. Обзор принципов и применений ИИ в дерматологии подтверждает, что качество изображения и репрезентативность базы ограничивают любую модель (Omiye et al., 2023).
Что стандартизировать в кабинете
Наш операционный список, основанный на ограничениях, описанных в исследованиях, и не проверенный как протокол, включает:
- Использовать рассеянный фронтальный свет и избегать жёсткой вспышки, которая пересвечивает блик.
- Кадрировать поражение с запасом здоровой кожи вокруг.
- Сохранять одинаковое расстояние и одинаковый угол на фото при наблюдении.
- Записывать устройство и дату вместе с клиническим файлом.
- Не отправлять алгоритму размытые фото или фото с фильтром красоты.
Эти меры касаются и поражений у путешественников, и дифференциальной диагностики кожи при mpox и при коже путешественника, даже когда алгоритм не участвует в решении.
Что меняется в клиническом решении
В первичном звене это означает не передавать решение о биопсии балльной шкале, не зная, на какой популяции она валидирована. Та же осторожность нужна, когда фото приходит сообщением: плохое качество и тон кожи вне обучающей базы повышают неопределённость, и клиницист должен ясно сказать об этом пациенту.
При алгоритмической балльной шкале клиницисту по-прежнему нужны анамнез, осмотр и эпидемиологический контекст. Наша гипотеза состоит в том, что главный риск — не ложноположительный результат на светлой коже для демонстрации, а ложноотрицательный результат на тёмной коже, когда приложение предлагает "вероятно доброкачественное" с кажущейся уверенностью.
Как интегрировать, не автоматизируя заключение
Практические рекомендации, обозначенные как синтез:
- Относиться к результату алгоритма как к подсказке, а не как к заключению.
- Отказываться от решения только по балльной шкале, когда тон кожи или заболевание выходят за спектр валидационного исследования.
- Документировать расхождение между клиницистом и машиной для будущего аудита.
- Отдавать приоритет биопсии или направлению, когда поражение клинически подозрительно, независимо от приложения.
- Избегать объявления пациенту "подтверждения искусственным интеллектом" без объяснения ограничений.
Такое применение вписывается в тренировку дифференциальной диагностики по подсказкам и снижает диагностическую ошибку в первичном звене, связанную с преждевременным заключением.
Когда алгоритм и клиника расходятся
Если при осмотре поражение кажется подозрительным, а приложение предлагает доброкачественность, действуют по клинике. DDI показал низкую чувствительность при Fitzpatrick V-VI именно в тех долях, где ложноотрицательный результат особенно болезненен (Daneshjou et al., 2022). В таких случаях биопсия, очная дерматоскопия или второе мнение весят больше, чем балльная шкала.
Наш синтез: записывать в медицинскую карту результат алгоритма, наблюдаемый тон кожи и окончательное решение. Эта запись создаёт локальную базу для аудита, которую многоцентровые исследования пока редко публикуют по подгруппам.
Ограничения, которые текст не снимает
Цифры DDI получены на курированном наборе в академическом центре и не измеряют работу каждого коммерческого приложения, доступного сегодня. Нарративный обзор Dowie отобрал мало статей после строгих фильтров (Dowie, 2025). Ulrich валидирует метод классификации тона, а не классификатор рака (Ulrich et al., 2025).
Поэтому обобщение "любой ИИ для кожи ошибается" было бы недопустимым выводом. Данные подтверждают более узкое: алгоритмы, обученные на малопрозрачных и маломногообразных базах, имеют измеримый риск худшей работы на тёмных тонах, и этот риск снижается, когда обучение и тестирование намеренно включают такие изображения (Daneshjou et al., 2022; Daneshjou et al., 2021).
Что клиницист берёт на следующий приём
После прочтения DDI и обзора прозрачности практическое изменение состоит не в отказе от технологии, а в требовании той же строгости, что и к новому лабораторному исследованию. Наш синтез, согласованный с приведёнными данными, — организовать приём в три этапа: (1) качество фото и наблюдаемый тон кожи; (2) результат алгоритма как подсказка, никогда как заключение; (3) документированное решение при расхождении.
Как объяснить ограничение пациенту
Наша формулировка, не проверенная как скрипт, состоит в том, что приложение помогает упорядочивать гипотезы, но обучалось главным образом на изображениях определённых оттенков кожи, и что решение о биопсии или наблюдении остаётся клиническим. Это позволяет избежать как слепого отказа от инструмента, так и автоматического доверия, которое описывает эффект автоматизации.
Минимальный аудит в учреждении
Для учреждений, которые уже используют классификатор, наш операционный список включает ежемесячный пересмотр случаев, где алгоритм и дерматолог разошлись, разделение файлов по наблюдаемому оттенку кожи и проверку того, сосредоточены ли ложноотрицательные результаты в Fitzpatrick V-VI, как предсказал DDI (Daneshjou et al., 2022). Без этого цикла учреждение воспроизводит непрозрачность, которую задокументировал обзор 70 исследований (Daneshjou et al., 2021).
Тот же принцип измерения по подгруппам проявляется в командной работе с меланомой и в предотвращении преждевременного закрытия — тема тренировки дифференциальной диагностики с подсказками. Технология снижает вред, только если учреждение знает, на ком она даёт сбой.
Исследования вкратце
| Исследование | Дизайн, выборка и единица | Основная находка |
|---|---|---|
| Esteva 2017 | Нейронная сеть; 129 450 изображений для обучения, 2 032 для теста | Результат близок к дерматологам на собственном наборе |
| Adamson 2018 | Комментарий | Предупреждение о неравенстве при отсутствии измерения по подгруппам |
| Daneshjou 2021 | Обзорный обзор; 70 исследований | Мало прозрачности по расе и оттенку кожи |
| Daneshjou 2022 (DDI) | Внешняя оценка; 656 изображений | Снижение AUC и чувствительности при Fitzpatrick V-VI |
| Wen 2022 | Систематический обзор; 21 публичный набор, 106 950 изображений | Fitzpatrick указан в 2,1 процента изображений (Wen et al., 2022) |
| Groh 2024 | Цифровой эксперимент; 848 врачей, 364 изображения | Тёмная кожа с меньшей точностью; поддержка ИИ увеличила разрыв между терапевтами (Groh et al., 2024) |
| CLEAR Derm 2022 | Консенсусный чек-лист | Пункты по данным, модели и справедливой оценке |
| Omiye 2023 | Нарративный обзор | Ограничения изображений и репрезентативности |
| Dowie 2025 | Нарративный обзор; 8 итоговых статей | Худшая точность на тёмных оттенках; улучшение при разнообразных данных |
| Ulrich 2025 | Метод анализа оттенка | Шкала Monk с лучшим согласованием в некоторых тестах |
Источники: Esteva et al., 2017; Adamson e Smith, 2018; Daneshjou et al., 2021; Daneshjou et al., 2022; Daneshjou et al., 2022; Wen et al., 2022; Groh et al., 2024; Omiye et al., 2023; Dowie, 2025; Ulrich et al., 2025.
Как NEXO помогает тренировать это рассуждение
В NEXO случай дня вымышленный, с реальной клинической картиной и до шести последовательных подсказок, и вы предлагаете диагноз, ища код в МКБ-10. Одна подсказка может содержать "асимметричное пятно на спине, пациент с тёмным оттенком кожи"; другая — "приложение для кожи предположило доброкачественность с низкой уверенностью". Обратная связь по близости в пяти уровнях помогает различать невус, меланому, базальноклеточный рак и дерматит, не превращая тренировку в протокол программного обеспечения.
Частые вопросы
Все приложения для кожи дают сбой на тёмном оттенке?
Три передовых алгоритма, протестированных в DDI, показали снижение при Fitzpatrick V-VI, и последующие обзоры нашли ту же закономерность в большинстве исследований (Daneshjou et al., 2022; Dowie, 2025).
Достаточно ли дообучить модель на разнообразных данных?
В DDI дообучение закрыло разрыв между I-II и V-VI в DeepDerm и в модели HAM10000, но каждый коммерческий продукт должен показать собственный тест (Daneshjou et al., 2022).
Защищены ли дерматологи от искажения из-за фото?
Чувствительность голосования большинства снизилась с 0,72 до 0,59 между светлыми и тёмными оттенками в DDI (Daneshjou et al., 2022).
Оттенок кожи и раса — это одна и та же переменная?
Fitzpatrick описывает реакцию на свет; раса и этническая принадлежность — разные социальные категории, а шкалы вроде Monk пытаются уловить оттенок, наблюдаемый на изображении (Ulrich et al., 2025).
Что запросить перед внедрением классификатора?
Результаты по подгруппам оттенка кожи, внешний тест, чувствительность и специфичность, а не только площадь под общей кривой, и план человеческого надзора в духе CLEAR Derm (Daneshjou et al., 2022).
Ключевые выводы
- Передовые алгоритмы потеряли AUC и чувствительность на тёмной коже в DDI (Daneshjou et al., 2022).
- Большинство исследований ИИ в дерматологии не сообщают расу или оттенок кожи (Daneshjou et al., 2021).
- Дообучение на разнообразных изображениях может закрыть разрыв, если есть данные и аудит (Daneshjou et al., 2022).
- Дерматологи тоже чаще ошибаются на тёмных тонах кожи, а поддержка ИИ может увеличить разрыв между врачами общего профиля (Daneshjou et al., 2022; Groh et al., 2024).
- Врач должен воспринимать оценку как подсказку и требовать прозрачности в стиле CLEAR Derm (Daneshjou et al., 2022).
Литература
- Esteva A, Kuprel B, Novoa RA, et al. Dermatologist-level classification of skin cancer with deep neural networks. Nature. 2017;542(7639):115-118. PMID: 28117445. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC8382232/
- Adamson AS, Smith A. Machine Learning and Health Care Disparities in Dermatology. JAMA Dermatol. 2018;154(11):1247-1248. PMID: 30073260. https://pubmed.ncbi.nlm.nih.gov/30073260/
- Daneshjou R, Smith MP, Sun MD, et al. Lack of Transparency and Potential Bias in Artificial Intelligence Data Sets and Algorithms: A Scoping Review. JAMA Dermatol. 2021;157(11):1362-1369. PMID: 34550305. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC9379852/
- Daneshjou R, Vodrahalli K, Novoa RA, et al. Disparities in dermatology AI performance on a diverse, curated clinical image set. Sci Adv. 2022;8(32):eabq6147. PMID: 35960806. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC9374341/
- Daneshjou R, Barata C, Betz-Stablein B, et al. Checklist for Evaluation of Image-Based Artificial Intelligence Reports in Dermatology: CLEAR Derm Consensus Guidelines from the International Skin Imaging Collaboration Artificial Intelligence Working Group. JAMA Dermatol. 2022;158(1):58-66. PMID: 34851366. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC9845064/
- Omiye JA, Gui H, Daneshjou R, et al. Principles, applications, and future of artificial intelligence in dermatology. Front Med (Lausanne). 2023;10:1278232. PMID: 37901399. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC10602645/
- Dowie T. Exploring the Diagnostic Capability of Artificial Intelligence in Dermatology for Darker Skin Tones: A Narrative Review. Cureus. 2025;17(10):e94909. PMID: 41262830. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC12624499/
- Ulrich P, Zink A, Biedermann T, Sitaru S. Beyond Fitzpatrick: automated artificial intelligence-based skin tone analysis in dermatological patients. NPJ Digit Med. 2025;8:378. PMID: 40537526. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC12179258/
- Wen D, Khan SM, Ji Xu A, et al. Characteristics of publicly available skin cancer image datasets: a systematic review. Lancet Digit Health. 2022;4(1):e64-e74. PMID: 34772649. https://pubmed.ncbi.nlm.nih.gov/34772649/
- Groh M, Badri O, Daneshjou R, et al. Deep learning-aided decision support for diagnosis of skin disease across skin tones. Nat Med. 2024;30(2):573-583. PMID: 38317019. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC10878981/