Kirkpatrick-Modell: Lehrprogramme bewerten
Inhaltsverzeichnis
- Was das Kirkpatrick-Modell ist
- Die vier Ebenen in der medizinischen Ausbildung
- Was die Übersichten fanden
- Die Kritik am Modell
- Alternativen und Ergänzungen
- Wie man die Evaluation eines Programms gestaltet
- Kirkpatrick im Alltag der Lehrenden
- Wie NEXO in die Bewertung eines Programms einfließt
- Häufige Fragen
- Checkliste für die Bewertung eines Programms
- Literatur
Die Koordination eines Medizinstudiums hat gerade zum ersten Mal ein Simulationsmodul für die Patientenversorgung im vierten Studienjahr durchgeführt. Die Studierenden waren begeistert: Der Fragebogen am letzten Tag kam voller Bestnoten und lobender Kommentare zurück. In der Gremiensitzung fragt jemand, ob das Modul verpflichtend werden soll. Eine andere Dozentin hebt die Hand: "Sie waren zufrieden, aber haben sie gelernt? Und wenn sie gelernt haben, ändert das etwas im Praktischen Jahr?". Niemand hat die Antwort, weil niemand geplant hat, wie man das messen soll.
Diese Szene wiederholt sich in studentischen Arbeitsgruppen, in der Facharztweiterbildung und in Programmen der kontinuierlichen Fortbildung. Das Kirkpatrick-Modell ist das am häufigsten verwendete Werkzeug, um dieses Gespräch zu ordnen: Es teilt, was "funktionieren" bedeutet, in vier Stufen ein, von der Zufriedenheit der Teilnehmenden bis zur Wirkung auf die Ergebnisse. Dieser Leitfaden erklärt die Stufen mit Beispielen aus der medizinischen Ausbildung, zeigt, was die Übersichtsarbeiten bei der Anwendung des Modells gefunden haben, stellt die ernsthaftesten Kritikpunkte vor und schlägt einen praktischen Weg vor, die Evaluation eines Programms zu planen, bevor es beginnt.
Die wichtigsten Punkte
- Das Kirkpatrick-Modell ordnet die Evaluation eines Lehrprogramms in vier Stufen: Reaktion, Lernen, Verhalten und Ergebnisse.
- In der medizinischen Ausbildung bleibt der Großteil der veröffentlichten Evaluationen auf der ersten oder zweiten Stufe; wenige messen eine Veränderung der Praxis und noch weniger die Ergebnisse bei Patientinnen und Patienten.
- Hohe Zufriedenheit garantiert kein Lernen, und Lernen in einem Test garantiert keine Verhaltensänderung im Versorgungsalltag.
- Die wichtigsten Kritikpunkte: Das Modell betrachtet nur Ergebnisse, setzt eine Kausalkette zwischen den Stufen voraus und ignoriert den Kontext und ungeplante Wirkungen.
- Die als New World Kirkpatrick bezeichnete Version sowie Modelle wie das CIPP-Modell und das Logische Modell helfen zu erklären, wie und warum ein Programm funktioniert.
- Die Evaluation sollte vor dem Programm geplant werden, ausgehend von dem Ergebnis, das erreicht werden soll.
Inhalt
- Was das Kirkpatrick-Modell ist
- Die vier Stufen in der medizinischen Ausbildung
- Was die Übersichtsarbeiten gefunden haben
- Die Kritik am Modell
- Alternativen und Ergänzungen
- Wie man die Evaluation eines Programms plant
- Kirkpatrick im Alltag der Lehrenden
- Wie NEXO in die Evaluation eines Programms passt
- Häufige Fragen
- Checkliste für die Evaluation eines Programms
Was das Kirkpatrick-Modell ist
Das Modell wurde von Donald Kirkpatrick Ende der 1950er-Jahre vorgeschlagen, um Schulungen in Unternehmen zu bewerten. Die Frage war praktisch: Wie lässt sich feststellen, ob sich die Investition in einen Kurs für die Mitarbeitenden gelohnt hat? Die Antwort bestand darin, die Evaluation in vier Stufen zu unterteilen, jede anspruchsvoller als die vorige. Zuerst, wie die Teilnehmenden reagiert haben. Dann, was sie gelernt haben. Danach, ob sie ihr Verhalten bei der Arbeit geändert haben. Schließlich, ob die Organisation die erwarteten Ergebnisse erzielt hat.
Die medizinische Ausbildung hat das Modell mit Begeisterung übernommen, weil es ein gemeinsames Vokabular für eine schwierige Frage bietet. Wenn ein Artikel sagt, er habe einen Kurs "auf Stufe zwei" evaluiert, weiß jeder Leser, dass das Lernen gemessen wurde und nicht nur die Zufriedenheit. Der AMEE-Leitfaden von Frye und Hemmer beschreibt das Kirkpatrick-Modell neben anderen Evaluationsmodellen und erinnert daran, dass die Wahl von der Komplexität des Programms und davon abhängt, was die Lehrenden wissen müssen.
Eine Anpassung für die medizinische Ausbildung
In der Tradition der evidenzbasierten medizinischen Ausbildung schlugen Belfield und Kollegen fünf Stufen der Wirksamkeit vor: Teilnahme, Reaktion, Lernen, Verhalten und gesundheitliche Ergebnisse. Bei der Analyse von mehr als dreihundert Zusammenfassungen fanden sie wenig Forschung zu gesundheitlichen Ergebnissen und viel Unklarheit darüber, was als Maß für Wirksamkeit gilt. Viele systematische Übersichtsarbeiten in diesem Bereich verwenden noch eine Version dieser Skala, wobei Stufe zwei in die Veränderung von Einstellungen und die Veränderung von Wissen oder Fertigkeiten unterteilt wird und Stufe vier in die Veränderung in der Organisation und den Nutzen für Patientinnen und Patienten.
Ergebnisevaluation und Programmevaluation
Es lohnt sich, von Anfang an zwei Arten von Fragen zu trennen. Die Ergebnisevaluation will wissen, ob das Programm die erwartete Wirkung erzielt hat. Die Programmevaluation will wissen, wie und warum die Wirkung aufgetreten ist oder ausgeblieben ist, in welchem Kontext und für wen. Das Kirkpatrick-Modell beantwortet die erste Frage sehr gut und die zweite kaum, und dieser Unterschied erklärt den Großteil der Kritik, die im Folgenden behandelt wird.

Die vier Ebenen in der medizinischen Ausbildung
Jede Ebene beantwortet eine andere Frage und verlangt andere Instrumente. Die folgende Tabelle fasst die Ebenen mit typischen Beispielen aus einem Modul zum klinischen Denken oder zur Simulation zusammen.
| Ebene | Frage | Beispiel für eine Messung | Wichtigste Grenze |
|---|---|---|---|
| 1. Reaktion | Hat es den Teilnehmenden gefallen, und fanden sie es nützlich? | Zufriedenheitsfragebogen beim letzten Treffen | Gefallen ist nicht Lernen |
| 2. Lernen | Gab es einen Zuwachs an Wissen, Fertigkeit oder Haltung? | Test vorher und nachher; Fertigkeitenstation | Ein Zuwachs im Test erreicht vielleicht nicht die Praxis |
| 3. Verhalten | Hat sich die Praxis im Arbeitsalltag verändert? | Direkte Beobachtung; Durchsicht von Krankenakten | Hängt von Kontext, Vorgesetzten und Zeit ab |
| 4. Ergebnisse | Haben Patientinnen und Patienten oder die Einrichtung profitiert? | Qualitäts- und Sicherheitsindikatoren | Viele Faktoren neben dem Programm |
Ebene 1: Reaktion
Die Reaktion ist die am leichtesten zu messende und am häufigsten gemessene Ebene. Ein kurzer Fragebogen am Kursende zeigt, ob der Inhalt relevant erschien, ob das Format funktionierte und ob die Teilnehmenden die Erfahrung weiterempfehlen würden. Diese Angabe hat Wert: Ein Kurs, den niemand aushält, vermittelt kaum etwas. Das Problem ist, hier stehen zu bleiben. Zufriedenheit hängt von Faktoren wie der Ausstrahlung der Lehrperson, dem Zeitpunkt und den Erwartungen ab und hat keinen gesicherten Zusammenhang mit dem Lernen.
Ebene 2: Lernen
Die zweite Ebene fragt, ob es einen messbaren Zuwachs an Wissen, Fertigkeit oder Haltung gab. Tests vorher und nachher, praktische Stationen, die Bewertung schriftlicher Fälle und Haltungsskalen gehören hierher. Die Qualität des Instruments ist sehr wichtig. In der simulationsbasierten Bewertung verglich die Übersicht von Ilgen und Kollegen Checklisten und globale Skalen und fand eine hohe Korrelation zwischen den beiden Instrumenttypen, bei ähnlicher Interrater-Reliabilität, was bei der Auswahl nach Aufgabe und Erfahrung der bewertenden Person hilft.
Ebene 3: Verhalten
Die dritte Ebene will wissen, ob die Person bei der Arbeit etwas anders macht. Hier wird die Bewertung teuer: Sie verlangt Beobachtung im Arbeitsalltag, die Durchsicht von Krankenakten oder Berichte von Kolleginnen und Kollegen und braucht Zeit, bis die Veränderung sichtbar wird. Auch hier wiegt der Kontext am schwersten. Eine Ärztin in Weiterbildung, die gelernt hat, innezuhalten und Hypothesen zu überprüfen, setzt das Gelernte vielleicht nicht ein, wenn das Team dafür keinen Raum lässt.
Ebene 4: Ergebnisse
Die vierte Ebene fragt, ob Patientinnen und Patienten, Teams oder die Einrichtung profitiert haben. In der medizinischen Ausbildung kann das weniger Fehler, eine bessere Einhaltung von Protokollen oder bessere klinische Verläufe bedeuten. Sie ist die erstrebenswerteste Ebene und die am schwersten dem Programm zuzuschreibende, weil sich in einem Krankenhaus viele Faktoren gleichzeitig ändern.
Was die Übersichten fanden
Wenn Forschende das Modell nutzen, um veröffentlichte Studien einzuordnen, wiederholt sich das Bild: viel Bewertung von Reaktion und Lernen, wenig von Verhalten und fast keine von Ergebnissen.
Fortbildung und Praktika
In einer Übersicht zur medizinischen Fortbildung über das Internet fanden Curran und Fleet, dass die meisten Bewertungen auf der Zufriedenheit der Teilnehmenden beruhten, mit wenig Forschung zur Veränderung der Praxis und keiner Studie, die einen Effekt auf die Ergebnisse bei Patientinnen und Patienten zeigte. In der Übersicht von Turkeshi und Kollegen zu Praktika in der Allgemeinmedizin im Studium bewerteten 26 Studien die Ebene eins, 26 die Ebene zwei und nur 6 die Ebene drei.
Verteiltes Lernen und digitale Narrative
Die Übersicht von Phillips und Kollegen zum verteilten Lernen in der Fortbildung nutzte das Modell, um Wissenszuwächse von Veränderungen in der Praxis und bei den Ergebnissen der Patientinnen und Patienten zu trennen, und zeigte, wie der Effekt mit jeder höheren Ebene unsicherer wird. Die Übersicht von Moreau und Kollegen zu digitalen Narrativen in der Ausbildung der Gesundheitsberufe umfasste nur Studien mit Ergebnissen auf Ebene zwei oder drei; von den sechzehn untersuchten Artikeln befassten sich vierzehn mit dem Lernen und nur zwei untersuchten auch eine Verhaltensänderung.
Simulation: ein Sonderfall
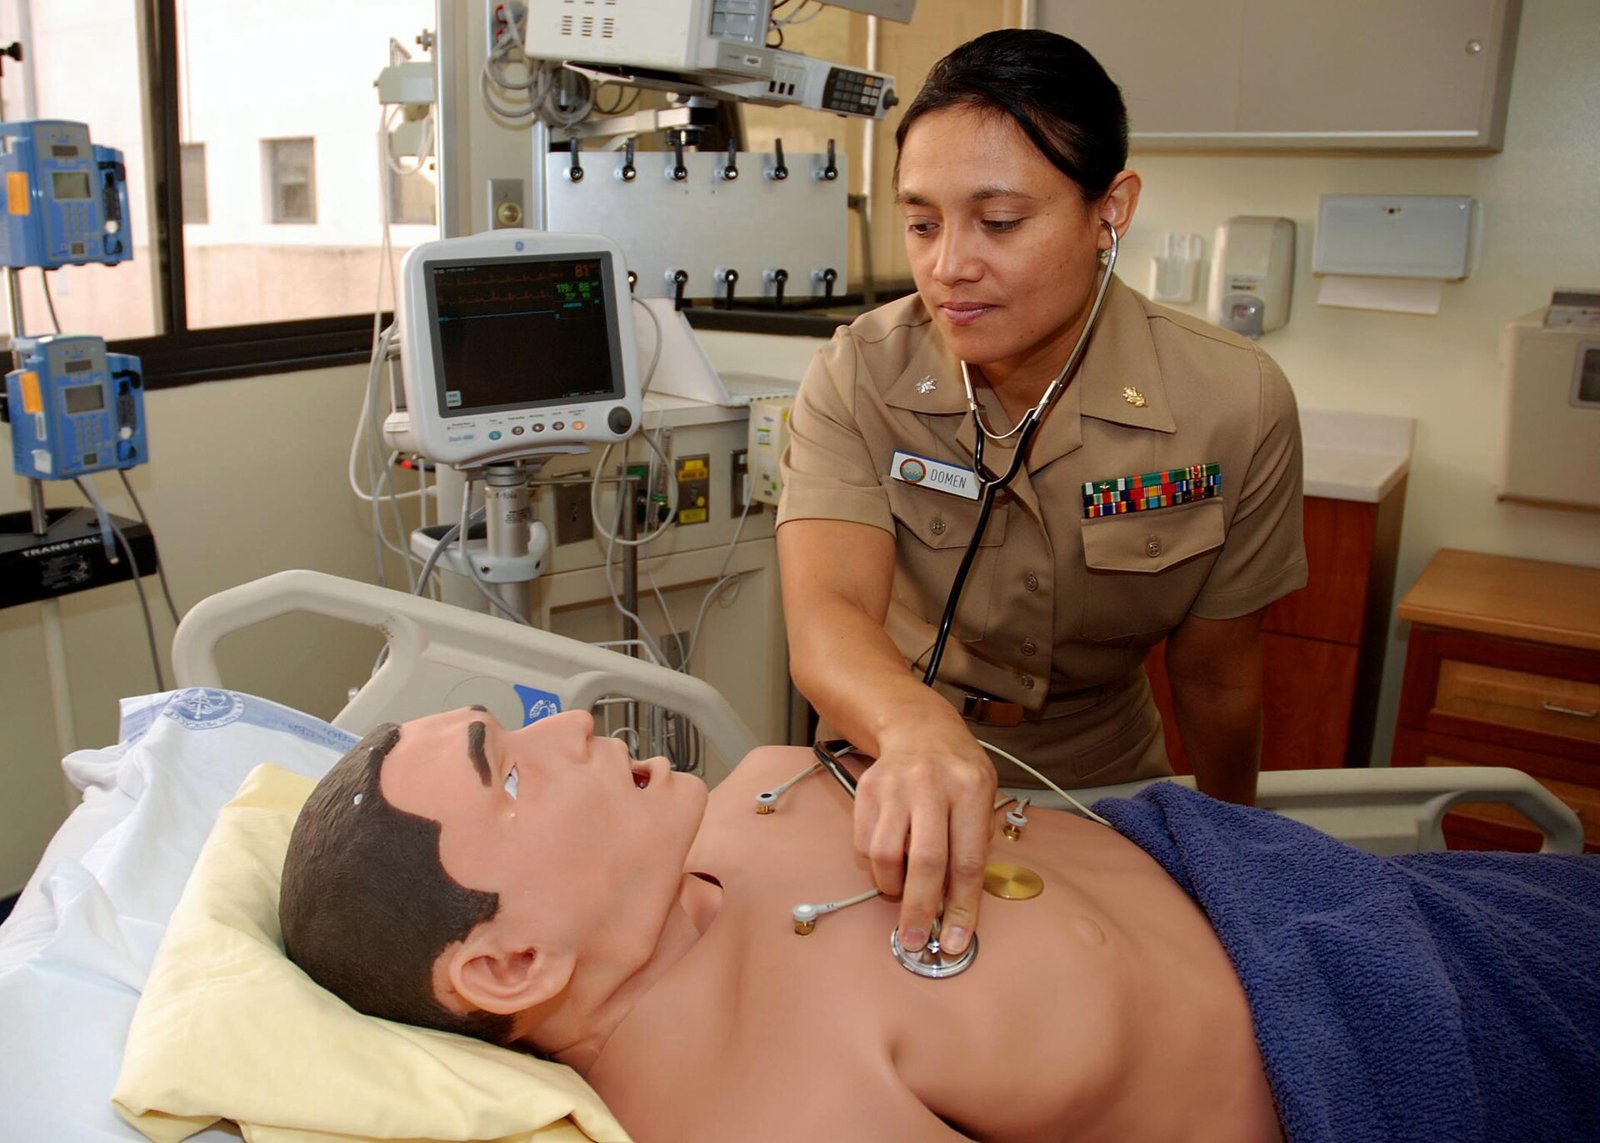
Die Simulation ist der Bereich mit den meisten Daten auf den höheren Stufen. Die Metaanalyse von Cook und Kollegen fasste 609 Studien mit mehr als 35.000 Teilnehmenden zusammen und fand günstige Effekte der Simulation im Vergleich zu keiner Intervention auf Wissen, Fertigkeiten und Verhalten, mit moderaten Effekten auf Patientenergebnisse. Dennoch nutzten die meisten Studien ein Ein-Gruppen-Design mit Vorher und Nachher. Und die Übersichtsarbeit von Brydges und Kollegen zeigte, dass die Korrelation zwischen der Leistung in der Simulation und den Patientenergebnissen im Versorgungsalltag deutlich schwächer war als die Korrelation mit dem Verhalten der Fachkräfte, was daran erinnert, dass ein gutes Ergebnis auf Stufe zwei nicht automatisch zu einem Ergebnis auf Stufe vier wird.

Die Kritik am Modell
Die Beliebtheit des Modells ging mit beständiger Kritik einher. Sie verlangt nicht, das Modell aufzugeben, sondern es im Bewusstsein dessen zu nutzen, was es misst und was es auslässt.
Die Stufen bilden keine kausale Leiter
Das Modell wird oft als Kette gelesen: eine gute Reaktion führt zum Lernen, das zum Verhalten führt, das zu Ergebnissen führt. Die Übersichtsarbeit von Allen, Hay und Palermo nennt diese Annahme positiver kausaler Verknüpfungen zwischen den Stufen als einen der Hauptkritikpunkte, neben der ausschließlichen Ausrichtung auf Ergebnisse, der Vorstellung, höhere Stufen seien immer wichtiger, und der fehlenden Aufmerksamkeit für unbeabsichtigte Wirkungen.
Taucht für einfache Programme
Yardley und Dornan untersuchten die Nutzung der Stufen als Instrument zur kritischen Bewertung von Evidenz und kamen zu dem Schluss, dass sie so viele implizite Annahmen tragen, dass sie nur für relativ einfache Unterrichtsdesigns, kurzfristige Ergebnisse und Begünstigte geeignet sind, die nicht die Lernenden selbst sind; Bedingungen, die vielleicht ein Fünftel der Übersichtsarbeiten zur medizinischen Ausbildung erfüllt. Für den Rest fügt die hierarchische Nutzung der Stufen wenig hinzu.
Ignoriert den Kontext
Derselbe Kurs kann in einem Krankenhaus funktionieren und in einem anderen scheitern, wegen der Kultur, der Arbeitsbelastung oder der Unterstützung durch die Leitung. Das ursprüngliche Modell fragt nach keinem dieser Faktoren. Für die Leitung eines Programms bedeutet das, dass ein schlechtes Ergebnis auf Stufe drei wenig mit der Qualität der Lehre und viel mit dem Umfeld zu tun haben kann, in das die Lernenden zurückgekehrt sind.
Hohe Stufen sind nicht immer besser
Eine weitere häufige Kritik betrifft die Vorstellung, dass eine Studie auf Stufe vier automatisch mehr wert ist als eine Studie auf Stufe zwei. In der Praxis kann eine gut konzipierte Studie zum Lernen mit einem zuverlässigen Instrument und einer Vergleichsgruppe viel mehr aussagen als ein lockerer Zusammenhang zwischen einem Kurs und einem Indikator des Krankenhauses. Die Stufe sagt, was gemessen wurde; die Qualität des Designs sagt, wie sehr man dem Ergebnis trauen kann. Wer Artikel zur medizinischen Ausbildung liest, sollte beides getrennt betrachten, bevor er Schlüsse zieht, und wer schreibt, sollte das Design mit derselben Sorgfalt beschreiben, mit der er die erreichte Stufe beschreibt.
Alternativen und Ergänzungen
Die Antwort auf die Kritik kam aus zwei Richtungen: das Kirkpatrick-Modell selbst zu aktualisieren und es mit anderen Modellen zu verbinden, die Prozess und Kontext betrachten.
New World Kirkpatrick
Die als New World Kirkpatrick bezeichnete Version kehrt die Planungsreihenfolge um: Sie beginnt bei den gewünschten Ergebnissen und geht bis zur Reaktion zurück. Sie ergänzt außerdem Elemente wie die erwarteten kritischen Verhaltensweisen, die Faktoren, die die Veränderung fördern oder behindern, und die Zwischenindikatoren. Moreau beschreibt, wie diese Version versucht, auf drei zentrale Kritikpunkte am ursprünglichen Modell zu antworten, und lädt medizinische Lehrende ein, sie in komplexen Programmen zu erproben.
Logisches Modell und CIPP
Das logische Modell zeichnet die Kette, die Ressourcen, Aktivitäten, Produkte und Ergebnisse verbindet, und zwingt das Team, ausdrücklich zu begründen, warum es glaubt, dass das Programm funktionieren wird. Das CIPP-Modell bewertet Kontext, Inputs, Prozess und Produkt und ist nützlich, wenn das Programm noch angepasst wird. Der Leitfaden von Frye und Hemmer stellt diese Modelle und die Theorien hinter jedem von ihnen vor, von der reduktionistischen Sicht bis zur Komplexitätstheorie.
Wann man welches nutzt
- Kirkpatrick: um Ergebnisse standardisiert zu kommunizieren und mit der Literatur zu vergleichen.
- New World Kirkpatrick: um ein Programm vom gewünschten Ergebnis her zu planen und Zwischenindikatoren zu verfolgen.
- Logisches Modell: um die Theorie des Programms offenzulegen und schwache Glieder vor dem Start zu finden.
- CIPP: für neue oder in Anpassung befindliche Programme, wenn Prozess und Kontext ebenso wichtig sind wie das Ergebnis.
- Experimentelle Designs: wenn die Frage nach dem Effekt geht und die Bedingungen für eine Vergleichsgruppe gegeben sind.

Wie man die Evaluation eines Programms gestaltet
Eine wirksame Evaluation wird gemeinsam mit dem Programm geplant und nicht danach. Der folgende Leitfaden eignet sich für ein Modul im Studium, eine Aktivität einer akademischen Vereinigung oder ein Weiterbildungsprogramm.
- Beginne am Ende. Definiere das Ergebnis, das den Aufwand rechtfertigen würde: ein Verhalten, das du im Praktischen Jahr sehen willst, oder einen Indikator der Einrichtung.
- Lege die Theorie des Programms offen. Schreibe auf, warum du glaubst, dass die Aktivitäten zu diesem Ergebnis führen, und welche Bedingungen dafür gegeben sein müssen.
- Wähle einen Indikator pro Ebene. Einen kurzen Reaktionsfragebogen, ein Lernmaß mit verlässlichem Instrument und eine realistische Form der Verhaltensbeobachtung.
- Plane die Ausgangsmessung. Miss vor dem Start oder vereinbare eine Vergleichsgruppe.
- Achte auf ungeplante Effekte. Frage die Teilnehmenden, was sich verändert hat, das du nicht erwartet hast, zum Guten wie zum Schlechten.
- Nutze die Daten zur Anpassung. Die Evaluation dient dazu, das Programm zu verbessern, nicht nur, seine Existenz zu rechtfertigen.
Beispiel: ein Modul zum klinischen Denken
Stell dir ein achtwöchiges Modul mit wöchentlichen klinischen Fällen für das vierte Jahr vor. Auf Ebene eins ein Fragebogen mit fünf Fragen am Ende. Auf Ebene zwei eine Prüfung mit schriftlichen Fällen vor und nach dem Modul, korrigiert nach einem festgelegten Bewertungsschlüssel. Auf Ebene drei die Durchsicht einer Stichprobe schriftlicher Verlaufsdokumentationen im Praktischen Jahr, auf der Suche nach dokumentierten Differenzialdiagnosen. Auf Ebene vier ist die Messung eines Patientenergebnisses vielleicht nicht realistisch, und es ist in Ordnung, das klar zu sagen. Der Leitfaden zu fallbasiertem Lernen hilft bei der Gestaltung des Moduls, und der Text zu Feedback in klinischen Fällen zeigt, wie man den Studierenden Ergebnisse zurückmeldet.
Häufige Fehler
Nur die Zufriedenheit messen und das Evaluation nennen. Eine hastig erstellte Prüfung verwenden, ohne zu wissen, ob sie das misst, was man messen will. Eine Verhaltensänderung nach zwei Wochen erwarten. Dem Programm eine Verbesserung zuschreiben, die aus einer anderen Veränderung in der Einrichtung kam. Und, vielleicht am häufigsten, erst nach dem Ende des Programms entscheiden, was gemessen werden soll. Um zu verstehen, wie man das Gelernte erhält, ergänzt der Leitfaden zur Behaltensleistung medizinischen Wissens die Diskussion, und der Text zu aktivem Lernen hilft bei der Wahl von Aktivitäten, die Lernen begünstigen.
Kirkpatrick im Alltag der Lehrenden
Das Modell taucht oft in Artikeln und institutionellen Berichten auf, ist aber auch in kleinerem Maßstab nützlich: eine akademische Vereinigung, ein Praktikum, eine wöchentliche Fallbesprechung. In diesen Situationen wird niemand eine kontrollierte Studie aufsetzen, und das ist auch nicht nötig. Es genügt, die Ebenen als Erinnerung an die Fragen zu nutzen, die sich lohnen.
In der akademischen Vereinigung
Vereinigungen organisieren Kurse, Symposien und praktische Trainings mit viel Energie und wenig Zeit für die Evaluation. Ein realistischer Weg ist, eine Reaktionsfrage am Ende jeder Sitzung mit einem kleinen Lernmaß pro Semester zu verbinden, etwa drei kurze Fälle, die vor und nach einem Kurszyklus gelöst werden. Trainiert die Vereinigung eine Fertigkeit, etwa eine Abfolge der Versorgung, lohnt es sich, einige Mitglieder in einer Simulation zu beobachten und festzuhalten, was sich verändert hat. Damit liegt die Vereinigung bereits über den meisten veröffentlichten Evaluationen, die bei der Zufriedenheit stehen bleiben.
Im Praktikum und im Praktischen Jahr
Die betreuende Person hat privilegierten Zugang zu Ebene drei: Sie sieht die Studierenden in der Einrichtung. Eine einfache Möglichkeit, das zu nutzen, ist, zu Beginn des Praktikums zwei oder drei Verhaltensweisen festzulegen, die man am Ende sehen will, etwa den Fall mit Differenzialdiagnose vorzustellen oder ausstehende Befunde vor der Übergabe zu prüfen. Im Laufe der Wochen notiert die betreuende Person, ob diese Verhaltensweisen auftreten. Die Aufzeichnung dient dem Feedback an die Studierenden und, zusammen mit der anderer Betreuender, der Bewertung des Praktikums selbst.
In der Weiterbildung
Residenzprogramme sammeln bereits viele Daten: Leistungsbewertungen, Eingriffsprotokolle, Kennzahlen des Dienstes. Die Herausforderung besteht darin, diese Daten mit konkreten Änderungen des Programms zu verknüpfen. Wenn die Residenz eine neue Aktivität einführt, etwa eine wöchentliche Sitzung zum klinischen Denken, lohnt es sich, im Voraus eine Verhaltenskennzahl auszuwählen, die bereits erfasst wird, und den Trend vorher und nachher zu verfolgen, wobei man stets bedenkt, dass gleichzeitig andere Änderungen stattfinden.
Mit den Lernenden über Ergebnisse sprechen
Ein Programm zu bewerten ist auch eine Gelegenheit zu lehren. Der Gruppe zu zeigen, was gemessen wurde, was sich verbessert hat und was nicht, lehrt in der Praxis, wie man eine Bildungs-Evidenz liest. Und es schafft Raum dafür, dass die Lernenden selbst Änderungen vorschlagen, was das Programm meist schneller verbessert als jeder Fragebogen.
Wie NEXO in die Bewertung eines Programms einfließt
NEXO kann als Übungsaktivität innerhalb eines Programms zum klinischen Denken dienen. Der Fall des Tages kommt in bis zu sechs Hinweisen, und bei jeder Hypothese zeigt die Nähe in der ICD-10 auf fünf Stufen, wie weit die Hypothese von der Diagnose entfernt blieb. Die Fälle sind fiktiv mit realer klinischer Darstellung. Für diejenigen, die die Bewertung gestalten, ist die Frage dieselbe wie bei jeder Aktivität: Auf welcher Stufe erwarten Sie eine Wirkung, und wie werden Sie sie messen?
Der Leitfaden Was ist NEXO erklärt das ganze Spiel, und der Text über Gamification in der medizinischen Ausbildung fasst zusammen, was die Evidenz über Spiele im Unterricht zeigt. Wie die Modi freigeschaltet werden, steht auf der Seite zur Wirtschaft von NEXO.
Wenn Sie eine Hochschule, eine Liga oder eine Residenz koordinieren und NEXO mit einer Gruppe nutzen möchten, lernen Sie NEXO Closer kennen. Forschende in der medizinischen Ausbildung, die Evaluationsstudien planen möchten, können Projekte über NEXO Researcher vorschlagen. Ärztinnen und Ärzte, die Fälle prüfen, beteiligen sich über NEXO Curator, und wer Gesundheitsinhalte in den sozialen Netzwerken erstellt, kann über NEXO Creators mitmachen.
Häufige Fragen
Was sind die vier Stufen des Kirkpatrick-Modells?
Reaktion, Lernen, Verhalten und Ergebnisse. Jede Stufe beantwortet eine Frage: ob den Teilnehmenden gefallen hat, ob sie gelernt haben, ob sie ihre Praxis geändert haben und ob es einen Nutzen für Patientinnen und Patienten oder für die Einrichtung gab.
Muss ich in jedem Programm alle vier Stufen messen?
Nein. Wählen Sie die Stufen, die für das Ziel und die verfügbaren Mittel sinnvoll sind, und sagen Sie klar, was nicht gemessen wurde. Ein kurzes Programm lässt sich auf den Stufen eins und zwei gut bewerten.
Bedeutet hohe Zufriedenheit, dass der Kurs funktioniert hat?
Nicht unbedingt. Die Zufriedenheit zeigt, dass die Erfahrung gut aufgenommen wurde, garantiert aber weder Lernen noch eine Änderung der Praxis.
Was ist die wichtigste Kritik am Modell?
Die Annahme, dass die Stufen eine Kausalkette bilden, und der Fokus auf Ergebnisse, ohne den Kontext und die nicht geplanten Wirkungen zu betrachten. Deshalb funktioniert das Modell besser in Kombination mit Ansätzen der Programmbewertung.
Was ist das New World Kirkpatrick?
Eine Aktualisierung, die die Planung bei den gewünschten Ergebnissen beginnt und kritische Verhaltensweisen, verstärkende Faktoren und Zwischenindikatoren ergänzt.
Welches Modell sollte man statt Kirkpatrick verwenden?
Das hängt von der Frage ab. Das logische Modell und das CIPP-Modell helfen zu verstehen, wie und warum ein Programm funktioniert; experimentelle Designs beantworten Wirkungsfragen besser. Viele Programme kombinieren mehr als eines.
Checkliste für die Bewertung eines Programms
- Legen Sie das Ergebnis fest, das das Programm rechtfertigen würde, bevor Sie die Aktivitäten planen.
- Schreiben Sie die Programmtheorie auf: warum die Aktivitäten zum Ergebnis führen würden.
- Wählen Sie für jede Stufe, die Sie messen, einen realistischen Indikator.
- Verwenden Sie Instrumente mit Evidenz für ihre Validität, um Lernen zu messen.
- Messen Sie die Ausgangslage oder ziehen Sie eine Vergleichsgruppe heran.
- Fragen Sie nach nicht geplanten Wirkungen.
- Berichten Sie klar, was nicht gemessen wurde.
- Nutzen Sie die Ergebnisse, um das Programm für die nächste Gruppe anzupassen.
Möchten Sie eine tägliche Aktivität zum klinischen Denken für Ihre Gruppe? Spielen Sie den Fall des Tages in NEXO.
Literatur
- Yardley S, Dornan T. Kirkpatrick's levels and education 'evidence'. Med Educ. 2012. PubMed 22150201
- Allen LM, Hay M, Palermo C. Evaluation in health professions education-Is measuring outcomes enough?. Med Educ. 2022. PubMed 34463357
- Moreau KA. Has the new Kirkpatrick generation built a better hammer for our evaluation toolbox?. Med Teach. 2017. PubMed 28649887
- Curran VR, Fleet L. A review of evaluation outcomes of web-based continuing medical education. Med Educ. 2005. PubMed 15910431
- Turkeshi E, Michels NR, Hendrickx K, Remmen R. Impact of family medicine clerkships in undergraduate medical education: a systematic review. BMJ Open. 2015. PubMed 26243553
- Phillips JL, Heneka N, Bhattarai P, Fraser C, Shaw T. Effectiveness of the spaced education pedagogy for clinicians' continuing professional development: a systematic review. Med Educ. 2019. PubMed 31144348
- Moreau KA, Eady K, Sikora L, Horsley T. Digital storytelling in health professions education: a systematic review. BMC Med Educ. 2018. PubMed 30200945
- Frye AW, Hemmer PA. Program evaluation models and related theories: AMEE guide no. 67. Med Teach. 2012. PubMed 22515309
- Belfield C, Thomas H, Bullock A, Eynon R, Wall D. Measuring effectiveness for best evidence medical education: a discussion. Med Teach. 2001. PubMed 11371293
- Cook DA, Hatala R, Brydges R, Zendejas B, Szostek JH, Wang AT, et al. Technology-enhanced simulation for health professions education: a systematic review and meta-analysis. JAMA. 2011. PubMed 21900138
- Brydges R, Hatala R, Zendejas B, Erwin PJ, Cook DA. Linking simulation-based educational assessments and patient-related outcomes: a systematic review and meta-analysis. Acad Med. 2015. PubMed 25374041
- Ilgen JS, Ma IW, Hatala R, Cook DA. A systematic review of validity evidence for checklists versus global rating scales in simulation-based assessment. Med Educ. 2015. PubMed 25626747